Vivimos un momento extraordinario. La capacidad de generar y almacenar datos ha alcanzado proporciones vertiginosas. Lo que encierran esos datos representa la oportunidad de que esta generación resuelva sus problemas más urgentes, desde las enfermedades y el cambio climático hasta la atención sanitaria y la comprensión del cliente.
La magnitud de la oportunidad viene definida por la magnitud de los datos que se generan, y es asombrosa.
La población mundial de internet creció más de un 750 % en los últimos 15 años, hasta superar los 3 000 millones, y pronto superará la marca del 50 % de penetración. Esta población comparte más de 2,5 millones de contenidos en Facebook, tuitea más de 300 000 veces y envía más de 204 millones de mensajes de texto, todo ello en un solo minuto.
Además, la aceleración del crecimiento de los datos se intensificará de forma notable en los próximos años, a medida que se consolide el Internet de las cosas, que conectará entre 20 000 y 30 000 millones de “cosas” para 2020. Estas “cosas” transmitirán datos sobre todo, desde su automóvil hasta su termostato y la salud de su rebaño de ganado.
Esta explosión se sustenta en avances extraordinarios en la tecnología y la arquitectura de almacenamiento de datos. Los precios de los equipos de almacenamiento de datos, ajustados por calidad, cayeron a un ritmo medio anual de casi el 30 % entre 2002 y 2014. Con un coste incremental de almacenamiento efectivamente igual a cero, las instituciones han respondido capturando todo lo posible, con la idea de que lo que contienen generará un valor significativo para la empresa.
A pesar de los avances técnicos en la recopilación y el almacenamiento, la generación de conocimiento va a la zaga. Esto depende de cómo las organizaciones abordan sus datos, de cómo llevan a cabo los análisis y de cómo automatizan el aprendizaje mediante la inteligencia artificial.
En esencia, es un problema matemático. Para cualquier conjunto de datos, el número total de hipótesis o consultas posibles es exponencial respecto al tamaño de los datos. Las funciones exponenciales ya son bastante difíciles de comprender para los seres humanos; sin embargo, para complicar aún más las cosas, el tamaño de los propios datos crece de forma exponencial y está a punto de alcanzar otro punto de inflexión, a medida que el Internet de las cosas empiece a cobrar protagonismo.

Esto significa que nos enfrentamos a un crecimiento doblemente exponencial en el número de preguntas que podemos plantear a nuestros datos. Si optamos por los mismos enfoques que nos han servido a lo largo del tiempo, es decir, formular preguntas a los datos de forma iterativa hasta obtener la respuesta correcta, habremos desaprovechado nuestra oportunidad generacional.
Nunca ha habido ni habrá suficientes científicos de datos en el mundo para tener éxito con este enfoque. No podemos dotar de nuevos programas informáticos a suficientes científicos de datos ciudadanos para tener éxito con este enfoque. Los programas que hacen más accesible o más eficiente la formulación de preguntas o el desarrollo de hipótesis pasan por alto la premisa central: solo se quedarán cada vez más atrás a medida que cada milisegundo estén disponibles nuevos datos.
Para desbloquear de verdad el valor que encierran nuestros datos, debemos centrar nuestra atención en los datos y dejar las preguntas para más adelante. Esto también resulta ser un problema matemático. Resulta que los datos tienen forma, y esa forma tiene significado. La forma de los datos indica todo lo que se necesita saber sobre ellos, desde sus rasgos más evidentes hasta sus secretos más ocultos.
Comprendemos que la regresión produce líneas.

Sabemos que la segmentación de clientes produce grupos.

Sabemos que el crecimiento económico y los tipos de interés tienen una naturaleza cíclica (enfermedades como la malaria también tienen esta forma).

Al conocer la forma y saber en qué punto de ella nos encontramos, mejoramos enormemente nuestra comprensión de dónde estamos, de dónde hemos estado y, quizá lo más importante, de lo que podría ocurrir después. Al comprender la forma de los datos, entendemos cada rasgo del conjunto de datos, percibimos de inmediato qué es importante en ellos y, en consecuencia, reducimos drásticamente el número de preguntas que hay que formular y aceleramos el proceso de descubrimiento.
Al cambiar nuestra forma de pensar y partir de la forma de los datos, y no de una serie de preguntas (que con mucha frecuencia conllevan sesgos significativos), podemos extraer conocimiento de estos conjuntos de datos, que crecen rápidamente y son masivos y complejos.
El conocimiento oculto en los historiales médicos electrónicos, los registros de facturación y los registros clínicos es suficiente para transformar la forma en que prestamos la atención sanitaria y tratamos las enfermedades. El conocimiento que encierran los enormes almacenes de datos de gobiernos, universidades y otras instituciones iluminará el debate sobre el cambio climático e indicará el camino hacia las respuestas sobre lo que debemos hacer para proteger el planeta para las generaciones futuras. El conocimiento que queda oculto en los datos web, transaccionales, de CRM, de redes sociales y de otro tipo permitirá construir una imagen más clara y significativa del cliente y, a su vez, definirá la forma óptima de interactuar con él.
Esta es la oportunidad de nuestra generación para convertir los datos en conocimiento. Para lograrlo se requerirá un enfoque distinto, pero con capacidad para repercutir en toda la humanidad.
Encontrará todos los detalles de los Technology Pioneers 2015 en este enlace.
Autor: Gurjeet Singh es cofundador y director ejecutivo de Ayasdi, una Technology Pioneer del Foro Económico Mundial.
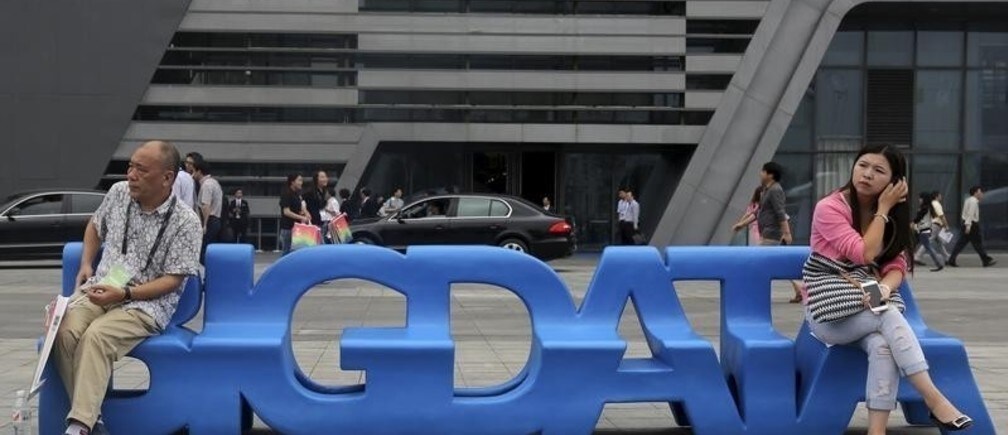
Imagen: Visitantes se sientan en un banco con forma de “Big Data” frente a la sede de la Big Data Expo 2015 en Guiyang, provincia de Guizhou, China, 26 de mayo de 2015. REUTERS/Paul Carsten