Las nuevas tecnologías permiten recopilar datos sobre el coronavirus casi en tiempo real.
La rápida generación de datos aumenta los riesgos para su exactitud y fiabilidad.
Los responsables de la toma de decisiones mantendrán la confianza si adaptan las políticas a medida que surgen nuevos datos.
En la memoria viva, el mundo no había conocido una pandemia de la escala de la que estamos viviendo con la COVID-19. Tampoco había tenido acceso a datos y análisis sobre el propio virus SARS-CoV-2, muchos de ellos generados rápidamente y difundidos libremente. Para encontrar una salida a esta crisis será necesario integrar estos datos de forma eficaz en la toma de decisiones.
Esta no es una tarea fácil ni siquiera en las mejores circunstancias. Ahora es aún más difícil porque el virus que causa la pandemia, el SARS-CoV-2, es nuevo para los seres humanos y cruzó la barrera entre especies desde los murciélagos. Hace apenas cuatro meses, no podíamos responder ni siquiera las preguntas más básicas sobre el virus y la enfermedad que causa: ¿qué tan transmisible es?, ¿qué tan virulenta (perjudicial) es la enfermedad para nuestro organismo?, ¿podemos generar una respuesta inmunitaria eficaz? Estamos aprendiendo sobre la marcha.
Ya hemos pasado por esto, más recientemente con los coronavirus que causaron el síndrome respiratorio de Oriente Medio (MERS) en 2012 y, antes, el SARS en 2002. Entonces sabíamos tan poco sobre estas enfermedades como sabemos ahora cuando se observaron por primera vez en seres humanos. La diferencia entre entonces y ahora está en la rapidez con que aprendemos la biología básica del virus y de la enfermedad que causa, y en cómo afrontamos las incertidumbres durante el proceso.
Las nuevas tecnologías para generar y difundir datos rápidamente permiten recopilar y analizar información sobre el virus casi en tiempo real. Nunca antes habíamos visto generar y compartir tantos datos con tanta rapidez, a veces a costa de una incertidumbre mayor de la que quisiéramos. Pero la velocidad y la escala con que este virus se propaga y evoluciona hacen que nunca antes tantas personas hayan necesitado estos datos con tanta urgencia.
Pensemos en el comienzo de la pandemia en enero, cuando el virus empezó a propagarse desde su lugar de origen, Wuhan, China, por todo el mundo. Sin una vacuna disponible, la única herramienta de intervención en salud pública es la contención, y para aplicarla eficazmente hay que saber dónde está el virus y con qué rapidez se transmite de una persona a otra. El diagnóstico rápido y las pruebas generalizadas para detectar casos y rastrear sus contactos a escala regional son fundamentales, como demuestra el éxito de los primeros programas en lugares como Taiwán, Singapur y Corea del Sur lo demuestran.
Un retraso, aunque sea de apenas unos días, puede ser desastroso, como Italia fue la primera en comprobar. De cara al futuro, las nuevas herramientas de diagnóstico en el punto de atención, capaces de producir un resultado en menos de una hora serán indispensables para ampliar y acelerar las pruebas.
Acertar con las cifras es un verdadero reto. Por ahora, las mejores estimaciones indican que cada caso de SARS-CoV-2 infecta, en promedio, a otras 2,5 personas. Sin embargo, la incertidumbre en torno a la dinámica de transmisión de la enfermedad implica que esta cifra puede variar sustancialmente y, con ella, el número total de muertes previsto. Las predicciones de los modelos epidemiológicos solo son tan buenas como los datos que introducimos en ellos. Los responsables de políticas deben estar dispuestos a convivir con la incertidumbre de las predicciones y ajustar sus recomendaciones en consecuencia.
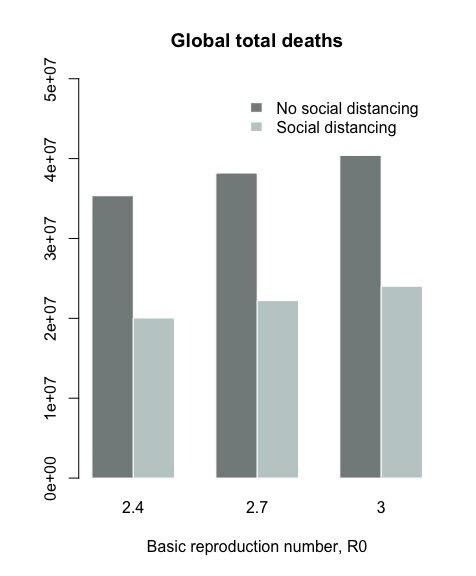
El objetivo de medidas de salud pública como lavarse las manos, mantener la distancia física y la cuarentena es reducir todo lo posible el promedio de nuevas infecciones e, idealmente, situarlo por debajo de 1. En ese nivel, el virus estará contenido. De hecho, esta es la perspectiva desde la que deben tomarse todas las decisiones ahora mismo, en pleno apogeo de la pandemia. Más adelante mismo, habrá que tomar decisiones difíciles, sopesando la salud pública frente a los efectos en la economía, la libertad personal y la confianza ciudadana.
Este panorama, que cambia rápidamente, plantea un desafío adicional a quienes toman decisiones. Lo que parece cierto un día deja de serlo al siguiente, a medida que salen a la luz nuevas pruebas. Las estimaciones iniciales de la tasa de mortalidad por COVID-19 son un ejemplo. En enero se informó por primera vez que la tasa de letalidad (CFR, por sus siglas en inglés; el número de infecciones confirmadas que terminan en muerte) podía llegar al 15 %, pero la obtención de información más abundante y de mejor calidad ha permitido revisar esta cifra de forma constante hasta ~1 %. Los responsables de la toma de decisiones deben estar preparados para revisar sus recomendaciones a la luz de la nueva información y explicar esos cambios a la ciudadanía de forma abierta y honesta.
La enorme velocidad a la que se generan datos ofrece una oportunidad única. Veamos como ejemplo el crecimiento de los datos genómicos. La secuencia de la cepa original de Wuhan se cargó a mediados de diciembre de 2019. A la fecha de este artículo, hay algo menos de 4.000 cepas de SARS-CoV-2 disponibles para su análisis. El ritmo de crecimiento de los datos es, sencillamente, asombroso. El virus evoluciona con rapidez y acumula mutaciones a un ritmo aproximado de una cada dos semanas. Los repositorios públicos, como GISAID.org; y las plataformas de análisis, como nextstrain.org, permiten seguir casi en tiempo real la evolución y propagación del virus.
Este contexto de generación rápida de datos y amplia difusión conlleva riesgos adicionales para su exactitud y fiabilidad. El proceso de evaluación de resultados, normalmente lento y deliberativo, se ha acelerado, lo que aumenta la posibilidad de que se cometan errores. Los riesgos se atenúan en cierta medida gracias a un proceso de revisión por pares más informal y abierto que tiene lugar en foros en línea vinculados a servidores de prepublicaciones (que reúnen trabajos académicos antes de su revisión formal por pares y publicación), como medRxiv, bioRxiv y virological.org, e incluso en Twitter.
También ayuda que varios grupos trabajen en el mismo problema. Si todos llegan a la misma respuesta de forma independiente y con enfoques ligeramente distintos, podemos tener bastante confianza en que el resultado es sólido. A los responsables de políticas les convendría recordar el consejo del fallecido biólogo Richard Levins sobre el uso de los modelos matemáticos: nuestra verdad es la intersección de mentiras independientes. Lo mismo ocurre al orientarse entre la abundante literatura científica.
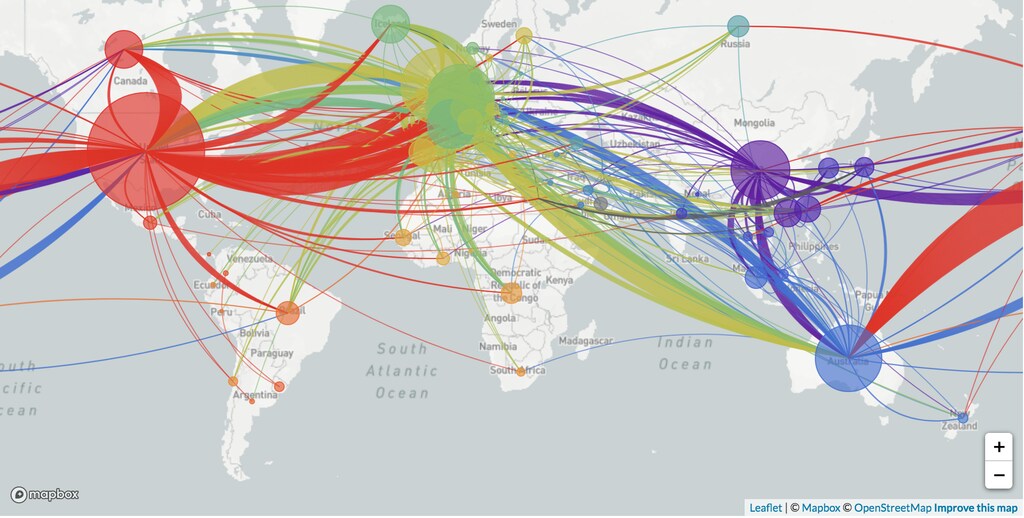
El SARS-CoV-2 cruzó la barrera entre especies y llegó a los seres humanos; ahora galopa de un país a otro por la intrincada red de conexiones globales que hemos tejido. Es un problema creado por nosotros mismos. Por fortuna, ahora contamos con herramientas más eficaces para controlarlo. Las nuevas herramientas de recopilación y análisis rápidos de datos facilitan que quienes toman decisiones reciban las pruebas adecuadas.
Esto no basta. Sería útil contar con un foro estratégico que establezca un enfoque global armonizado, así como incorporar epidemiólogos a los equipos de políticas públicas, donde tradicionalmente no han estado presentes, por ejemplo, en los departamentos de planificación urbana de las ciudades. Sobre todo, quienes toman decisiones deben mantener la confianza ciudadana. Para ello, hay que escuchar a la ciencia, adaptar las políticas a medida que surgen nuevos datos y explicar claramente los cambios a la ciudadanía.



