El progreso digital no ha dado necesariamente lugar a la equidad digital.
La gobernanza futura de los datos debe ir más allá de las cuestiones de propiedad y control.
Debe abordar el equilibrio de poder entre el individuo y la institución.
Los datos se han convertido en la moneda más valiosa del mundo. Se generan a una escala y un ritmo sin precedentes. En tan solo un día, se publican aproximadamente 500 millones de tuits se publican. Se envían unos 294 000 millones de correos electrónicos. Se realizan cinco mil millones de búsquedas. Cada día producimos 2,5 trillones de bytes de información.
El poder de los datos es inmenso, pero las consecuencias de entregar nuestros datos, de forma voluntaria o involuntaria (ya sea para nuestra privacidad, seguridad o la sociedad en general), plantean una serie de desafíos a nuestros derechos humanos fundamentales que habrían sido impensables hace una década.
Las cuestiones relacionadas con los datos y su impacto en los derechos humanos todavía son nuevas en el discurso público. Algunas de las preguntas más profundas no son evidentes de inmediato. Con esto en mente, estas son cuatro preguntas cruciales a las que debemos responder.
¿Quién es realmente “propietario” de nuestros datos?
Gracias a la reacción que siguió al escándalo de Cambridge Analytica, la cuestión de la propiedad de los datos resulta familiar. La creciente preocupación pública por el uso, el uso indebido o la mala gestión de los datos personales ha dado lugar a normativas como el RGPD en la UE.
Pero la propiedad de los datos va más allá de la relación binaria entre “tú” y “tus datos”. A diferencia de otros bienes, los datos pueden pertenecer a varias personas al mismo tiempo. Puedes cederlos y seguir teniéndolos tú. Además, pueden referirse a ti, pero también a otras personas. Los regalos que acabas de comprar en línea para tus amigos y familiares significan que ahora has compartido información sobre quiénes son, qué les gusta y dónde viven.
Luego está la complicada cuestión de cómo se generan estos datos. La relación entre los datos que aportas de forma activa o pasiva es clara. Pero en el futuro, ¿podrían considerarse datos personales los datos generados por máquinas sobre ti? ¿Quién los poseería?
Por último, ¿qué ocurre cuando tus datos forman parte de un conjunto de datos, recopilado por una institución como el NHS? ¿Los datos te pertenecen a ti, al grupo, a quienes los recogen y pueden aumentar su valor?
La respuesta definitiva es que la cuestión de la propiedad de los datos quizá no sea la correcta que plantear.
¿El consentimiento implica control?
Has consentido el uso de cookies o compartir información en Facebook, tranquilizado por los términos y condiciones de que tú eres propietario de todo el contenido e información que publicas, pero controlar cuándo compartes información personal no significa necesariamente controlar cómo se utiliza después.
Tus datos, combinados con otros datos, se utilizan para alimentar algoritmos, que luego hacen suposiciones sobre ti, ya sea sobre tu salario, tu salud o tu idoneidad para un puesto de trabajo. El poder ha pasado del consumidor a la empresa.
Tomemos como ejemplo la empresa china Ping-An, la aseguradora más grande del mundo, que capta a sus clientes mediante reconocimiento facial. El software que utiliza puede calcular el porcentaje de grasa corporal de una persona, lo que determina su prima. Esto puede resultar útil para la empresa, pero ¿qué significa para el consumidor?
Quizá el concepto de “privacidad” se está quedando obsoleto con rapidez
No cabe duda de que las suposiciones que los algoritmos hacen sobre nosotros pueden ser útiles, pero podrían ser imprecisas o estar ponderadas de manera injusta. Tomemos, por ejemplo, lo que ocurre en Estados Unidos, donde en determinadas jurisdicciones, los algoritmos de evaluación de riesgos se utilizan no solo para predecir dónde puede producirse un delito violento, sino también si los delincuentes podrían reincidir, algo que utilizan los jueces para determinar las condenas. En este caso, los individuos no solo son juzgados por sus propios datos, sino también en función de su similitud con otros.
Esto está relacionado con la cuestión de la transparencia en cuanto a la optimización de los algoritmos. Por ejemplo, los reguladores estadounidenses están investigando actualmente si la nueva tarjeta de crédito de Apple es sesgada contra las mujeres tras una queja de que a un usuario se le ofreció un límite de gasto 20 veces superior al de su esposa, que en realidad tenía una mejor puntuación crediticia. Cuando se cuestionó esto, la respuesta fue culpar al algoritmo sin explicar la discrepancia. El “consentimiento” aquí carece de sentido y, desde luego, no conduce al “control”.
¿Qué pasa con nuestros derechos de privacidad?
Si el concepto de “consentimiento” es defectuoso, también lo es el argumento sobre la privacidad. Puede que no tengas ningún deseo de compartir fotos de una fiesta a la que fuiste anoche, pero ¿qué ocurre cuando otros asistentes comparten sus fotos en redes sociales y apareces en ellas? Tu decisión de excluirte no controla los datos que se comparten sobre ti.
El único control real que podrías ejercer sería mantener tus datos totalmente privados. Pero excluirse puede implicar perderse cosas y, en la práctica, es prácticamente imposible de llevar a cabo. Además, la falta de datos no impedirá que se hagan suposiciones sobre ti, ya sea por parte de empresas, gobiernos o instituciones que recopilan grandes cantidades de datos sobre otras personas.
No podemos simplemente extrapolar del marco de los derechos humanos el derecho a la privacidad y luego tratar de aplicarlo al ámbito digital. Nos afectan tanto los datos sobre otras personas como los nuestros. Así que quizá el concepto de “privacidad” también se esté quedando obsoleto con rapidez.
¿Podemos recibir una compensación por nuestros datos?
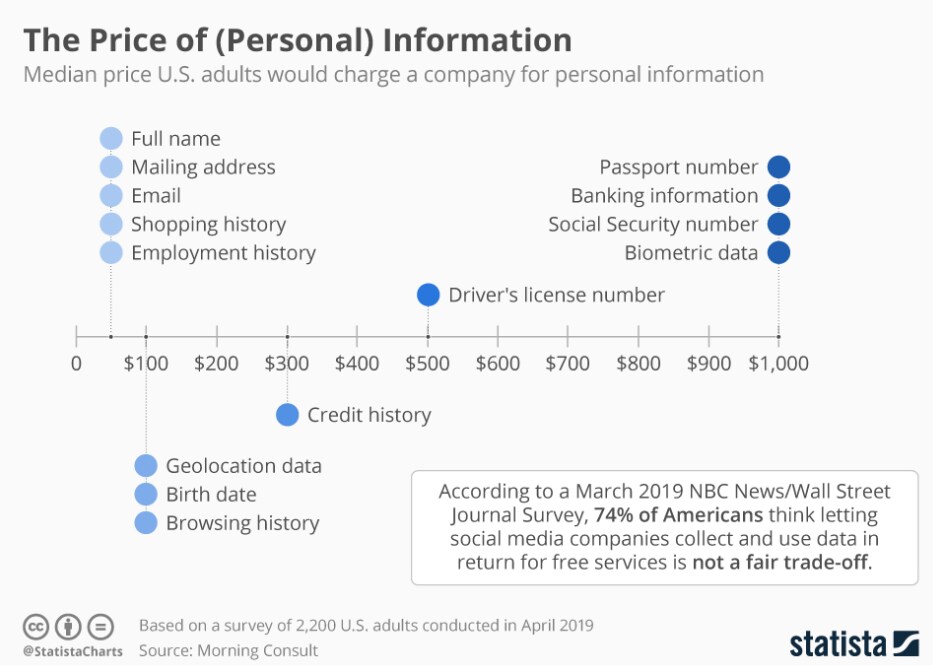
¿Cómo podemos garantizar un resultado más equitativo de la economía de datos actual, en la que las personas no se benefician del intercambio de sus propios datos? Esto se vuelve aún más complejo cuando entendemos que los datos individualizados no son tan valiosos como los datos colectivos. Los conjuntos de datos sanitarios, por ejemplo, tienen un enorme valor social y económico. Pero ¿cómo se compensa a las personas que los generaron?
Hay argumentos que sugieren que los datos deberían tratarse como trabajo, en el que las personas participan activamente al ceder sus datos de forma transparente y son recompensadas colectivamente por sus aportaciones a través de “sindicatos” o “fideicomisos” de datos. Esto no solo garantizaría que se utilicen datos de mejor calidad para alimentar los sistemas digitales, sino también un sistema económico más justo, que reduciría la enorme brecha entre las grandes empresas tecnológicas y los proveedores de datos individuales.
Cada vez hay más llamamientos también a la regulación, como la creación de una Carta de Derechos de los Datos, que protegería, por ejemplo, los datos utilizados para una vigilancia no razonable o para una discriminación injusta.
En conjunto, el progreso digital no ha dado necesariamente lugar a la equidad digital y, aunque no cabe duda de que la revolución tecnológica ha dotado a la sociedad civil de comunicación, conexión e información libres, también se ha convertido en un medio de desinformación, vigilancia y control.
La gobernanza futura de los datos debe ir más allá de las cuestiones de propiedad y control. Debe reconocer los enormes beneficios colectivos para la sociedad en la recopilación de datos, así como distinguir entre datos individuales y grandes conjuntos de datos, equilibrando al mismo tiempo los intereses del individuo y de la sociedad. Sobre todo, debe abordar el equilibrio de poder entre el individuo y la institución.




