Una nueva investigación arroja luz sobre por qué a las computadoras se les da tan mal una clase de tareas que incluso los niños pequeños realizan sin problema: determinar si dos objetos de una imagen son iguales o diferentes.
«Hay mucho entusiasmo por lo que la visión artificial ha logrado…»
Los algoritmos de visión artificial han avanzado mucho en la última década. Han demostrado ser tan buenos como las personas, o incluso mejores, en tareas como clasificar razas de perros o gatos, y tienen la extraordinaria capacidad de identificar rostros específicos entre millones.
En un artículo que presentaron la semana pasada en la reunión anual de la Sociedad de Ciencias Cognitivas, el equipo examina por qué los algoritmos de visión artificial fallan en tareas de comparación y propone vías para crear sistemas más inteligentes.
Esto frente a aquello
«Hay mucho entusiasmo por lo que la visión artificial ha logrado, y comparto buena parte de ese entusiasmo», afirma Thomas Serre, profesor asociado de ciencias cognitivas, lingüísticas y psicológicas de la Universidad de Brown y autor principal del artículo. «Pero creemos que, al esforzarnos por entender las limitaciones de los sistemas actuales de visión artificial, como hemos hecho aquí, podemos avanzar hacia sistemas nuevos y mucho más avanzados, en lugar de limitarnos a retocar los que ya tenemos».
Incluso después de cientos de miles de ejemplos de entrenamiento, los algoritmos no superaban el azar al reconocer la relación correspondiente.
Para el estudio, Serre y sus colegas usaron algoritmos de visión artificial de última generación para analizar imágenes sencillas en blanco y negro que contenían dos o más formas generadas al azar. En algunos casos, los objetos eran idénticos; a veces eran iguales, pero uno estaba girado respecto del otro; y otras veces eran completamente distintos. Se pidió a la computadora que identificara si eran iguales o diferentes.
El estudio mostró que, incluso después de cientos de miles de ejemplos de entrenamiento, los algoritmos no superaban el azar al reconocer la relación correspondiente. La pregunta, entonces, era por qué estos sistemas se desempeñan tan mal en esta tarea.
Serre y sus colegas sospechaban que esto tenía que ver con la incapacidad de estos algoritmos de visión artificial para distinguir cada objeto por separado. Cuando las computadoras observan una imagen, en realidad no pueden determinar dónde termina un objeto y dónde comienza el fondo u otro objeto. Solo ven un conjunto de píxeles con patrones similares a los de otros conjuntos de píxeles que han aprendido a asociar con determinadas etiquetas.
Eso funciona bien para tareas de identificación o clasificación, pero falla cuando se intenta comparar dos objetos.
De uno en uno
Para demostrar que esa era, en efecto, la razón por la que los algoritmos fallaban, Serre y su equipo realizaron experimentos que eximían a la computadora de tener que distinguir los objetos por sí sola. En lugar de mostrarle dos objetos en una misma imagen, los investigadores se los mostraron de uno en uno, en imágenes separadas.
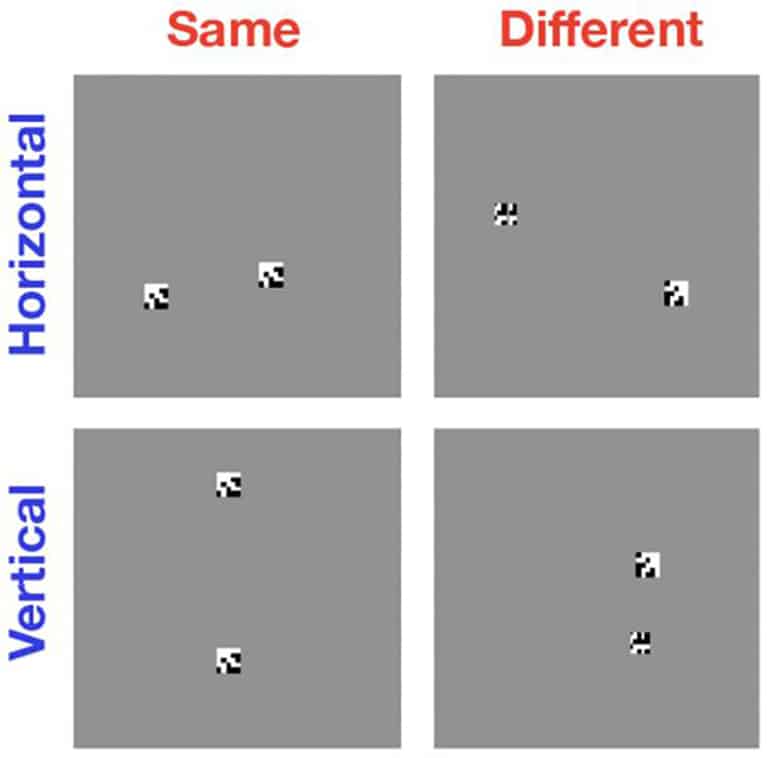
Los experimentos demostraron que los algoritmos aprendían sin problemas la relación de igualdad o diferencia, siempre que no tuvieran que ver los dos objetos en la misma imagen.
Según Serre, el origen del problema para distinguir cada objeto por separado está en la arquitectura de los sistemas de aprendizaje automático que hacen funcionar los algoritmos. Estos usan redes neuronales convolucionales, es decir, capas de unidades de procesamiento conectadas que imitan de forma aproximada las redes de neuronas del cerebro. Una diferencia clave respecto del cerebro es que las redes artificiales son exclusivamente de «propagación hacia adelante»: la información fluye en una sola dirección a través de las capas de la red. Según Serre, así no funciona el sistema visual humano.
«Si observamos la anatomía de nuestro propio sistema visual, encontramos muchas conexiones recurrentes, por las que la información va de un área visual superior a otra inferior y vuelve a pasar por ellas», afirma Serre.
Aunque no está claro qué hacen exactamente esas conexiones de retroalimentación, dice Serre, es probable que tengan algo que ver con nuestra capacidad para prestar atención a ciertas partes de nuestro campo visual y formar representaciones mentales de objetos.
«Cabe suponer que las personas prestan atención a un objeto y construyen una representación de sus características vinculada a ese objeto en la memoria de trabajo», afirma Serre. «Luego dirigen la atención a otro objeto. Cuando ambos están representados en la memoria de trabajo, el sistema visual puede compararlos y determinar si son iguales o diferentes».
Serre y sus colegas plantean la hipótesis de que las computadoras no pueden hacer algo parecido porque las redes neuronales de propagación hacia adelante no permiten el tipo de procesamiento recurrente necesario para distinguir cada objeto por separado y crear representaciones mentales de ellos. Según Serre, para hacer más inteligente la visión artificial quizá se necesiten redes neuronales que se aproximen más al carácter recurrente del procesamiento visual humano.
La investigación recibió financiación de la Fundación Nacional de Ciencias y de DARPA.




