Aprender a aprender
En 1959, Arthur Samuel, pionero en el campo del aprendizaje automático (ML), lo definió como el «campo de estudio que brinda a los ordenadores la capacidad de aprender sin ser programados explícitamente».
El ML puede entenderse como métodos computacionales que utilizan la experiencia para mejorar el rendimiento o hacer predicciones precisas. En este caso, la experiencia se refiere a información o datos anteriores de los que disponemos, que han sido etiquetados y categorizados. Como en cualquier ejercicio computacional, la calidad y la cantidad de los datos serán cruciales para la precisión de las predicciones que se realicen.
Desde esta perspectiva, el ML parece muy similar al modelado estadístico. En el modelado estadístico, recopilamos datos, verificamos que estén limpios —es decir, que hayamos completado, corregido o eliminado cualquier parte incompleta, incorrecta o irrelevante de los datos— y luego usamos este conjunto de datos depurado para poner a prueba hipótesis y hacer predicciones y pronósticos. La idea del modelado estadístico es intentar representar cuestiones complejas en términos relativamente generalizables, es decir, términos que expliquen la mayoría de los sucesos estudiados. En la práctica, programamos el algoritmo para que realice determinadas funciones según los datos que le proporcionamos. Dicho de otro modo, el algoritmo es estático. Necesita que un programador le indique qué hacer cuando se le proporcionan datos. Hasta aquí, tiene sentido utilizar este enfoque cuando lo activa el programador.
Pero con el ML, el procedimiento se invierte. En lugar de seleccionar un modelo de antemano e introducir datos en él, en el ML son los datos los que determinan qué técnica analítica conviene seleccionar para realizar mejor la tarea en cuestión. En otras palabras, el ordenador utiliza los datos de los que dispone para seleccionar y entrenar el algoritmo. Por tanto, el algoritmo deja de ser estático. Analiza los datos a los que se expone, determina cuál es la mejor forma de proceder y luego actúa. En esencia, «aprende» de los datos y, al hacerlo, permite extraer conocimiento de ellos.
Este método de aprendizaje se basa en la repetición. Recordemos que un algoritmo no es más que un conjunto de instrucciones que un ordenador utiliza para transformar una entrada en una salida determinada. Así, en el ML, el aspecto de aprendizaje consiste simplemente en que un algoritmo repite una y otra vez su operación de ejecución y realiza pequeños ajustes hasta que se cumple un conjunto determinado de condiciones. La prueba decisiva de un algoritmo de aprendizaje es que sea capaz de hacer predicciones cuando recibe datos nuevos con los que no se había entrenado previamente.
Evolución del ML
Es evidente que los datos desempeñan un papel fundamental en este proceso metodológico. Más importante aún, es la estructura de los datos la que determina cómo tendrá lugar el proceso de aprendizaje. Aquí es donde observamos los tres niveles del ML:
ML supervisado
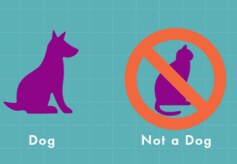
En este caso, el ordenador se entrena con datos correctamente etiquetados. Esto significa que los datos ya tienen asignada la etiqueta correcta o el resultado correcto. Por ejemplo, si quisiéramos enseñar a un ordenador a distinguir entre la imagen de un gato y la de un perro, etiquetaríamos los datos de la siguiente manera:
Este proceso de etiquetado debe realizarlo el programador y, una vez aprendida la diferencia, el algoritmo de ML ya puede clasificar la nueva información que recibe y determinar si la nueva imagen muestra un perro o un gato.
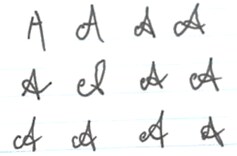
A partir de este método sencillo, el ML supervisado puede utilizarse para realizar operaciones mucho más complejas. Una aplicación consiste en aprender a leer cifras y letras. La forma en que una persona escribe el número «1» o la letra «A» no será igual a la de otra persona.
Muestras manuscritas del número 1. Ilustración proporcionada por el autor. Muestras manuscritas de la letra A. Ilustración proporcionada por el autor.
Al introducir en el ordenador grandes cantidades de ejemplos etiquetados del número «1» o de la letra «A», podemos entrenar el algoritmo para que reconozca las distintas versiones de estas figuras. Así, el ordenador empieza a aprender las variaciones y adquiere cada vez más capacidad para reconocer estos patrones.
Hoy en día, los ordenadores reconocen estos patrones de escritura a mano mejor que los seres humanos. Cuanto mayor sea el conjunto de datos, mejor entrenado estará el algoritmo. Una vez entrenado, se proporcionan nuevos datos al algoritmo y este utiliza su experiencia pasada para predecir un resultado.
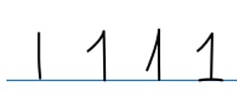
ML no supervisado
En este caso, el algoritmo se entrena con un conjunto de datos que no tiene etiquetas. No se le indica al algoritmo qué representan los datos. Aquí, el proceso de aprendizaje depende de identificar patrones que se repiten en los datos. Si usamos el ejemplo del gato y el perro, el algoritmo empieza a separar las imágenes que recibe según las características inherentes de los perros.
En el aprendizaje no supervisado, los algoritmos deben utilizar métodos de estimación basados en la estadística inferencial para descubrir patrones, relaciones y correlaciones en el conjunto de datos sin procesar y sin etiquetar. A medida que identifica patrones, el algoritmo utiliza la estadística para identificar límites dentro del conjunto de datos. Los datos con patrones similares se agrupan, creando subconjuntos de datos. A medida que continúa el proceso de clasificación, el algoritmo empieza a comprender el conjunto de datos que analiza, lo que le permite predecir la categorización de datos futuros.
Esta agrupación de datos puede automatizar la toma de decisiones y añadir un nivel de sofisticación al aprendizaje no supervisado. Más importante aún, nos permite aprovechar los datos de una manera nueva. Lo que nos falta de conocimiento lo compensamos con datos.
ML por refuerzo
El aprendizaje por refuerzo se parece al ML no supervisado porque los datos de entrenamiento tampoco están etiquetados. Sin embargo, cuando se plantea una pregunta sobre los datos, el resultado se califica, por lo que sigue existiendo cierto grado de supervisión. Al algoritmo se le presentan datos sin etiquetas, pero se le proporciona un ejemplo con un resultado positivo o negativo. Esta calificación positiva o negativa genera un ciclo de retroalimentación que permite al algoritmo determinar si la solución que ofrece resuelve un problema o no. En la práctica, es la versión computarizada del aprendizaje humano por ensayo y error.
El ML por refuerzo suele utilizarse para elaborar estrategias. Como las decisiones tienen consecuencias, la acción resultante es prescriptiva y no meramente descriptiva, como en el aprendizaje no supervisado. Este tipo de aprendizaje se ha utilizado para enseñar a los ordenadores a jugar. Esta es la idea detrás de DeepMind, empresa adquirida por Google en 2014, que entrenó que entrenaron su algoritmo para aprender a jugar al Atari.
Después creó AlphaGo que derrotó al mejor jugador profesional de Go por 4-1 en el juego del Go, uno de los juegos más complejos del mundo.
Implicaciones para las empresas
Hoy en día, el aprendizaje automático se utiliza en numerosos ámbitos. El coche autónomo de Google se desarrolló mediante aprendizaje automático y, actualmente, las máquinas pueden leer los labios más rápido que los seres humanos. En los últimos años, el ML se ha extendido a casi todos los sectores financieros. Por ejemplo, se utiliza para el comercio algorítmico, analizar datos de series temporales, gestionar carteras, detectar fraudes, atender a clientes, analizar noticias, elaborar estrategias de inversión, etc.
Pero el verdadero potencial del aprendizaje automático se despliega con las redes neuronales. En la próxima publicación hablaremos un poco más sobre ellas.




