Asistentes de voz populares como Alexa, Siri y Google utilizan software de reconocimiento de voz para responder a tus preguntas, pero el lenguaje de los niños es muy complejo e impredecible.
Los niños sobrearticulan las palabras, alargan ciertas sílabas, puntúan cada palabra mientras piensan en voz alta o se saltan algunas palabras por completo.
Los niños pasan más de 5 horas al día frente a pantallas; es fundamental que se les entienda.
Antes de la pandemia, más del 40 % de los nuevos usuarios de internet eran niños. Las estimaciones actuales sugieren que el tiempo de pantalla de los niños se ha disparado en un 60 % o más, y los menores de 12 años pasan más de cinco horas al día frente a pantallas (con todos los beneficios y riesgos asociados beneficios y riesgos).
Aunque es fácil maravillarse ante la destreza tecnológica de los nativos digitales, los educadores (y los padres) son muy conscientes de que los jóvenes “alumnos a distancia” a menudo tienen dificultades para manejar los teclados, menús e interfaces necesarios para hacer realidad la promesa de la tecnología educativa.
En este contexto, los asistentes digitales con control por voz ofrecen la esperanza de una interacción con la tecnología más fluida. Pero, aunque a los niños les encanta pedirle a Alexa o a Siri que hagan beatbox, cuenten chistes o imiten sonidos de animales, los padres y los docentes saben que estos sistemas tienen dificultades para comprender a sus usuarios más pequeños cuando se salen de las peticiones previsibles.
El problema radica en que el software de reconocimiento de voz que impulsa asistentes populares como Alexa, Siri y Google nunca se diseñó para usarse con niños, cuyas voces, lenguaje y comportamiento son mucho más complejos que los de los adultos.
No se trata solo de que las voces infantiles sean más agudas: sus tractos vocales son más finos y cortos, sus pliegues vocales más pequeños y su laringe aún no se ha desarrollado por completo. Esto da lugar a patrones de habla muy distintos a los de un niño mayor o de un adulto.
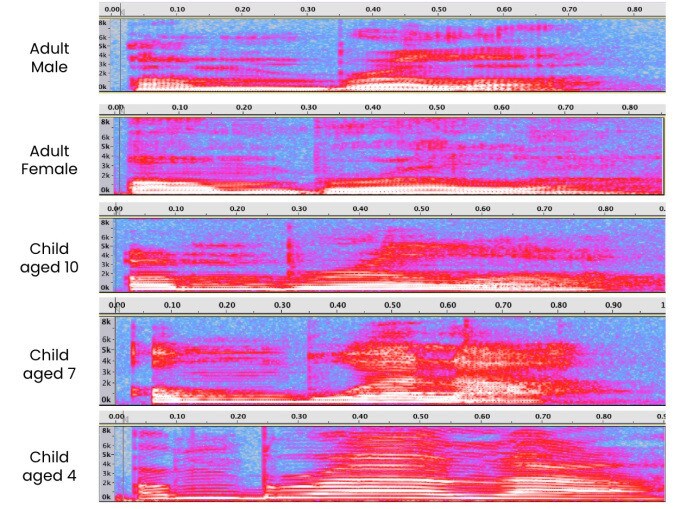
En el gráfico siguiente se aprecia con facilidad que simplemente cambiar el tono de las voces de adultos utilizadas para entrenar el reconocimiento de voz no logra reproducir la complejidad de información necesaria para comprender el habla de un niño. Las estructuras y los patrones lingüísticos de los niños varían enormemente. Dan saltos en sintaxis, pronunciación y gramática que deben tenerse en cuenta en el componente de procesamiento del lenguaje natural de los sistemas de reconocimiento de voz. A esa complejidad se suma la variabilidad entre hablantes infantiles en una amplia gama de etapas de desarrollo distintas, que no necesita tenerse en cuenta con el habla de adultos.
La conducta de habla de un niño no solo es más variable que la de los adultos, sino que es enormemente errática. Los niños sobrearticulan las palabras, alargan ciertas sílabas, puntúan cada palabra mientras piensan en voz alta o se saltan algunas palabras por completo. Sus patrones de habla no se ajustan a las cadencias habituales que conocen los sistemas diseñados para usuarios adultos. Los adultos hemos aprendido a interactuar mejor con estos dispositivos y a obtener la mejor respuesta. Nos enderezamos, formulamos la petición en la mente, la modificamos según el comportamiento aprendido y pronunciamos nuestras peticiones en voz alta, inspiramos hondo… “Alexa… ” Los niños sueltan sin pensar sus peticiones como si Siri o Alexa fueran humanos, y, en la mayoría de los casos, reciben una respuesta errónea o estandarizada.
En el entorno educativo, estos retos se agravan porque el reconocimiento de voz debe lidiar no solo con el ruido ambiental y la imprevisibilidad del aula, sino también con los cambios en el habla de un niño a lo largo del curso, y con la multiplicidad de acentos y dialectos propios de una escuela primaria típica. Las diferencias físicas, lingüísticas y conductuales entre niños y adultos también aumentan drásticamente cuanto más pequeño es el niño. Eso significa que los alumnos más jóvenes, que son quienes más pueden beneficiarse del reconocimiento de voz, son los más difíciles de desarrollar para los programadores.
Para tener en cuenta y comprender las peculiaridades, muy variadas, del lenguaje infantil, se requieren sistemas de reconocimiento de voz diseñados para aprender de forma intencionada de la manera en que hablan los niños. El habla infantil no puede tratarse simplemente como otro acento o dialecto al que el reconocimiento de voz deba adaptarse; es fundamental y prácticamente distinta, y cambia a medida que los niños crecen y desarrollan tanto lo físico como sus habilidades lingüísticas.
A diferencia de la mayoría de los contextos de consumo, la precisión tiene implicaciones profundas para los niños. Un sistema que le dice a un niño que se equivoca cuando tiene razón (falso negativo) daña su confianza; uno que le dice que tiene razón cuando se equivoca (falso positivo) arriesga un daño socioemocional (y psicométrico). En un contexto de entretenimiento, en aplicaciones, videojuegos, robótica y juguetes inteligentes, estos falsos negativos o positivos generan experiencias frustrantes. En las escuelas, los errores, las malinterpretaciones o las respuestas estandarizadas pueden tener implicaciones educativas y de equidad mucho más profundas.
Sesgo bien documentado en el reconocimiento de voz puede, por ejemplo, tener efectos perniciosos en los niños. No es aceptable que un producto funcione con menor precisión (generando falsos positivos y negativos) para niños de cierto perfil demográfico o socioeconómico. Un cuerpo creciente de investigaciones sugiere que la voz puede ser una interfaz muy valiosa para los niños, pero no podemos permitir ni ignorar el riesgo de que amplifique sesgos y desigualdades ya endémicos en nuestras escuelas.
El reconocimiento de voz tiene el potencial de convertirse en una herramienta poderosa para los niños, tanto en casa como en el aula. Puede cubrir lagunas críticas en el apoyo a los niños durante las etapas del aprendizaje de la lectoescritura y del lenguaje, ayudándoles a comprender mejor el mundo que les rodea y a ser comprendidos por él. Puede allanar el camino hacia una nueva era de medidas observacionales “invisibles” que funcionen de forma fiable, incluso en un entorno remoto. Pero la mayoría de las herramientas actuales de reconocimiento de voz no están bien adaptadas a este objetivo. Las tecnologías de Siri, Alexa y otros asistentes de voz tienen una función: entender a adultos que hablan con claridad y de forma predecible, y, en su mayor parte, la cumplen bien. Si el reconocimiento de voz ha de funcionar para los niños, debe modelarse para sus voces, lenguaje y comportamientos únicos, y responder a ellos.




