En un avance significativo para la inteligencia artificial, el software de reconocimiento de voz ya puede entender el lenguaje con tanta precisión como las personas, aunque captar el contexto sigue siendo difícil.
Investigadores de Microsoft han creado un software cuya tasa de error por palabra es del 5,9 %, aproximadamente la misma que la de un transcriptor humano.
«Este hito de investigación no significa que el ordenador haya reconocido perfectamente todas las palabras. De hecho, los humanos tampoco lo hacen. Significa, en cambio, que la tasa de error —o la frecuencia con la que el ordenador oye mal una palabra, como haber en lugar de es o un en lugar de el— es la misma que cabría esperar de una persona que escucha la misma conversación», Microsoft dijo en una entrada de blog.
El resultado se ha ido acercando durante muchos años y llega apenas unas semanas después de que el mismo equipo informara de que había reducido la tasa de error a un prometedor 6,3 %.
Hace veinte años, la tasa de error por palabra del mejor sistema de investigación publicado superaba el 43 %.
Redes neuronales
Tanto IBM como Microsoft señalan la llegada de las redes neuronales profundas, inspiradas en los procesos biológicos del cerebro, como una razón clave de los avances en el reconocimiento del habla.
Desde hace décadas, los informáticos intentan entrenar sistemas para realizar tareas como reconocer imágenes y comprender el habla, pero hasta hace poco esos sistemas estaban plagados de imprecisiones.
El nuevo programa de Microsoft se basa en estas redes neuronales profundas y en unidades especializadas de procesamiento gráfico, que permiten al software aprender a velocidades antes imposibles.
Un mercado en auge
Este hito tiene repercusiones de gran alcance.
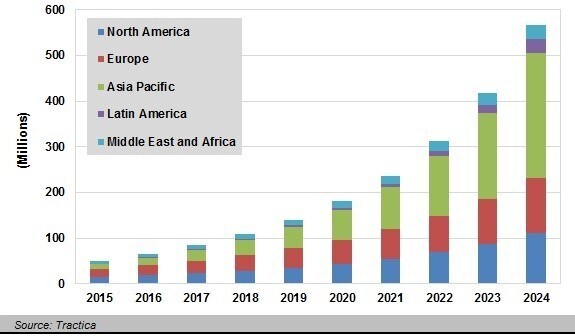
Investigaciones recientes de Tractica pronosticaron que las licencias de software de reconocimiento de voz superarían los 550 millones en todo el mundo para 2024. Los usos de consumo y de atención sanitaria son los sectores de mayor crecimiento, pero la tecnología tiene repercusiones en múltiples industrias.
Licencias anuales de reconocimiento de voz y del habla por región, 2015-2024
Aún queda trabajo por hacer
Los investigadores afirman que hace falta más trabajo para mejorar el sistema en situaciones reales, como en lugares con mucho ruido de fondo. La investigación para identificar a cada hablante cuando varias personas hablan también forma parte de los esfuerzos de investigación a más largo plazo.
Y, como puede atestiguar cualquiera que haya pasado tiempo gritándole a Siri, Cortana o Google Assistant, todavía queda mucho trabajo para que los ordenadores no solo entiendan qué palabras se dicen, sino también su significado y contexto. Aún pasará tiempo antes de que puedan responder preguntas o seguir instrucciones con la misma precisión que las personas.
Harry Shum, quien dirige el grupo de Microsoft de Inteligencia Artificial e Investigación, afirma: «Pasará mucho más tiempo; queda mucho camino por recorrer antes de que los ordenadores puedan entender el verdadero significado de lo que se dice o se muestra».




