Investigadores han utilizado IA y traducción de imágenes para enseñar a un robot a reconocer el agua y servirla en un vaso.
A los robots les cuesta entender los líquidos transparentes debido a las muchas formas en que reflejan, refractan y absorben la luz.
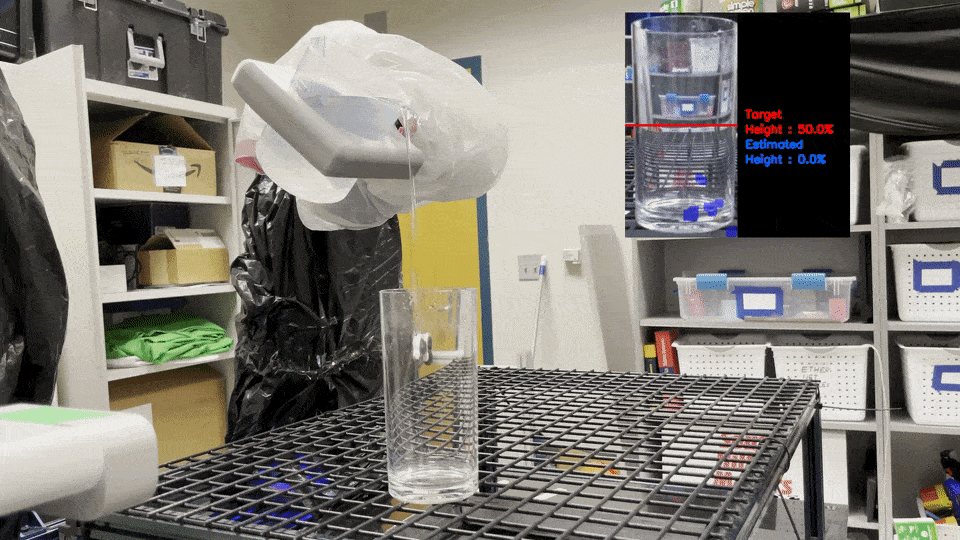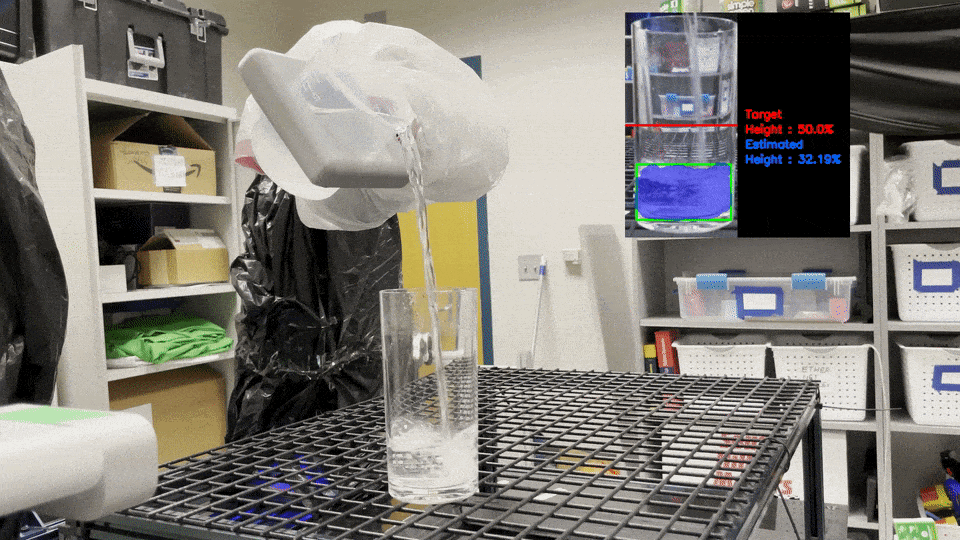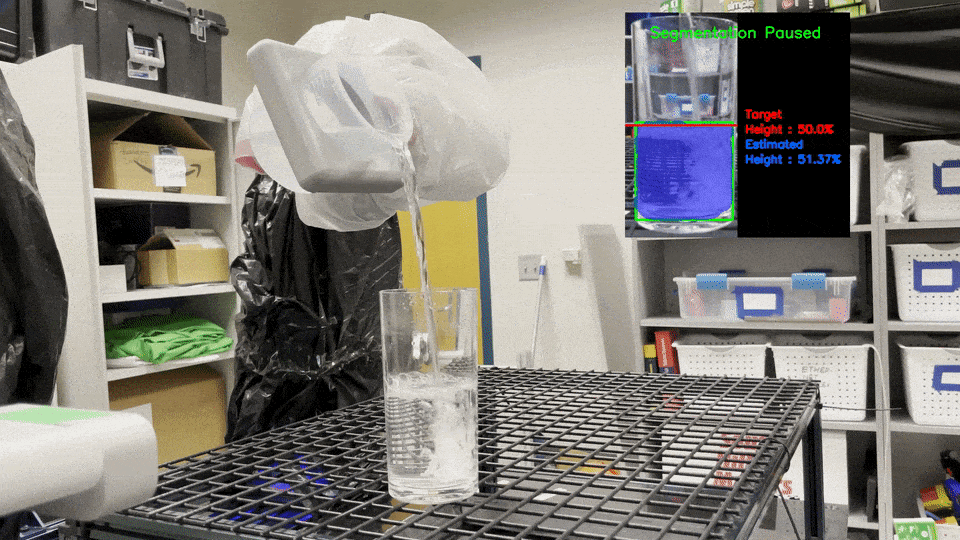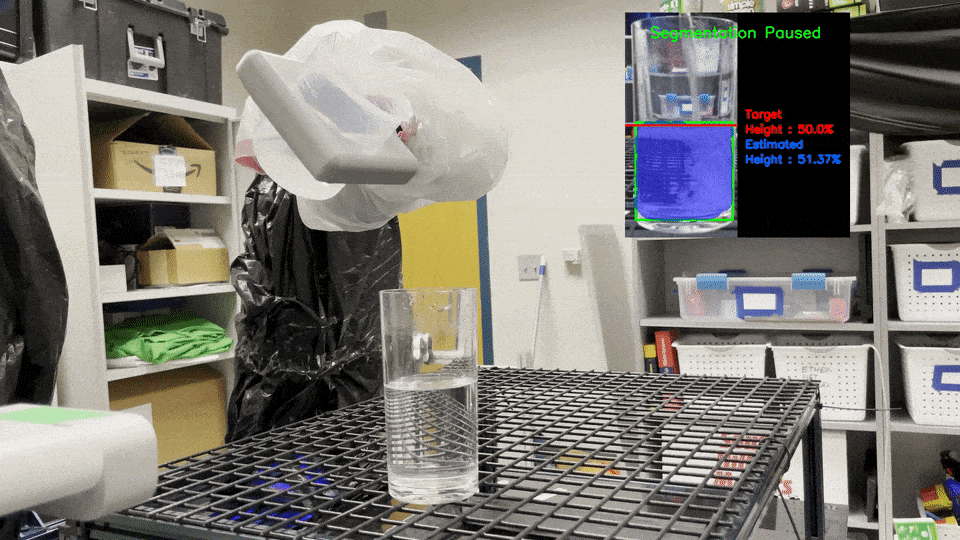
Al reproducir vídeos detrás de un vaso transparente con agua, se entrena al robot para servir agua sobre fondos variados en el mundo real, independientemente de dónde se encuentre.
Este descubrimiento podría permitir que los camareros robóticos rellenaran vasos de agua, que los farmacéuticos robóticos midieran y mezclaran medicamentos, o que los jardineros robóticos regaran las plantas.
Un caballo, una cebra y la inteligencia artificial ayudaron a los investigadores a enseñar a un robot a reconocer el agua y servirla en un vaso.
El agua supone un reto complejo para los robots porque es transparente. Los robots ya han aprendido a servir agua, pero las técnicas anteriores, como calentarla y usar una cámara térmica o colocar el vaso delante de un fondo cuadriculado, no se adaptan bien a la vida cotidiana.
Una solución más sencilla podría permitir que los camareros robóticos rellenaran vasos de agua, que los farmacéuticos robóticos midieran y mezclaran medicamentos, o que los jardineros robóticos regaran las plantas.
Ahora, los investigadores han utilizado IA y traducción de imágenes para resolver el problema.
Enseñar a un robot a servir agua
Los algoritmos de traducción de imágenes utilizan colecciones de imágenes para entrenar a la inteligencia artificial y convertir imágenes de un estilo a otro, como transformar una foto en un cuadro al estilo de Monet o hacer que la imagen de un caballo parezca una cebra. Para esta investigación, el equipo utilizó un método llamado aprendizaje contrastivo para la traducción de imágenes de imagen a imagen sin pares, o CUT, por sus siglas en inglés.
«Durante la fase de entrenamiento, se necesita alguna forma de indicar al algoritmo cuáles son las respuestas correctas e incorrectas», afirma David Held, profesor adjunto del Instituto de Robótica de la Universidad Carnegie Mellon. «Sin embargo, etiquetar datos puede llevar mucho tiempo, sobre todo al enseñar a un robot a servir agua, porque quizá una persona tenga que etiquetar cada gota de agua en una imagen».
Entran en escena el caballo y la cebra.
«Del mismo modo que podemos entrenar un modelo para traducir la imagen de un caballo y hacer que parezca una cebra, también podemos entrenar un modelo para traducir la imagen de un líquido coloreado en una imagen de un líquido transparente», afirma Held. «Utilizamos este modelo para que el robot pudiera entender los líquidos transparentes».
Un transparente líquido como el agua es difícil de ver para un robot, porque la forma en que refleja, refracta y absorbe la luz varía según el fondo. Para enseñar al ordenador a ver distintos fondos a través de un vaso de agua, el equipo reprodujo vídeos de YouTube detrás de un vaso transparente lleno de agua. Entrenar el sistema de esta manera permitirá al robot servir agua sobre fondos variados en el mundo real, independientemente de dónde se encuentre.
«A veces, incluso a las personas les cuesta identificar con precisión el límite entre el agua y el aire», afirma Gautham Narasimhan, quien obtuvo su máster en el Instituto de Robótica en 2020 y trabajó con un equipo del Laboratorio de Percepción y Acción Robótica del instituto en este nuevo estudio.
Con su método, el robot pudo servir agua hasta alcanzar cierta altura en un vaso. Después repitieron el experimento con vasos de distintas formas y tamaños.
Narasimhan afirma que hay margen para ampliar este método en futuras investigaciones: incorporar distintas condiciones de iluminación, plantear al robot el reto de servir agua de un recipiente a otro o estimar no solo la altura del agua, sino también su volumen.
Los investigadores presentaron su trabajo en la Conferencia Internacional de Robótica y Automatización del IEEE en mayo de 2022.
«En el ámbito de la robótica, la gente valora mucho que la investigación funcione en el mundo real y no solo en una simulación», afirma Narasimhan, que ahora trabaja como ingeniero de visión artificial en Path Robotics, en Columbus, Ohio. «Queríamos hacer algo bastante sencillo, pero eficaz».




