Los dispositivos de control por voz —como Alexa de Amazon, Home de Google o HomePod de Apple— son cada vez más populares, pero conviene reflexionar sobre los avances en aprendizaje automático que podrían permitir que las aplicaciones comprendan distintas emociones en el habla.
El director ejecutivo de Google, Sundar Pichai, dijo recientemente que el 20 % de las búsquedas de la empresa se inician mediante la voz a través de teléfonos móviles. Además, a finales de 2017, un análisis del mercado estadounidense indicaba que se habían vendido en total 44 millones de dispositivos Amazon Alexa y Google Home.
La tecnología tiene capacidades cada vez más impresionantes para reconocer palabras, pero, como experto en acústica, tengo claro que la comunicación verbal es mucho más compleja. La manera de decir las cosas puede ser tan importante como las palabras mismas. Cuando alguien dice «Estoy bien», el tono de su voz puede indicar que su estado de ánimo es el contrario de lo que afirma.
Los dispositivos de control por voz, también conocidos como altavoces inteligentes o asistentes virtuales, pueden resultar frustrantes porque solo prestan atención a las palabras y, en gran medida, ignoran cómo se expresa el habla. Los gigantes tecnológicos esperan que la próxima frontera de dispositivos como Amazon Echo sea detectar cómo se siente una persona por su voz para que las interacciones sean más naturales.

La voz humana puede revelar información sobre quién es una persona, de dónde viene y cómo se siente. Cuando habla un desconocido, la gente percibe enseguida su acento y entonación, y hace suposiciones sobre su clase social, sus orígenes y su educación.
Si los dispositivos de control por voz captan esa información, podrían mejorarse las interfaces de voz. Pero conviene mantener la cautela ante las consecuencias imprevistas. La tecnología depende del aprendizaje automático, una rama de la inteligencia artificial que combina algoritmos y estadísticas aprendidos por una máquina alimentada con enormes cantidades de datos; por eso, su comportamiento no es del todo predecible.
¿El futuro será inteligente o tonto?
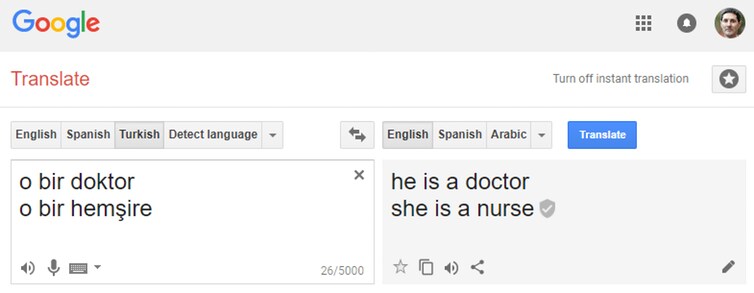
Las investigaciones demuestran que los ejemplos de habla utilizados para entrenar una aplicación de aprendizaje automático pueden generar sesgos. Estos problemas tecnológicos se han observado en herramientas populares como Google Translate.
Por ejemplo, al traducir al inglés las frases turcas «o bir doktor» y «o bir hemşire», el servicio de Google ofrece los resultados «él es médico» y «ella es enfermera». Sin embargo, «o» es un pronombre de tercera persona sin género en turco. La suposición de que un médico es hombre y una enfermera es mujer refleja prejuicios culturales y la distribución desigual de género en la profesión médica.
Google Translate reprodujo un sesgo cultural humano presente en los datos con los que se entrenaron los algoritmos, y el resultado final es un sistema de traducción sexista.
No es fácil resolver estos problemas porque el aprendizaje automático reproduce los estereotipos humanos. Cuando escuchan voces, las personas simplifican la tarea de decidir cómo responder a alguien recurriendo a reglas prácticas.
Las investigaciones muestran que, cuando la gente oye a una mujer terminar muchas de sus frases con una inflexión ascendente, conocida como «uptalk», suele suponer que es joven. Si un hombre habla con voz grave, se da por sentado que es corpulento y fuerte. Estas suposiciones simplificadas sobre el habla pueden dar lugar a juicios prejuiciosos.
Según un estudio, los sospechosos de delitos con acento de Birmingham tenían más probabilidades de ser considerados culpables que quienes tenían un acento más neutro. Las investigaciones también han revelado que se percibía que las personas con acento no nativo eran menos veraces.
Determinar por el habla si una persona está enfadada, contenta o triste podría ser muy útil para quienes usan dispositivos de control por voz. Pero las señales vocales que emiten las personas varían de una a otra, y también entre idiomas y culturas. Los seres humanos no siempre reconocen correctamente las emociones, como puede atestiguar cualquiera que haya tenido una relación; entonces, ¿por qué esperar que las máquinas lo hagan mejor?
La investigación sobre el «gaydar» auditivo de las personas —término coloquial que usan algunas personas que afirman poder intuir si alguien es gay, lesbiana o bisexual— ofrece un buen ejemplo de señales ambiguas e incluso falsas. Quienes escuchan hacen suposiciones, por ejemplo, sobre cómo debería sonar un hombre gay, como tener una voz más aguda, pero a menudo se equivocan. Según las investigaciones, los actores que exageraban estereotipos erróneos, aparentemente para responder a las expectativas del público, acabaron convirtiéndose en algo parecido a una norma cultural en la televisión, según muestran las investigaciones.
La ambigüedad natural e individual de las señales vocales probablemente dará lugar a errores, a menos que las empresas tecnológicas aprendan de sus errores. Las aplicaciones que intentan interpretar la voz humana podrían aprender prejuicios arraigados, dado que esta tecnología depende en gran medida de los datos con los que se alimenta.
Es posible que las empresas tecnológicas que desarrollan dispositivos y servicios de control por voz ya consulten a expertos en acústica. Pero deben escuchar atentamente las advertencias para comprender mejor qué escollos evitar antes de aplicar el aprendizaje automático a la descodificación de la voz humana.




