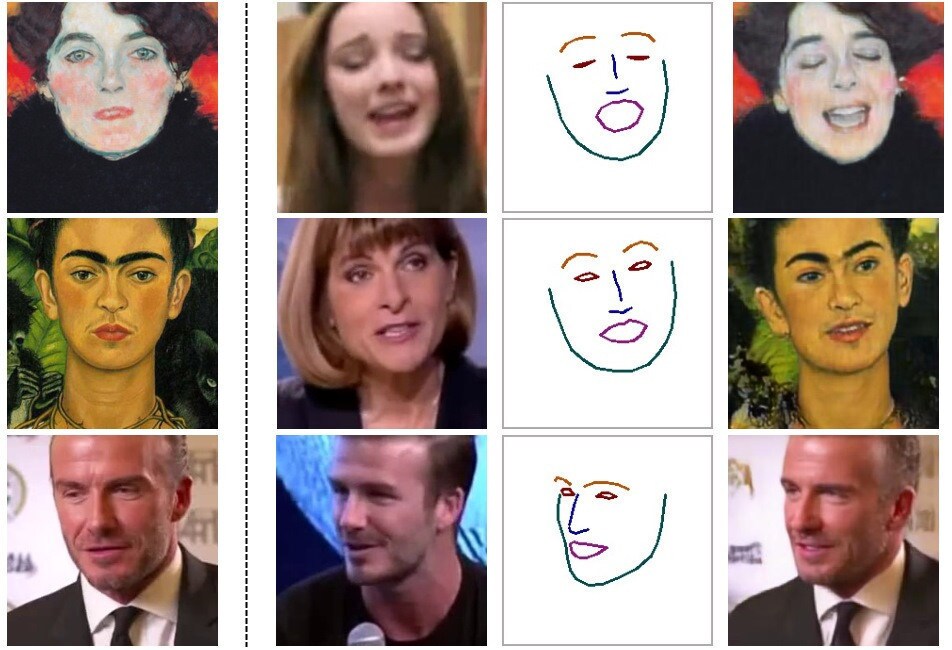
Unos investigadores especializados en aprendizaje automático han creado un sistema capaz de recrear movimientos realistas a partir de un solo fotograma del rostro de una persona, lo que abre la posibilidad de animar no solo fotografías, sino también pinturas. No es perfecto, pero cuando funciona resulta —como ocurre con gran parte de la IA actual— inquietante y fascinante.
El modelo está documentado en un artículo publicado por Samsung AI Center, que puedes leer aquí en Arxiv. Se trata de un nuevo método para aplicar los puntos de referencia faciales de un rostro de origen —sirve cualquier rostro parlante— a los datos faciales de un rostro objetivo, haciendo que este último haga lo mismo que el rostro de origen.
Esto, por sí solo, no es nuevo: forma parte de todo el problema de las imágenes sintéticas al que se enfrenta ahora el mundo de la IA (hace poco tuvimos un interesante debate sobre este tema en nuestro evento de Robótica + IA en Berkeley). Ya podemos hacer que un rostro de un vídeo refleje el de otro en cuanto a lo que dice la persona o hacia dónde mira. Sin embargo, la mayoría de estos modelos requieren una cantidad considerable de datos; por ejemplo, uno o dos minutos de vídeo para analizar.
Sin embargo, el nuevo artículo de los investigadores de Samsung con sede en Moscú muestra que, usando una sola imagen del rostro de una persona, se puede generar un vídeo en el que ese rostro gira, habla y hace expresiones corrientes, con una fidelidad convincente, aunque lejos de ser perfecta.
Lo consigue adelantando el proceso de identificación de los puntos de referencia faciales con una enorme cantidad de datos, lo que permite al modelo encontrar con gran eficiencia las partes del rostro objetivo que corresponden al de origen. Cuantos más datos tenga, mejor, pero puede hacerlo con una sola imagen —lo que se conoce como aprendizaje de una sola muestra— y funcionar bien. Eso es lo que permite tomar una foto de Einstein, de Marilyn Monroe o incluso de la Mona Lisa y hacer que se mueva y hable como una persona real.
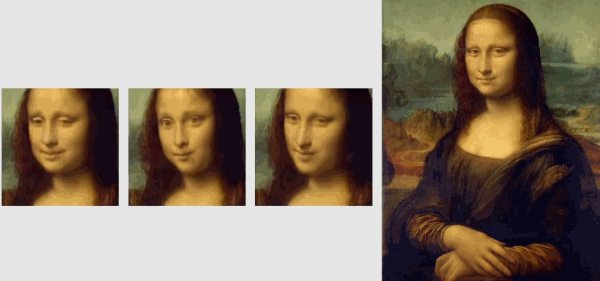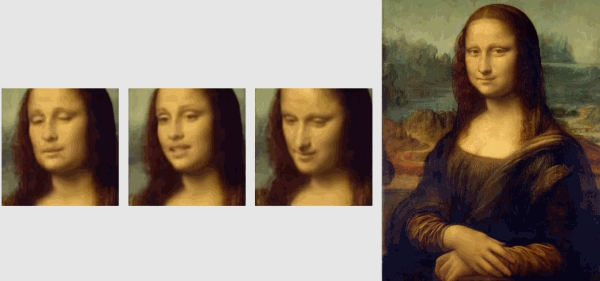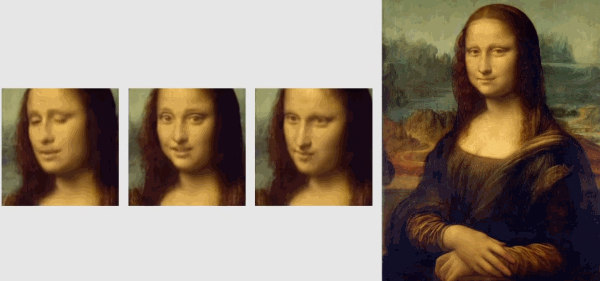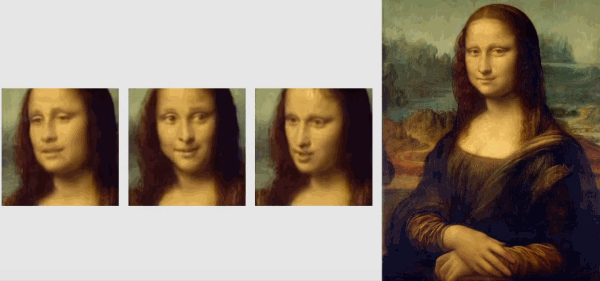
También se utiliza lo que se conoce como una red generativa antagónica, que básicamente enfrenta dos modelos: uno intenta engañar al otro para que crea que lo que crea es «real». Así, los resultados alcanzan cierto nivel de realismo establecido por sus creadores: para que el proceso continúe, el modelo «discriminador» debe tener, por ejemplo, un 90 % de certeza de que se trata de un rostro humano.
En los otros ejemplos proporcionados por los investigadores, la calidad y lo evidente que resulta el rostro parlante falso varían mucho. Algunos intentos de reproducir a una persona cuya imagen se tomó de un canal de noticias por cable también recrean el rótulo informativo que aparece en la parte inferior de la imagen y lo llenan de galimatías. Además, las manchas y los artefactos extraños habituales están por todas partes si sabes qué buscar.
Dicho esto, es sorprendente que funcione tan bien. Sin embargo, hay que tener en cuenta que solo funciona con el rostro y la parte superior del torso: no se podría hacer que la Mona Lisa chasqueara los dedos o bailara. Al menos, todavía no.




