¿Qué no sabes y necesitas saber, y cómo sabes que no lo sabes? Imagina introducir esa pregunta en un motor de búsqueda y esperar una respuesta coherente. Las respuestas que buscamos están en el centro del descubrimiento y el aprendizaje, motivadas por la necesidad y el placer, por la pérdida del empleo o por la incertidumbre de liderazgo en un mundo complejo y cambiante. El proceso de aprendizaje requiere un conocimiento detallado de nosotros mismos y del mundo, tanto si la tarea de ayudar se encomienda a una persona como a una máquina.
Podemos llenar las lagunas en nuestras habilidades y conocimientos mediante búsquedas en la web, conversaciones con expertos y personas afines, la lectura de libros, el seguimiento de un programa educativo, el aprendizaje en línea con videotutoriales y la asimilación de una enorme cantidad de contenido que circula por canales de noticias y agregadores en línea. Parte de esto es aprendizaje estructurado, pero mucho consiste en estar receptivos a los hallazgos fortuitos mientras avanzamos a tientas en la oscuridad.
El aprendizaje automático ya está empezando a ayudar. Está asimilando y modelando lo que sabes y lo que no sabes para ofrecer información más específica que ayude a las personas a aprender. Hacia allí se dirigen las empresas de plataformas como Google, LinkedIn y Amazon: crean algoritmos que nos representan, junto con nuestras necesidades, en forma de datos. El aprendizaje permanente estará impulsado por tecnologías de emparejamiento basadas en plataformas, que sabrán lo suficiente sobre nosotros para hacer recomendaciones y adaptarse a nuestros contextos cambiantes. Este es el punto de conexión entre el aprendizaje humano y el aprendizaje automático.
Emparejamiento mediante plataformas
En el centro de esta oportunidad están los datos —muchos datos— y los algoritmos que saben convertirlos en una matriz de comparaciones para emparejar opciones. Amazon lleva mucho tiempo usando este enfoque para recomendar productos: «Los clientes que compraron este artículo también compraron…». En Tinder, un algoritmo de emparejamiento compara los datos de un perfil con los de otros para ofrecer una lista de posibilidades. En Facebook, el emparejamiento se utiliza para segmentar la publicidad. En la práctica, tus datos se están convirtiendo en una representación de ti con un propósito específico. El algoritmo necesita saber lo suficiente sobre ti y sobre lo que buscas para ofrecerte opciones ordenadas por relevancia. Esta técnica es sencilla, ubicua y sorprendentemente potente. Sin embargo, la utilidad de estos algoritmos va mucho más allá de decidir qué libro leer después, y apenas está empezando a desarrollarse.
El Economic Graph de LinkedIn «traza digitalmente un mapa de la economía mundial para conectar el talento con las oportunidades a gran escala». Ofrece una visión muy clara de la naturaleza cambiante del trabajo, los tipos de habilidades que conforman determinados empleos y las conductas relacionadas con el trabajo que anticipan un cambio de empleo. También puede detectar una carencia de habilidades que debe cubrirse antes de avanzar en una carrera profesional. Detectar las carencias de habilidades de las personas y ayudarlas a cubrirlas da pleno sentido a la compra de la aplicación de agregación de contenidos Pulse en 2013, del sitio de aprendizaje en línea Lynda.com en 2015 y al lanzamiento de LinkedIn Learning en septiembre de 2016.
Una ironía de las próximas décadas es que el aprendizaje automático eliminará cada vez más empleos basados en el conocimiento, como los relacionados con el derecho contractual y el trabajo secretarial, pero también identificará y recomendará oportunidades de aprendizaje para ayudar a esas personas a cubrir las nuevas lagunas en sus conocimientos y conseguir otros empleos.
Del aprendizaje personal al aprendizaje organizacional
En los próximos años, las mismas tecnologías que impulsan estas innovaciones se generalizarán en todo tipo de empresas. Desde hace tiempo se habla de empresas y culturas impulsadas por los datos, pero en realidad se trata de pasar a estar impulsados por el conocimiento. Los departamentos y equipos trabajan en silos, con lo que saben encerrado en sus propias cabezas; los procesos internos no están optimizados; la formación del personal puede ser casi inexistente; es posible que la junta directiva conozca poco las dinámicas internas y que el director ejecutivo no haya aprendido sobre las amenazas disruptivas que se precipitan hacia los resultados de la empresa.
El descontento, la falta de transparencia y el aprovechamiento subóptimo del talento en las organizaciones pueden beneficiarse de los mismos algoritmos de recomendación que se usan para elegir música. «Los colegas que resolvieron este problema también hablaron con…»; «Los directores ejecutivos a quienes les faltaban estos conocimientos también carecían de…»; «Las empresas que necesitaban este servicio también necesitaban…». Se ve hacia dónde va esto, aunque lo digamos con algo de ironía.
Pese al actual auge del interés por el aprendizaje automático y la inteligencia artificial, estamos tan lejos de comprender nuestros itinerarios personales de aprendizaje como lo estábamos de entender que la Tierra gira alrededor del Sol antes de Copérnico. Una revolución basada en el conocimiento, impulsada por el aprendizaje automático, irrumpirá en el mundo empresarial y traerá consigo un cambio de paradigma en la forma en que las empresas se estructuran y colaboran entre sí. Las empresas utilizarán nuevas técnicas impulsadas por tecnologías, ya comercializadas y ampliamente disponibles, para aprender, optimizarse y evolucionar.
Sesgos en la matriz
Aunque las recomendaciones basadas en el aprendizaje automático generan ingresos para las plataformas web y los sitios de comercio electrónico, todavía están lejos de ser sofisticadas. Tienen un éxito sorprendente, pese a que en su mayoría solo utilizan métodos estadísticos poco rigurosos para comparar matrices de información y ofrecer después un conjunto de opciones. Es una cuadrícula, no una decisión.
El eslabón más débil de estos sistemas de aprendizaje automático suelen ser los programadores y sus empresas, que introducen sesgos mediante un modelado deficiente de algoritmos y un enfoque basado en atajos. Comprar un par de zapatos en Amazon puede hacer que esos mismos zapatos aparezcan en anuncios durante semanas. El algoritmo parece no saber qué se ha comprado ya. También existe el problema de la contaminación de los datos personales, que puede ocurrir si compras un libro para un familiar o un amigo. De repente, el algoritmo cree que esa es una de tus preferencias. Además, una burbuja de popularidad puede mantener artículos en los primeros puestos de una lista de lectura mediante un ciclo que se confirma a sí mismo: la gente hace clic en los primeros artículos de la lista. La financiación publicitaria eleva la prioridad de un artículo frente a otro. Actualmente somos testigos del problema de las noticias falsas, que socavan la percepción de la gente durante las elecciones. La velocidad de difusión social puede convertirse fácilmente en una señal distorsionada para el algoritmo de recomendación, y muchas personas cuentan con pocos mecanismos de control para separar los hechos de las falsedades.
Esto representa una oportunidad para la ingeniería de relevancia. Nuestros algoritmos de aprendizaje están poco evolucionados. Seguimos operando principalmente según principios de similitud: esto se parece a aquello, así que aquí tienes más de lo mismo. Habrá que modelar las dependencias entre habilidades y las relaciones complementarias entre ámbitos del conocimiento para que los algoritmos orienten de manera significativa las experiencias de aprendizaje personal.
El contenido se está convirtiendo en datos
En 2015, TED lanzó watson.ted.com como una colaboración entre TED e IBM Watson. El archivo completo de las charlas TED se catalogó y se incorporó a Watson. Los conocimientos ocultos en miles de horas de vídeo quedaron disponibles para que el aprendizaje automático los analizara. Los servicios de conversión de voz a texto transcribieron los vídeos para que el procesamiento del lenguaje natural pudiera extraer conceptos, personas, lugares y cosas, y clasificarlos por temas.
Este proceso consiste en crear una estructura de conocimiento a partir de palabras que antes estaban desestructuradas en las transcripciones. El contenido se ha convertido en datos. Es como si el aprendizaje automático hubiera leído todos los libros que tú has leído y todos los que no has leído, y recomendara uno comparando todo el contenido. Es un cálculo enorme. Inicia sesión en TED con tu cuenta de Facebook y el sistema realizará un proceso parecido con tu historial de publicaciones en redes sociales. Llegará a conocerte muy bien, así como a las personas que conoces, y podrá elaborar una lista de vídeos muy personalizada para que aprendas a tu gusto. Es mucho más potente, útil y potencialmente preciso.
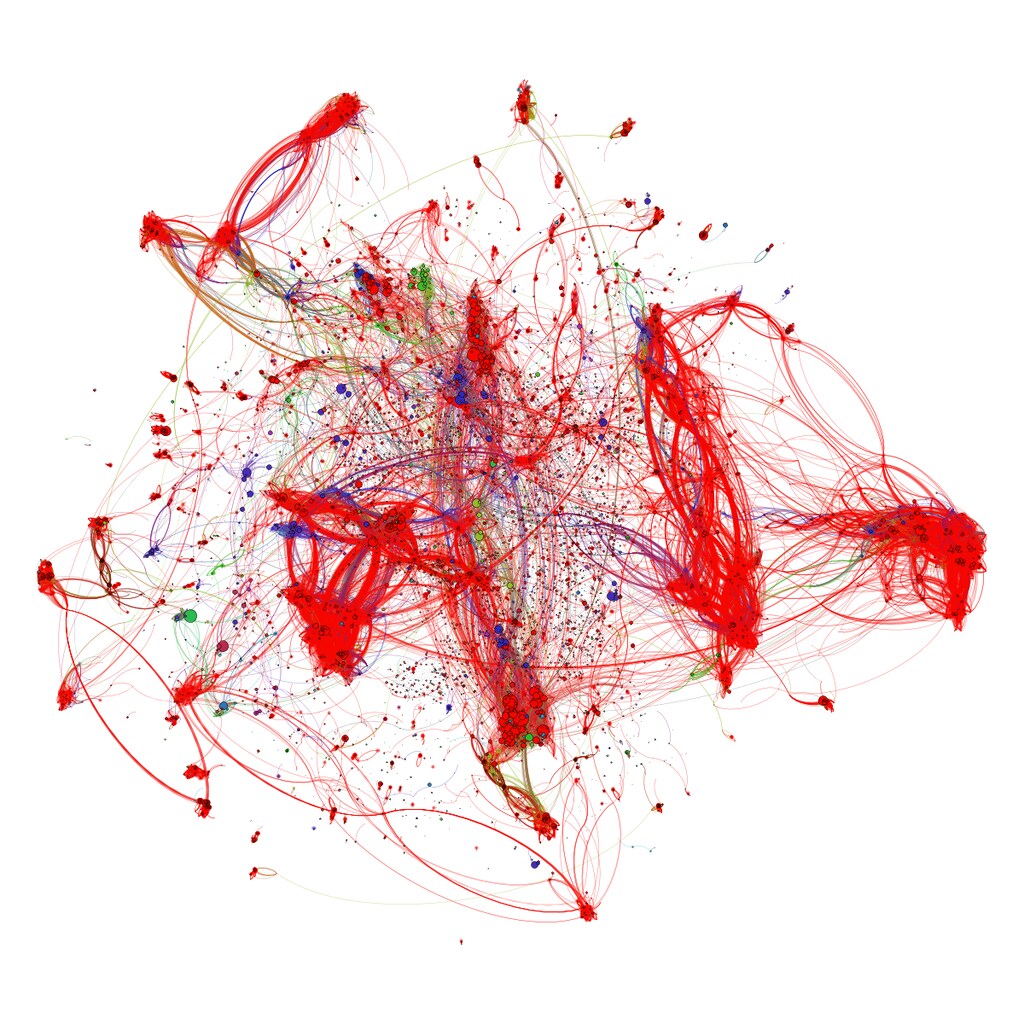
Nota: La imagen es una visualización de un proyecto de Stanford, tomada del artículo Método semiautomático para corregir un millón de tareas de O’Reilly Radar. La descripción general del método utilizado para visualizar ~40.000 trabajos de estudiantes del curso de aprendizaje automático de Coursera está en el sitio de Jon Huang.
El equilibrio entre riesgos y beneficios de este enfoque es evidente. En un momento en que los canales de contenido intentan mantener una ventaja competitiva inundando el mercado con grandes volúmenes, la gente se siente abrumada. Una encuesta de The Economist confirmó que este fenómeno ha causado confusión en tres quintas partes de los directivos de todo el mundo, y que el contenido de liderazgo intelectual está tan saturado que ha perdido valor. El flujo de conocimiento está interrumpido porque el volumen ya no funciona. La gente necesita conocimientos en red, conocimientos personalizados y filtros de aprendizaje. Actualmente, esto solo se puede lograr recurriendo a un número muy selecto de canales de contenido. En el futuro, lo hará posible un algoritmo personalizado que te conozca. Comparte algunos de tus datos y obtén mucho a cambio en forma de personalización, siempre que exista la confianza necesaria para utilizar tus datos con respeto.
Una nueva conciencia del conocimiento
El informe sobre el futuro del empleo del Foro Económico Mundial destaca que entre 2015 y 2020 cambiará el 35% de las habilidades básicas. Asimismo, un informe de Forrester prevé que los robots sustituirán el 25% de los empleos automatizables en cuatro años. Esta disrupción será cada vez más visible. Por ejemplo, la tienda de autoservicio sin cajas Amazon Go abrió en Seattle en diciembre de 2016; Uber tiene taxis en las calles de San Francisco, listos para circular sin conductor, pero a la espera de la aprobación del DMV. No se trata necesariamente de robots con aspecto humano, sino de máquinas capaces de percibir el mundo y seguir el guion de procesos reproducibles.
Con tantos cambios a nuestro alrededor, cada vez más querremos que el aprendizaje forme parte del ritmo de nuestras vidas, y que el aprendizaje automático actúe como el nexo entre nuestros temas de interés y nuestros niveles de comprensión. A medida que avancemos hacia una era en la que el aprendizaje automático nos complemente, querremos que nuestros datos de aprendizaje sean multicanal y portátiles, y que haya servicios de recomendación cada vez más sofisticados que nos emparejen con lo que necesitamos aprender.
Seguiremos queriendo reunirnos con expertos en conferencias para intercambiar ideas especializadas. Seguiremos queriendo que un plan de estudios estructurado centre nuestra atención, con criterios de evaluación y certificación. Y seguiremos queriendo compartir ideas en grupo y sentir que formamos parte de una comunidad de estudiantes y docentes. Ya se aprecian señales de ello en edX, Coursera, Khan Academy, Lynda.com y otros cursos en línea masivos y abiertos (MOOC), con evaluación entre pares, foros de debate, corrección automática, ejercicios interactivos y análisis del aprendizaje. Udacity incluso ofrece cursos corporativos y nanogrados para adquirir las habilidades de Silicon Valley que se necesitarán en los empleos del futuro.
El aprendizaje automático permanente es nuestro futuro. Gracias a nuestros datos personales, tendremos la oportunidad de formar a nuestros propios docentes y convertirnos en estudiantes híbridos. Cuanto más personalizado sea este aprendizaje, más centrado estará en las personas. Las máquinas descubrirán lo que no sabes y lo que necesitas saber para competir y alcanzar el éxito, mediante indicaciones y la detección de patrones en los datos. El conocimiento en red e interconectado traerá nuevas perspectivas, oportunidades y, quizá, incluso nuevas formas de aprender.
Las opiniones expresadas en este artículo son exclusivamente las del autor.
Este artículo se publicó originalmente en E 180 Magazine.




