Este trabajo avanza hacia sistemas de almacenamiento molecular que podrían albergar enormes cantidades de datos en espacios diminutos.
Las moléculas de ADN son muy conocidas como portadoras de enormes cantidades de información biológica, y existe un interés creciente en utilizar el ADN en dispositivos de almacenamiento de datos diseñados que pueden albergar muchos más datos que nuestros discos duros actuales. Pero el ADN no es la única alternativa disponible.
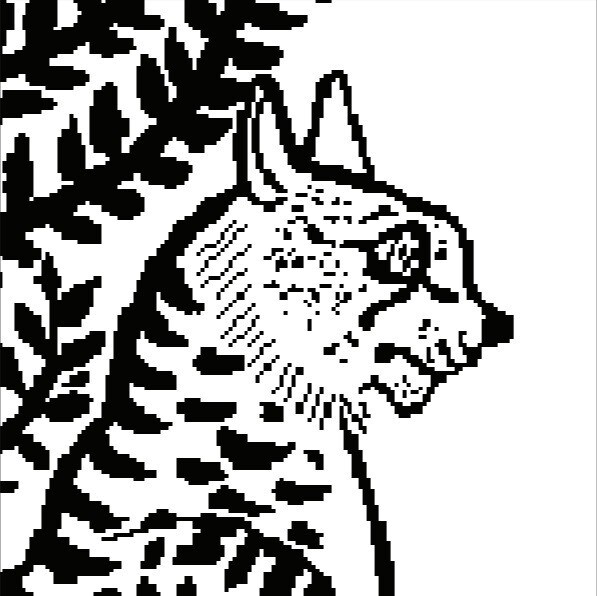
El nuevo estudio muestra que es posible almacenar y recuperar datos guardados en metabolomas artificiales: matrices de mezclas líquidas que contienen azúcares, aminoácidos y otros tipos de pequeñas moléculas. En PLOS ONE, los investigadores demuestran que podrían codificar archivos de imagen de escala de kilobytes en soluciones de metabolitos y leer de nuevo la información.
El enfoque asigna los unos y los ceros de los datos digitales a la presencia o ausencia de determinadas moléculas en soluciones. Los investigadores utilizaron este esquema para codificar archivos de imagen en soluciones.
“Se trata de una prueba de concepto que esperamos que haga reflexionar a la gente sobre el uso de una gama más amplia de moléculas para almacenar información”, afirma Jacob Rosenstein, profesor de la Escuela de Ingeniería de la Universidad de Brown y autor principal del estudio. “En algunas situaciones, las pequeñas moléculas como las que utilizamos aquí pueden tener una densidad de información incluso mayor que la del ADN”.
Otra posible ventaja, según Rosenstein, deriva del hecho de que muchos metabolitos pueden reaccionar entre sí para formar nuevos compuestos. Esto abre la posibilidad de sistemas moleculares que no solo almacenen datos, sino que también los manipulen, realizando cálculos dentro de mezclas de metabolitos.
3.000.000.000.000.000.000.000.000 BITS DE DATOS
La idea de la computación molecular surge de una necesidad creciente de mayor capacidad de almacenamiento de datos. Según algunas estimaciones, para 2040 el mundo habrá producido hasta 3 septillones (es decir, un 3 seguido de 24 ceros) de bits de datos. Almacenar, buscar y procesar todos esos datos es un desafío abrumador, y es posible que simplemente no haya suficiente silicio de calidad para chips en la Tierra para hacerlo con los chips semiconductores tradicionales.
Con la financiación de la Agencia de Proyectos de Investigación Avanzada de Defensa (DARPA), un grupo de ingenieros y químicos de Brown lleva trabajando en diversas técnicas para utilizar pequeñas moléculas en la creación de nuevos sistemas de información.
En este nuevo estudio, el grupo quería comprobar si los metabolomas artificiales podrían ser una opción de almacenamiento de datos. En biología, un metaboloma es el conjunto completo de moléculas que un organismo utiliza para regular su metabolismo.
“No es difícil reconocer que las células y los organismos utilizan pequeñas moléculas para transmitir información, pero puede ser más difícil generalizar y cuantificar”, afirma Eamonn Kennedy, investigador posdoctoral en Brown y primer autor del estudio. “Queríamos demostrar cómo un metaboloma puede codificar información digital precisa”.
CÓMO LO HICIERON
Los investigadores crearon sus propios metabolomas artificiales: pequeñas mezclas líquidas con distintas combinaciones de moléculas. La presencia o ausencia de un metabolito concreto en una mezcla codifica un bit de datos digitales, un cero o un uno. El número de tipos de moléculas en el metaboloma artificial determina el número de bits que puede contener cada mezcla.
En este estudio, los investigadores crearon bibliotecas de seis y doce metabolitos, lo que significa que cada mezcla podía codificar seis o doce bits. Luego se disponen miles de mezclas en pequeñas placas metálicas en forma de gotas de tamaño nanolitro. El contenido y la disposición de las gotas, colocadas con precisión por un robot de manipulación de líquidos, codifican los datos deseados.
Después, las placas se secan, dejando diminutas manchas de moléculas de metabolitos, cada una de las cuales contiene información digital. Los datos pueden leerse con un espectrómetro de masas, que puede identificar los metabolitos presentes en cada mancha de la placa y descodificar los datos.
Los investigadores utilizaron la técnica para codificar y recuperar con éxito diversos archivos de imagen de hasta 2 kilobytes. Esto no es mucho en comparación con la capacidad de los sistemas de almacenamiento modernos, pero, según afirman los investigadores, es una prueba de concepto sólida. Además, hay mucho margen para ampliar la escala. El número de bits de una mezcla aumenta con el número de metabolitos de un metaboloma artificial, y hay miles de metabolitos conocidos disponibles para su uso.
EL POTENCIAL DE LOS METABOLOMAS
Los investigadores señalan que existen algunas limitaciones. Por ejemplo, muchos metabolitos interactúan químicamente entre sí cuando se colocan en la misma solución, lo que podría provocar errores o pérdida de datos. Pero se trata de un fallo que podría acabar convirtiéndose en una ventaja. Podría ser posible aprovechar esas reacciones para manipular datos, realizando cálculos en solución.
“Utilizar moléculas para el cálculo es una oportunidad enorme, y apenas estamos empezando a descubrir cómo aprovecharla”, afirma Brenda Rubenstein, profesora adjunta de química y coautora del estudio.
“Investigaciones como esta cuestionan lo que se considera posible en los sistemas de datos moleculares”, afirma Rosenstein. “El ADN no es la única molécula que puede utilizarse para almacenar y procesar información. Es emocionante reconocer que existen otras posibilidades con un gran potencial.”




