Inteligencia general
La IA se ha vuelto bastante buena para completar tareas específicas, pero todavía está lejos de tener inteligencia general, es decir, el tipo de inteligencia integral que permitiría a la IA desenvolverse en el mundo de la misma manera que lo hacen los humanos o incluso los animales.
Uno de los elementos clave de la inteligencia general es el razonamiento abstracto: la capacidad de pensar más allá del «aquí y ahora» para detectar patrones y relaciones más matizados y de participar en un pensamiento complejo. El miércoles 11, investigadores de DeepMind, una filial de Google centrada en la inteligencia artificial, publicaron un artículo en el que describen su intento de medir la capacidad de razonamiento abstracto de diversas IA, para lo cual recurrieron a las mismas pruebas que utilizamos para medir la nuestra.
CI humano
En las personas, medimos el razonamiento abstracto mediante pruebas de CI visuales bastante sencillas. Una prueba muy conocida, llamada Matrices Progresivas de Raven, presenta varias filas de imágenes en las que a la última fila le falta su última imagen. Corresponde a quien realiza la prueba elegir la imagen que debería seguir, según el patrón de las filas completadas.
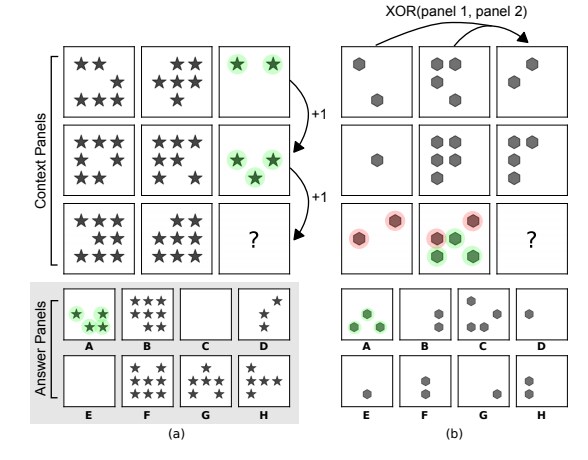
La prueba no indica explícitamente a quien la realiza qué debe buscar en las imágenes; quizá la progresión tenga que ver con el número de objetos en cada imagen, su color o su posición. Corresponde a la persona averiguarlo por sí misma mediante su capacidad de razonar de forma abstracta.
Para aplicar esta prueba a las IA, los investigadores de DeepMind crearon un programa capaz de generar problemas matriciales únicos. Después, entrenaron a diversos sistemas de IA para resolver estos problemas matriciales.
Finalmente, sometieron a prueba los sistemas. En algunos casos, utilizaron problemas de prueba con los mismos factores abstractos que el conjunto de entrenamiento, como entrenar y evaluar a la IA con problemas que requerían tener en cuenta el número de figuras en cada imagen. En otros casos, emplearon problemas de prueba que incorporaban factores abstractos distintos de los del conjunto de entrenamiento. Por ejemplo, podían entrenar a la IA con problemas que requerían tener en cuenta el número de figuras en cada imagen, pero después evaluarla con problemas que requerían considerar las posiciones de las figuras para encontrar la respuesta correcta.
Mejor suerte la próxima vez
Los resultados de la prueba no fueron muy buenos. Cuando los problemas de entrenamiento y los de prueba se centraban en los mismos factores abstractos, los sistemas se desempeñaron aceptablemente, respondiendo correctamente al 75 por ciento de los problemas. Sin embargo, las IA tuvieron un rendimiento muy deficiente cuando el conjunto de prueba era distinto del de entrenamiento, incluso cuando la variación era mínima (por ejemplo, entrenarlas con matrices que presentaban objetos de color oscuro y evaluarlas con matrices que presentaban objetos de color claro).
En última instancia, la prueba de CI para IA del equipo demuestra que incluso algunas de las IA más avanzadas de hoy no pueden resolver problemas para los que no las hemos entrenado. Eso significa que probablemente todavía estamos muy lejos de la IA general. Pero al menos ahora disponemos de una forma sencilla de seguir nuestro progreso.




