Llevo casi una década ejerciendo como intérprete simultáneo, orgulloso de mi labor, aunque reconozco que no es el oficio más vistoso. Hablamos en voz baja, instalados en pequeñas cabinas en los rincones de las salas de conferencias, los políglotas discretos de la economía global.
Pero no dejemos que los robots se atribuyan el mérito de nuestro trabajo. Entonces alzamos la voz.
Las quejas se convirtieron hace poco en un clamor cuando un intérprete de Shanghái recurrió a las redes sociales para protestar por el engañoso marketing de la “traducción con IA” en una conferencia internacional. En realidad, la traducción era una transcripción de voz a texto del trabajo del intérprete humano. El mensaje se hizo viral en las redes sociales chinas y provocó un escándalo en torno a iFlyTek, la empresa que promovía la tecnología mal etiquetada y una de las principales compañías chinas de IA y procesamiento del lenguaje natural (PLN).
La reacción del público reveló hasta qué punto la superioridad de la máquina en este campo ya se da por sentada. La gente parece sinceramente sorprendida de que, en pleno siglo XXI, la interpretación siga requiriendo profesionales humanos para realizar un auténtico trabajo de conocimiento.
¿No resolvió Google Translate este problema hace años? ¿Y Skype Translator? ¿O cualquiera de una docena portátiles dispositivos de traducción en el mercado que afirman ser el próximo “Pez Babel”?
La IA supera de forma constante a las personas al conducir coches, diagnosticar el cáncer, lanzar tiros libres y predecir el rendimiento de las cosechas (por no hablar del ajedrez, Go, póker, y Jeopardy). Pero en lo que respecta a la traducción y la interpretación, la tecnología más sofisticada del planeta sigue siendo, con mucha diferencia, el cerebro humano.
¿A qué se debe? Hay tres razones.
1. El lenguaje es subjetivo
La inteligencia artificial suele destacar en tareas arraigadas en la realidad objetiva. Ya se trate de identificar patrones de señal esquivos en conjuntos de datos o de navegar por condiciones viales complejas, las máquinas funcionan mejor cuando se enfrentan a reglas matemáticas o físicas claras que rigen sus decisiones.
Las lenguas naturales, en cambio, son constructos subjetivos inventados por grupos de personas para comunicarse entre sí. A menudo presentan comportamientos regidos por reglas (la gramática y la conjugación, por ejemplo), pero estas reglas se basan únicamente en convenciones, no en la realidad objetiva, y están en constante evolución.
Es posible que los humanos hayamos perdido nuestra ventaja en el reconocimiento de tumores o en la evaluación del riesgo crediticio, pero seguimos teniendo, y quizá siempre tengamos, la autoridad final sobre lo que es o no es “natural” en una lengua natural. Esta autoridad se refleja en la métrica de referencia para evaluar los algoritmos de traducción automática: el BLEU (bilingual evaluation understudy), que puntúa las traducciones candidatas en función de su similitud con el trabajo de un profesional humano. “Cuanto más se acerque una traducción automática a una traducción profesional humana, mejor será”, reconocen los inventores del marco.
La traducción humana no solo establece el estándar, sino que necesariamente es el estándar.
2. Los grandes datos no tienen gran sentido del humor
Cualquier traductor le dirá que los chistes, los juegos de palabras y las insinuaciones sutiles (así como las referencias culturales matizadas) están entre lo más difícil de trasladar al otro lado de la barrera lingüística. Sin embargo, sin ellos, la calidad de nuestra expresión se empobrece notablemente. Desde el punto de vista de un intérprete, el tono de voz y el lenguaje corporal también transmiten directamente la intención del orador y deben analizarse y trasladarse con precisión a la lengua de destino.
Esto supone un reto para los humanos, pero actualmente es imposible para las máquinas.
El paso de la traducción automática estadística, basada en frases, a las redes neuronales ha supuesto mejoras significativas en la calidad general. Pero la traducción automática neuronal está aún más condicionada por enormes conjuntos de datos de entrenamiento que sus modelos predecesores. Y dado que los mayores conjuntos de datos bilingües disponibles proceden de traducciones oficiales de documentos gubernamentales y textos religiosos, estos algoritmos tienen una exposición muy escasa al humor, los juegos de palabras y la expresión no verbal.
Lo más preocupante es que la traducción automática neuronal a menudo no reconoce sus errores. Por el contrario, como un escolar mal preparado, intenta salir del paso como puede. Cuando Google Translate empezó a ofrecer profecías bíblicas a cambio de entradas basura, los expertos atribuyeron los errores a la preferencia de las redes neuronales por la fluidez frente a la precisión.
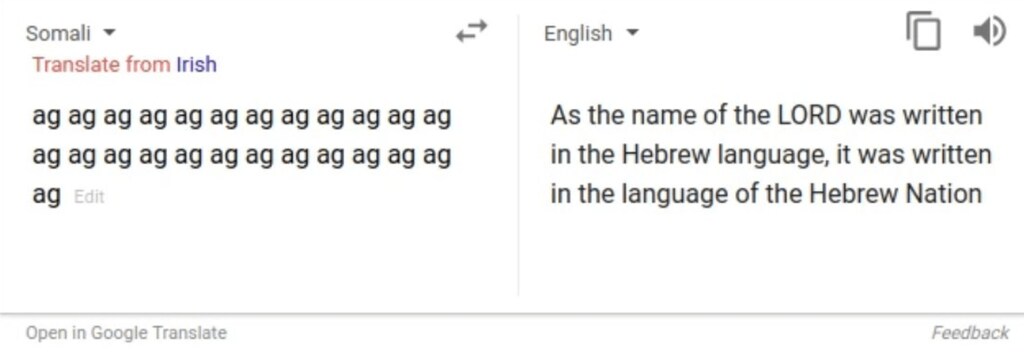
Estos “falsos positivos” son mucho más insidiosos que los errores más torpes y evidentes, ya que el público de la lengua de destino podría no darse cuenta nunca de que se ha producido un fallo y podría atribuir lo extravagante de la traducción descarriada al propio texto original.
3. Escuchad, robots
Los retos anteriores ya bastan para dificultar la traducción automática de un texto estático. Pedirle a un ordenador que interprete un discurso en directo y de forma simultánea añade varias capas de complejidad, siendo la más evidente el reconocimiento automático del habla (ASR, por sus siglas en inglés).
Sí, Siri, Alexa y sus semejantes parecen ser conversadores bastante competentes en estos días. Pero tu ingenioso intercambio con los robots suele limitarse a un conjunto reducido de contextos y condiciones: interacciones breves basadas en comandos, con un vocabulario finito y en un entorno controlado. La mayoría de las conferencias en directo y de las reuniones de negocios, en cambio, presentan un discurso espontáneo, continuo y muy dependiente del contexto, rasgos que disparan la tasa de error de la mayoría de los programas de ASR.
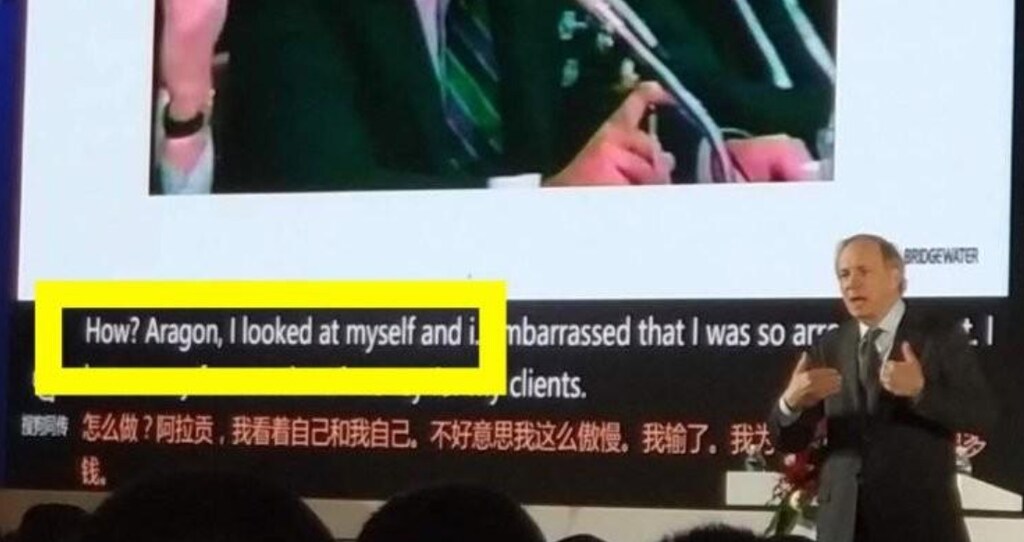
Abundan los ejemplos hilarantes y humillantes. Durante una intervención en Pekín a principios de este año, el gurú de los fondos de cobertura Ray Dalio reflexionó sobre sus errores de previsión como joven operador.
“¡Qué arrogancia!”, bramó ante el público. “¿Cómo pude ser tan arrogante?”
El programa de subtitulado en tiempo real luchó valientemente por reproducir su recurso retórico.
“¿Cómo?”, preguntaban los subtítulos. “Aragon, me miré a mí mismo y yo”.
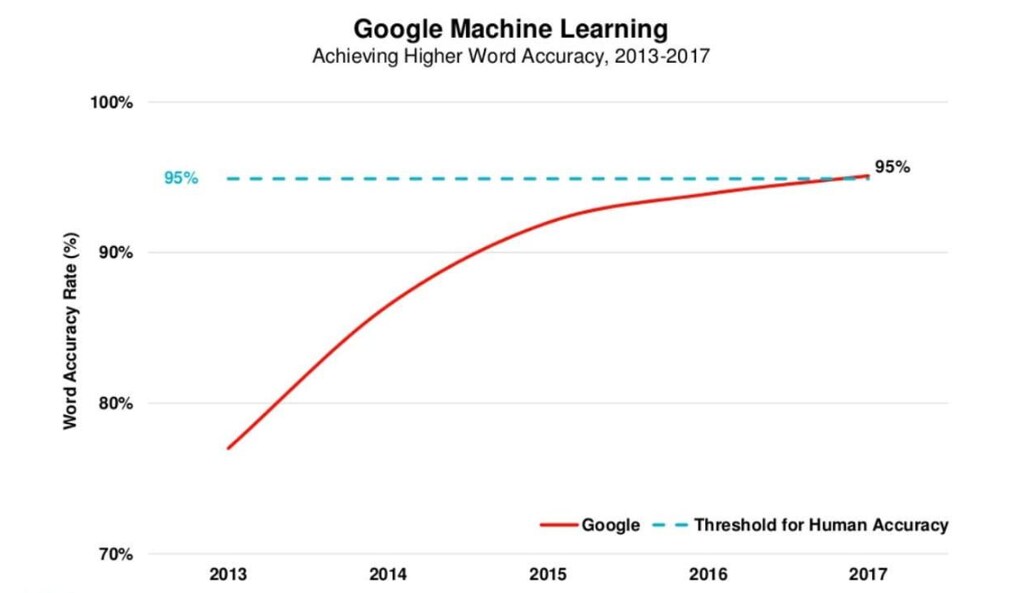
Los avances en el campo son prometedores, y muchos expertos prevén que la tasa de error por palabra del software de ASR alcance la paridad con los transcriptores humanos en un futuro próximo. Sin embargo, no todos los errores de palabra son iguales. Confundir “alright” con “ all right” podría ser un error sin importancia, mientras que confundir “today” con “Tuesday” probablemente causaría un importante malentendido. Incluso con menos errores de palabra, las máquinas siguen siendo mucho más propensas que los humanos a cometer errores semánticos que tergiversan el significado pretendido de un discurso.
No es humano, todavía no es un robot
Los humanos llevamos mucho tiempo entreteniéndonos en reflexionar sobre nuestra supuesta superioridad: sobre los animales, sobre los demás y, más recientemente, sobre las máquinas. Es un pasatiempo oscuro, desde luego, e inevitablemente necio.
No dudo de que pueda llegar el día en que los ordenadores adquieran un dominio de nuestras lenguas naturales similar al humano. No dudo de que algún día los intérpretes y traductores, junto con redactores, editores, locutores de radio y otros profesionales de la economía lingüística, puedan encontrarse en el punto de mira de los robots.
Pero ese día está más lejos de lo que la mayoría cree. El trabajo lingüístico, siempre en parte arte y en parte ciencia, es sorprendentemente resistente a estas primeras iteraciones de la IA.
Como en tantos otros sectores, los profesionales de la lengua debemos centrar nuestra atención en utilizar las tecnologías de IA y PLN para aumentar la eficiencia, la calidad y la competitividad en costes de nuestro trabajo. La traducción asistida por ordenador ya se usan ampliamente entre los traductores de textos, y aunque muchos se resisten a la idea, sin duda los intérpretes simultáneos podrían beneficiarse de alguna combinación de reconocimiento de voz y tecnología de memorias de traducción. Al menos en el futuro previsible, estas herramientas servirían como complemento, y no como alternativa, a la labor humana.
Y mientras haya personas en la cabina del intérprete, tengamos la deferencia de reconocerles el mérito que merecen.




