Una nueva generación de sistemas de acceso a la información basados en IA está transformando el modelo tradicional de los motores de búsqueda de internet.
Estos sistemas se basan en modelos de lenguaje de gran tamaño, una técnica de aprendizaje automático que utiliza un amplio conjunto de textos disponibles, como artículos de Wikipedia y PubMed, para aprender patrones.
Aunque ofrecen respuestas personalizadas y adaptadas, combinadas con la amplitud y profundidad del conocimiento en internet, tienen inconvenientes, advierte un científico de la información.
Entre ellos se incluyen la falta de precisión y de transparencia, y el posible menoscabo de la capacidad de aprendizaje de los usuarios, afirma.
El modelo predominante de acceso a la información antes de que los motores de búsqueda se convirtieran en la norma (bibliotecarios y expertos temáticos o en búsqueda que proporcionaban información pertinente) era interactivo, personalizado, transparente y autorizado. Hoy en día, los motores de búsqueda son el principal medio por el que la mayoría de las personas accede a la información, pero introducir unas pocas palabras clave y obtener una lista de resultados ordenada según alguna función desconocida no es lo ideal.
Una nueva generación de sistemas de acceso a la información basados en inteligencia artificial, que incluye Bing/ChatGPT de Microsoft, Bing/ChatGPT, Google/Bard y Meta/LLaMA, está transformando el modelo tradicional de búsqueda de los motores de búsqueda en cuanto a entrada y salida de consultas. Estos sistemas son capaces de recibir oraciones completas e incluso párrafos como entrada y generar respuestas personalizadas en lenguaje natural.

A primera vista, esto podría parecer lo mejor de ambos mundos: respuestas personalizadas y adaptadas, combinadas con la amplitud y profundidad del conocimiento en internet. Pero, como investigador que estudia los sistemas de búsqueda y recomendación, considero que, en el mejor de los casos, el panorama es mixto.
Sistemas de IA como ChatGPT y Bard se basan en modelos de lenguaje de gran tamaño. Un modelo de lenguaje es una técnica de aprendizaje automático que utiliza un amplio conjunto de textos disponibles, como artículos de Wikipedia y PubMed, para aprender patrones. En términos sencillos, estos modelos calculan qué palabra es probable que siga, dado un conjunto de palabras o una frase. Al hacerlo, son capaces de generar oraciones, párrafos e incluso páginas enteras que correspondan a una consulta de un usuario. El 14 de marzo de 2023, OpenAI anunció la siguiente generación de la tecnología, GPT-4, que funciona con entradas tanto de texto como de imagen, y Microsoft anunció que su Bing conversacional se basa en GPT-4.
Gracias al entrenamiento con grandes volúmenes de texto, al ajuste fino y a otros métodos basados en aprendizaje automático, este tipo de técnica de recuperación de información funciona bastante bien. Los sistemas basados en modelos de lenguaje de gran tamaño generan respuestas personalizadas para satisfacer las consultas de información. La gente ha quedado tan impresionada con los resultados que ChatGPT alcanzó los 100 millones de usuarios en un tercio del tiempo que TikTok tardó en llegar a ese hito. Las personas lo han utilizado no solo para encontrar respuestas, sino para generar diagnósticos, crear planes de dieta y hacer recomendaciones de inversión.
Opacidad y «alucinaciones»
Sin embargo, existen numerosos inconvenientes. En primer lugar, consideremos qué hay en el núcleo de un modelo de lenguaje de gran tamaño: un mecanismo mediante el cual conecta las palabras y, presumiblemente, sus significados. Esto produce un resultado que a menudo parece una respuesta inteligente, pero los sistemas de modelos de lenguaje de gran tamaño son conocidos por producir afirmaciones casi repetidas de forma mecánica sin una comprensión real. Por tanto, aunque el resultado generado por estos sistemas pueda parecer inteligente, no es más que un reflejo de los patrones subyacentes de palabras que la IA ha encontrado en un contexto apropiado.
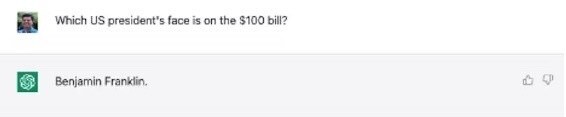
Esta limitación hace que los sistemas de modelos de lenguaje de gran tamaño sean susceptibles de inventar o «alucinar» respuestas. Además, los sistemas no son lo bastante inteligentes como para comprender la premisa incorrecta de una pregunta y, de todos modos, responden a preguntas erróneas. Por ejemplo, cuando se le pregunta qué presidente de EE. UU. aparece en el billete de 100 dólares, ChatGPT responde Benjamin Franklin sin darse cuenta de que Franklin nunca fue presidente y de que la premisa de que el billete de 100 dólares lleva la imagen de un presidente de EE. UU. es incorrecta.
El problema es que, incluso cuando estos sistemas se equivocan solo el 10 % de las veces, no se sabe cuál es ese 10 %. Además, las personas no tienen la capacidad de validar rápidamente las respuestas de los sistemas. Esto se debe a que estos sistemas carecen de transparencia: no revelan con qué datos se entrenan, qué fuentes han utilizado para elaborar las respuestas ni cómo se generan dichas respuestas.
Por ejemplo, se podría pedir a ChatGPT que redacte un informe técnico con citas. Sin embargo, a menudo inventa estas citas («alucinando» los títulos de artículos académicos, así como los autores). Además, los sistemas no validan la precisión de sus respuestas. Esto deja la validación en manos del usuario, quien puede no tener la motivación o las habilidades necesarias para hacerlo, o incluso no reconocer la necesidad de verificar las respuestas de una IA.
Robo de contenido y de tráfico
Si bien la falta de transparencia puede resultar perjudicial para los usuarios, también es injusta para los autores, artistas y creadores del contenido original del que los sistemas han aprendido, ya que estos no revelan sus fuentes ni ofrecen una atribución suficiente. En la mayoría de los casos, los creadores no reciben compensación ni reconocimiento ni tienen la oportunidad de dar su consentimiento.
Esto también tiene una vertiente económica. En un entorno típico de motor de búsqueda, los resultados se muestran junto con los enlaces a las fuentes. Esto no solo permite al usuario verificar las respuestas y proporciona la atribución a dichas fuentes, sino que también genera tráfico para esos sitios. Muchas de estas fuentes dependen de este tráfico para sus ingresos. Dado que los sistemas de modelos de lenguaje de gran tamaño producen respuestas directas, pero no las fuentes en las que se basan, considero que es probable que los ingresos de esos sitios disminuyan.
Pérdida de aprendizaje y serendipia
Por último, esta nueva forma de acceder a la información también puede restar capacidad a las personas y eliminar su oportunidad de aprender. Un proceso de búsqueda típico permite a los usuarios explorar el abanico de posibilidades de sus necesidades de información, lo que a menudo les lleva a ajustar lo que buscan. También les ofrece una oportunidad de aprender qué hay disponible y cómo se conectan diversas piezas de información para cumplir sus tareas. Y permite encuentros fortuitos o serendipia.
Estos aspectos son muy importantes en la búsqueda, pero cuando un sistema produce resultados sin mostrar sus fuentes ni guiar al usuario a lo largo de un proceso, le priva de estas posibilidades.
Los modelos de lenguaje de gran tamaño suponen un gran avance para el acceso a la información, al ofrecer a las personas una forma de interactuar mediante lenguaje natural, generar respuestas personalizadas y descubrir respuestas y patrones que a menudo son difíciles de encontrar para un usuario medio. Sin embargo, presentan graves limitaciones debido a la forma en que aprenden y construyen respuestas. Sus respuestas pueden ser erróneas, tóxicas o sesgadas.
Aunque otros sistemas de acceso a la información también pueden padecer estos problemas, los sistemas de IA basados en modelos de lenguaje de gran tamaño también carecen de transparencia. Peor aún, sus respuestas en lenguaje natural pueden alimentar un falso sentido de confianza y autoridad que puede resultar peligroso para los usuarios no informados.




