El sesgo es un rasgo inherente al ser humano y puede reflejarse e incorporarse en todo lo que creamos, especialmente en lo que respecta a la tecnología.
La ciencia de datos de código abierto podría ayudar a abordar el problema del sesgo en el desarrollo de la inteligencia artificial (IA).
Adoptar un enfoque abierto y colaborativo de la ciencia de datos puede allanar el camino hacia un mundo más justo y equitativo al reducir el sesgo en la IA.
En su libro Don’t Think of an Elephant, el lingüista y filósofo George Lakoff sostiene que: «Los marcos son estructuras mentales que moldean la forma en que vemos el mundo. Como resultado, moldean los objetivos que perseguimos, los planes que hacemos, la forma en que actuamos y lo que se considera un resultado bueno o malo de nuestras acciones».
En este sentido, los sesgos pueden actuar como un marco inherente para los seres humanos y están presentes en la vida real. A continuación, algunos ejemplos:
Un estudio reciente identificó sesgos en el conjunto de datos de los sensores de oximetría de pulso, que estiman la cantidad de oxígeno en la sangre de una persona. En los pacientes negros, los sensores no medían ni detectaban con precisión la baja oxigenación de la sangre, lo que podía aumentar el riesgo de hipoxemia, un nivel de oxígeno por debajo de lo normal. De hecho, el estudio mostró que los pacientes negros presentaban casi tres veces más frecuencia de hipoxemia oculta no detectada por la oximetría de pulso que los pacientes blancos.
En un novedoso experimento de solicitud de préstamos realizado por el Banco Mundial en 77 bancos turcos, el 35 % de los responsables de préstamos tenía sesgos contra las solicitantes mujeres, y las mujeres recibían importes de préstamo de 14 000 dólares menos, en promedio, en comparación con los hombres.
El debate sobre «naturaleza frente a crianza» es un tema de larga data, especialmente cuando se trata del sesgo humano. Y, aunque la respuesta no es sencilla, una cosa es segura: todos somos sesgados e incorporamos esos mismos sesgos en casi todo lo que creamos.
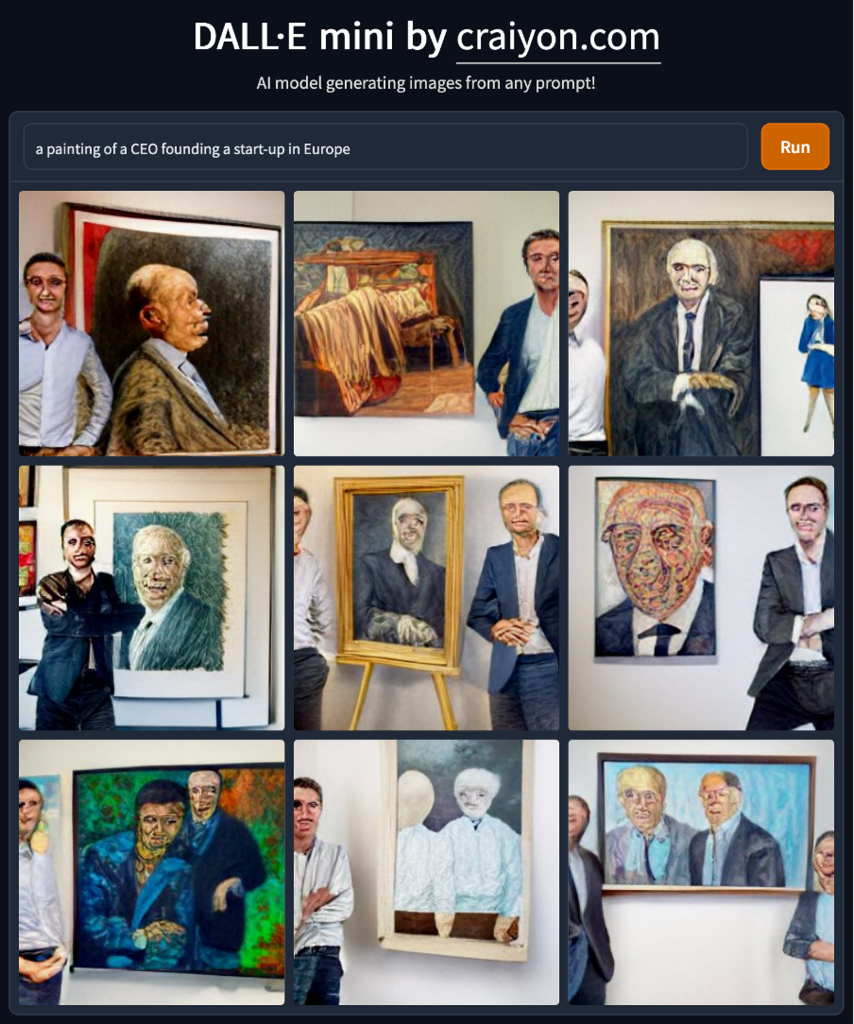
El sesgo puede encontrarse incluso en la tecnología, concretamente en la inteligencia artificial (IA). Observe lo que genera DALL-E mini cuando se le pide representar una «pintura de un director ejecutivo fundando una startup en Europa» y cuente cuántas mujeres ve.
Lakoff añade: «Cambiar nuestros marcos es cambiar todo esto. Replantear los marcos es cambio social».
Según el modelo de sesgo basado en marcos, abordar el sesgo en la IA es, por tanto, clave para transformar la sociedad mediante un enfoque nuevo, ético y responsable de la tecnología. Es necesario, entonces, señalar el gran «elefante en la habitación», que siempre ha estado ahí, aunque se haya ignorado, y hacerle frente.
Inteligencia artificial y sesgo
El sesgo en la IA se produce cuando la máquina ofrece resultados sistemáticamente distintos para un grupo de personas en comparación con otro, como se describió en el ejemplo anterior sobre la oxigenación de la sangre.
Por lo general, estos resultados sesgados siguen sesgos sociales clásicos como la raza, el género, el sexo biológico, la nacionalidad o la edad.
El sesgo en los algoritmos de IA puede proceder de datos de entrenamiento no representativos o incompletos, o del uso de información errónea que refleja desigualdades históricas. Si no se controla, los algoritmos sesgados pueden dar lugar a decisiones con un impacto colectivo y desigual en determinados grupos de personas, incluso sin la intención discriminatoria del programador.
Nicol Turner Lee, Paul Resnick y Genie Barton, en un artículo para la Brookings Institution
El reconocimiento facial y los sesgos raciales en la atención sanitaria son dos ejemplos clásicos. Los datos utilizados para entrenar estos sistemas carecen de ejemplos de personas de piel oscura, por lo que realizan un trabajo deficiente al reconocer a personas de color. Si introduce datos malos y deficientes datos, obtendrá datos malos y deficientes.
El factor humano en el sesgo de la IA
Cuando hablamos de IA, hablamos de personas. Los humanos diseñan los algoritmos de IA y, además, siguen siendo los principales beneficiarios de todas las aplicaciones de IA que utilizamos a diario.
Por ello, deberíamos empezar a considerar la IA sesgada no solo como un problema tecnológico, sino como un problema humano, y adoptar así una nueva perspectiva.
En lo que respecta al sesgo algorítmico, hay que abordar dos cuestiones principales: los datos y la definición del éxito. ¿Están completos los datos disponibles? ¿Son representativos de todas las personas? Si no es así, la predicción que haga el algoritmo será inevitablemente sesgada.
Pero, en realidad, el verdadero problema es que nosotros, como seres humanos y como responsables del diseño de los sistemas de IA, estamos sesgados de forma natural e inconsciente. Y eliminar los sesgos humanos es más difícil que eliminar los de los sistemas de IA.
La apertura y la colaboración son la respuesta
La respuesta a esto podría estar en la ciencia de datos de código abierto (OSDS, por sus siglas en inglés), que está madurando y transformando el ámbito de la ciencia de datos. Del mismo modo que el software de código abierto ha revolucionado el mundo del software al abrir el código a una comunidad de desarrolladores, la OSDS puede hacer lo mismo en el ámbito de la ciencia de datos, abriendo los modelos y los datos con los que han sido entrenados.
Hugging Face, por ejemplo, es un gran ejemplo de empresa basada en la apertura y la colaboración. Tras abrir el código del modelo que sustenta su tecnología, un chatbot, se convirtió en una plataforma para democratizar el aprendizaje automático.
Pero ¿qué pasaría si la OSDS pudiera utilizarse, además de para la colaboración, la atracción de talento y la apertura, para mitigar el sesgo?
Cómo la ciencia de datos de código abierto puede reducir el sesgo en la IA
Consideremos, a modo de ejemplo, dos empresas que utilizan el reconocimiento facial para dos usos distintos: uno para el diagnóstico de enfermedades y recomendaciones de moda.
Estas empresas, sin duda, no serían competidoras. Sin embargo, hoy en día, es muy probable que ambas estén desarrollando en paralelo una parte crucial de su sistema, el reconocimiento facial. Esto implica trabajo duplicado y un desperdicio del tiempo y del dinero de los científicos de datos.
En un mundo de OSDS, ambas empresas trabajarían en un proyecto abierto de detección facial, aportando código y datos para ayudar a combatir los casos límite y crear una solución más robusta. Al hacerlo, podrían dedicar menos científicos de datos a la tarea en comparación con la situación actual, y centrarlos en problemas más complejos y críticos.
Los científicos de datos que deseen aprender, contribuir y mostrar sus habilidades para mejorar su portafolio participarían para identificar errores e ineficiencias, y crear modelos alternativos que prioricen diversas métricas para distintos casos de uso, como se ve en el proyecto Ethical AI Community, creado para apoyar a Responseable.ai, o en otras iniciativas como Open Future.
La colaboración, clave para una IA más orientada a la ética
Un tema emergente en el ámbito de la IA es el creciente reconocimiento de la importancia y el interés por resolver los problemas relacionados con los sesgos y la equidad. La OSDS puede ser una parte fundamental de la solución para corregir este preocupante fenómeno.
Por ejemplo, los usuarios pueden acceder a conjuntos de datos y encontrar errores en los datos, como la falta de datos sobre minorías infrarrepresentadas. A continuación, los colaboradores pueden ayudar a «corregir» el conjunto de datos aportando puntos de datos adecuados, o incluso iniciar campañas de externalización abierta (crowdsourcing) para contribuir a ellos y eliminar los sesgos existentes en el conjunto de datos.
En resumen, los beneficios de la OSDS son:
Poner recursos de alta calidad al alcance de la comunidad en general
Resolver el problema de la reproducibilidad, mediante la creación de proyectos fiables de ciencia de datos de código abierto para obtener mejores resultados, modelos más justos y un rendimiento más fiable
Un uso más eficiente de los científicos de datos en los distintos proyectos
Garantizar un impacto positivo en la transparencia, la diversidad y la inclusión de la IA
Del mismo modo que el cubismo supuso un enfoque revolucionario para representar la realidad desde distintas perspectivas de los sujetos en una misma imagen, la OSDS reúne distintas perspectivas, ángulos y puntos de vista de una misma realidad, al mismo tiempo que permite un modelo más representativo e inclusivo.
Gracias a la apertura y la colaboración, la ciencia de datos de código abierto, lejos de ser la única respuesta para una IA más orientada a la ética, puede ayudar a reducir el sesgo y aportar más justicia y equidad al mundo.




