La investigación más reciente de OpenAI puso a sus agentes de aprendizaje automático en un sencillo juego del escondite, en el que persiguieron una carrera armamentística de ingenio, utilizando objetos de formas inesperadas para alcanzar su objetivo de ver o ser vistos. Este tipo de IA autodidacta podría resultar útil también en el mundo real.
El estudio pretendía, y logró, analizar la posibilidad de que los agentes de aprendizaje automático aprendieran técnicas sofisticadas y relevantes para el mundo real sin ninguna interferencia de sugerencias de los investigadores.
Tareas como identificar objetos en fotos o inventar rostros humanos verosímiles son difíciles y útiles, pero no reflejan realmente las acciones que se podrían realizar en el mundo real. Son, podría decirse, muy intelectuales y, en consecuencia, pueden llevarse a un alto nivel de eficacia sin salir nunca del ordenador.
Mientras que intentar entrenar a una IA para usar un brazo robótico para agarrar una taza y colocarla en un platillo es mucho más difícil de lo que uno podría imaginar (y solo se ha logrado en circunstancias muy específicas), la complejidad del mundo físico real hace que el aprendizaje puramente intelectual y confinado al ordenador de estas tareas sea prácticamente imposible.
Al mismo tiempo, existen tareas intermedias que no reflejan necesariamente el mundo real por completo, pero que aún pueden ser relevantes para él. Una sencilla podría ser cómo cambiar la orientación de un robot cuando se le presentan varios objetos o personas relevantes. No se necesitan mil pruebas físicas para saber que debe girarse a sí mismo o girar la cámara para poder ver ambos, o alternar entre ellos, o lo que sea.
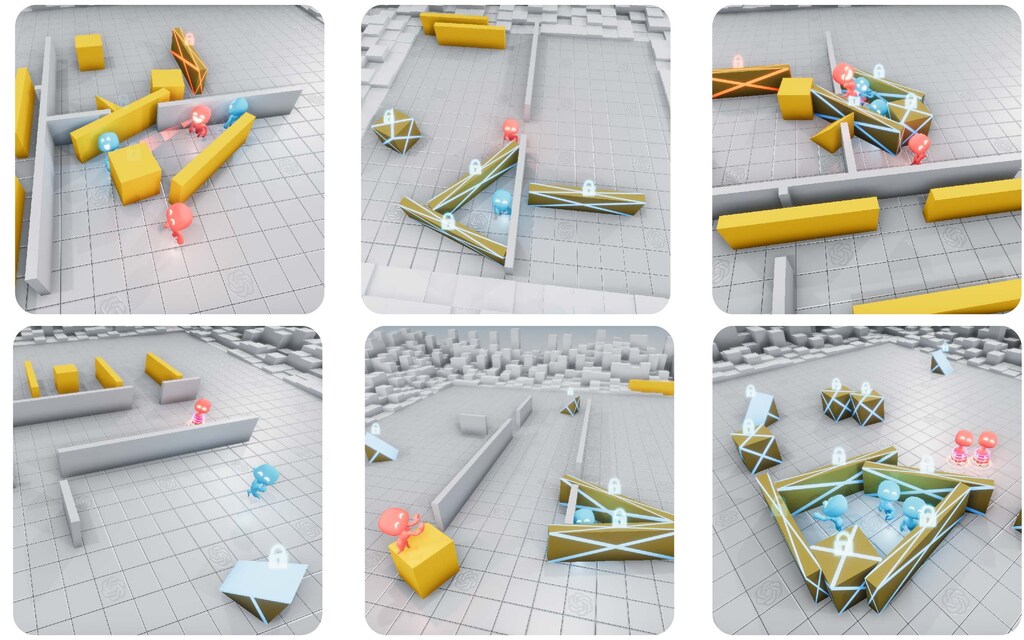
El desafío del escondite de OpenAI para sus agentes de ML incipientes siguió estas líneas: un entorno de juego con reglas sencillas (llamado Polyworld) que, no obstante, utiliza una física y unas entradas cercanas a las del mundo real. Si las IA pueden aprender por sí mismas a desenvolverse en esta realidad simplificada, quizá puedan transferir esas habilidades, con algunas modificaciones, a la realidad plena.
Tal es, en cualquier caso, la lógica detrás del experimento, pero resulta suficientemente entretenido por sí mismo. El juego enfrenta a dos equipos en una pequeña arena 3D poblada con algunos muros y objetos generados aleatoriamente. Varios agentes aparecen en ella y a los «que se esconden» se les dan unos segundos para familiarizarse con el entorno y esconderse. También pueden interactuar con los objetos, empujándolos y bloqueándolos en su sitio. Una vez que el «buscador» levanta la vista, dispone de un tiempo determinado para localizar a los que se esconden.
Lo único que se le indicó al programa de aprendizaje automático fueron los sentidos básicos —cada agente tiene una visión del mundo y una especie de «lidar» que le indica la posición de los objetos cercanos— y el conocimiento de que puede mover objetos. Más allá de eso, simplemente se le otorgaba un punto cuando tenía éxito en su tarea, ya fuera buscando o escondiéndose; esa es su motivación.
De estos inicios básicos surgieron resultados maravillosamente interesantes. Al principio, los equipos se movían esencialmente al azar. Pero a lo largo de millones de partidas, quienes se escondían descubrieron que, moviéndose de cierta manera —«a lo bruto», huyendo—, podían aumentar sus puntos con más frecuencia. Y así comenzó la carrera armamentística.
Como quienes se escondían huían, los buscadores empezaron a desarrollar comportamientos de persecución más estructurados. Pero entonces llegaron las herramientas.
Quienes se escondían descubrieron que podían empujar y arrastrar objetos por el campo, y comenzaron a construir fortines con ellos.
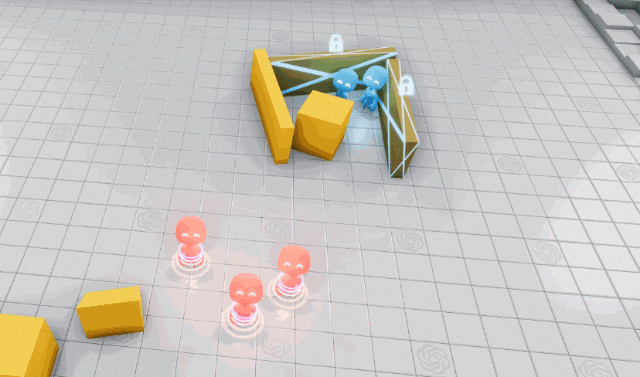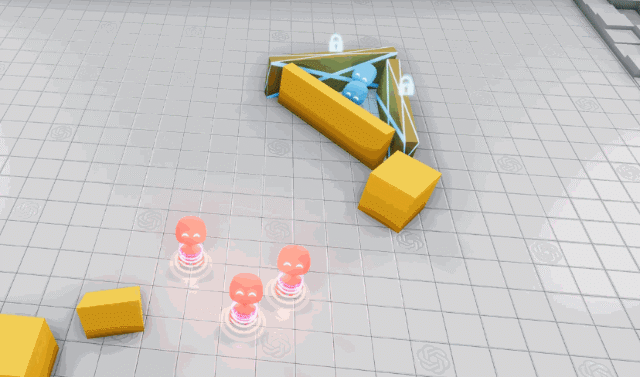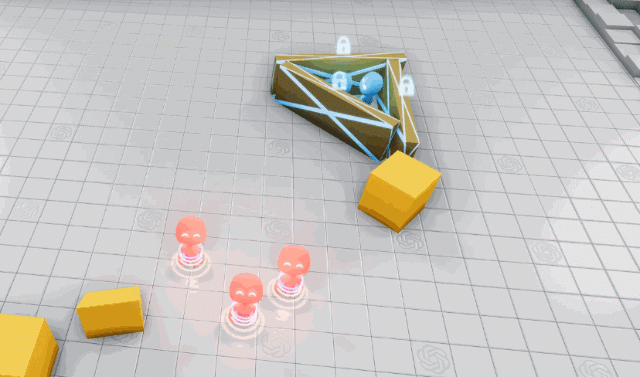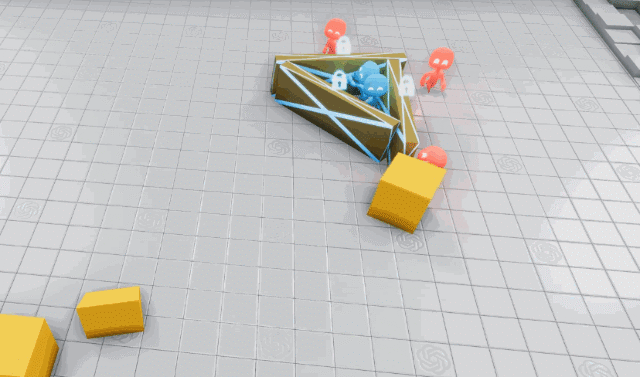
Los buscadores respondieron usando las rampas que encontraban en el campo para subir sobre los objetos y derribar los fortines.
Quienes se escondían empezaron a buscar rampas mientras los buscadores aún contaban, y o bien se las robaban o las bloqueaban en su sitio (el bloqueo no puede deshacerse por un agente del equipo contrario). Curiosamente, esto implicó cierta división del trabajo, porque a menudo no había tiempo suficiente para que ambos escondidos salieran a buscar rampas; uno tenía que preparar el fortín mientras el otro patrullaba en busca de rampas.
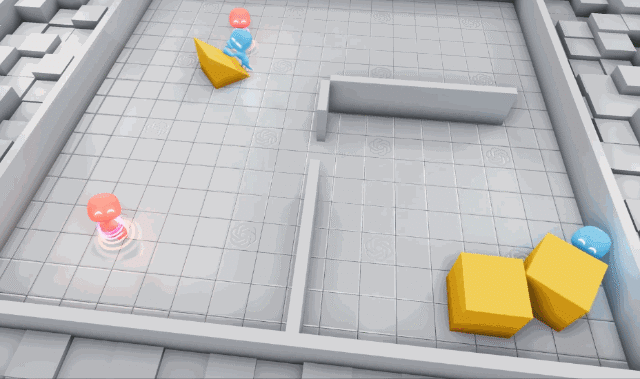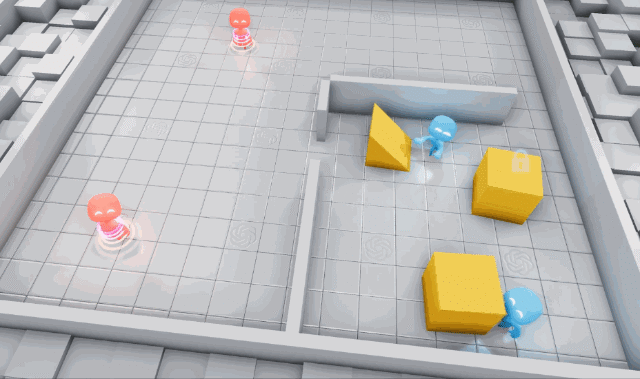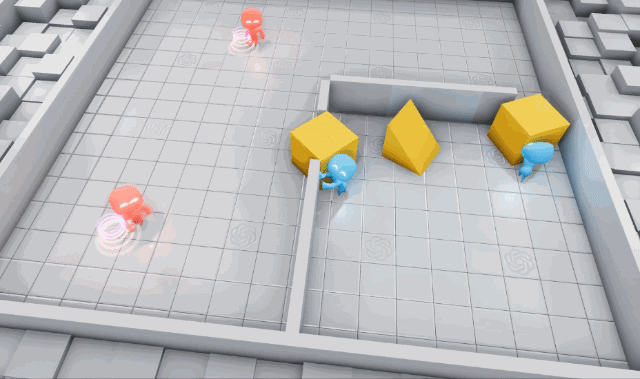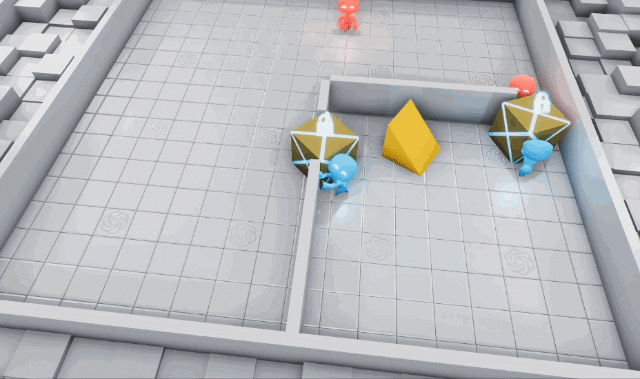
El equipo de OpenAI pensó que quizá eso era el final, pero los buscadores aprendieron a aprovechar una característica no prevista del mundo del juego. Descubrieron que podían «empujar» una caja mientras viajaban encima de ella, lo que significaba que podían colocarla cerca de una rampa, subirse a ella y luego «surfearla» por todo el campo para dar con esos traviesos escondidos.

Por supuesto, quienes se escondían respondieron bloqueando todos los objetos que no estaban usando para construir su fortín, y parece que ese es el límite de la estrategia en este juego.
Entonces, ¿cuál es el sentido? Según explican los autores del artículo, así es más o menos como nosotros surgimos.
La inmensa complejidad y diversidad de la Tierra evolucionaron gracias a la coevolución y a la competencia entre organismos, dirigidas por la selección natural. Cuando surge una nueva estrategia o mutación exitosa, cambia la distribución implícita de tareas que deben resolver los agentes vecinos y genera una nueva presión para la adaptación. Estas carreras armamentísticas evolutivas crean autocurrículos implícitos mediante los cuales los agentes en competencia generan continuamente nuevas tareas unos para otros.
Inducir autocurrículos en entornos físicamente fundamentados y abiertos podría permitir, con el tiempo, que los agentes adquieran un número ilimitado de habilidades relevantes para los humanos.
En otras palabras, hacer que los modelos de IA compitan de forma no supervisada podría ser una manera mucho mejor de desarrollar habilidades útiles y sólidas que dejarlos deambular por su cuenta, acumulando una cifra abstracta como el porcentaje de entorno explorado o algo similar.
Cada vez es más difícil, o incluso imposible, que los humanos dirijan cada aspecto de las capacidades de una IA parametrizándola y controlando las interacciones que tiene con el entorno. En tareas complejas, como que un robot navegue por un entorno abarrotado, hay tantos factores que el hecho de que los humanos diseñen los comportamientos quizá nunca produzca el tipo de sofisticación necesaria para que estos agentes ocupen su lugar en la vida cotidiana.
Pero pueden enseñarse unos a otros, como hemos visto aquí y en las GAN, donde un par de IA enfrentadas trabajan para vencerse mutuamente en la creación o detección de medios realistas. Los investigadores de OpenAI sostienen que los «autocurrículos multiagente», o agentes que se autoenseñan, son el camino a seguir en muchas circunstancias en las que otros métodos son demasiado lentos o estructurados. Concluyen:
“Estos resultados inspiran confianza en que, en un entorno más abierto y diverso, las dinámicas multiagente podrían dar lugar a comportamientos extremadamente complejos y relevantes para los humanos.”
Algunas partes de la investigación se han publicado como código abierto. Puedes leer el artículo completo que describe el experimento aquí.




