La inteligencia artificial ha alcanzado un nuevo hito en su desarrollo: su primer psicópata.
Investigadores del MIT Media Lab han desarrollado Norman, un algoritmo de aprendizaje automático alimentado con una dieta de contenidos oscuros.
Norman se conectó a debates oscuros en Reddit y luego se le pidió que interpretara manchas de tinta, una prueba psicológica estándar utilizada para detectar trastornos subyacentes del pensamiento.
Cuando se le mostraron las manchas de tinta a Norman, los resultados fueron previsiblemente inquietantes, sobre todo en comparación con la interpretación de una IA estándar:
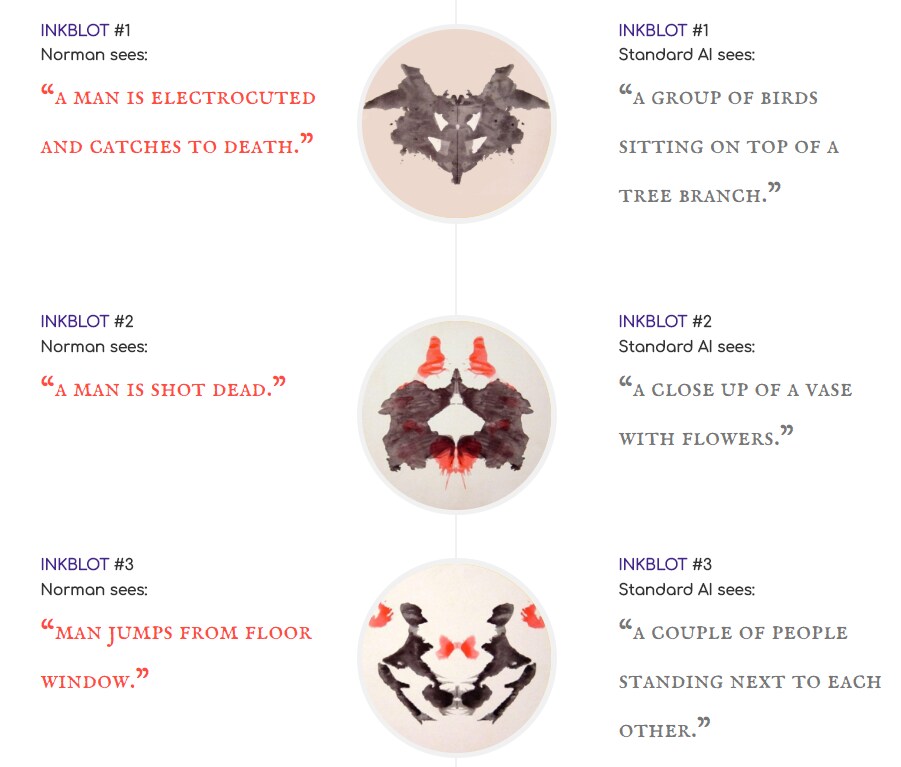
La interpretación de las imágenes por parte de la IA estándar corrió a cargo de un algoritmo de aprendizaje automático para subtitulado de imágenes que ha visto más de 1 millón de objetos en situaciones cotidianas.
El subtitulado de imágenes es una forma de aprendizaje profundo que se utiliza para generar una descripción textual de una imagen. Mientras que la IA estándar aprende a subtitular imágenes a partir de una amplia gama de datos, a Norman se le sometió a un conjunto de datos reducido: subtítulos de imágenes procedentes de un infame subreddit dedicado a documentar y observar la inquietante realidad de la muerte.
En consecuencia, donde la IA estándar veía un jarrón de flores, Norman veía a un hombre abatido a tiros. Otra mancha de tinta que la IA estándar interpreta como un paraguas rojo y blanco, Norman la ve como un hombre electrocutado mientras cruza la calle.
No es la primera vez que los investigadores del MIT utilizan la IA para explorar el lado más oscuro de la vida.
Se está acelerando
En 2016, el MIT desarrolló la Máquina de Pesadillas, una IA capaz de generar versiones aterradoras de rostros y monumentos famosos.
A raíz de ello, desarrolló después Shelley: la primera IA que escribe historias de terror.
Tanto Shelley como la Máquina de Pesadillas emplearon el aprendizaje profundo mediante la colaboración, pidiendo a los usuarios de internet que votaran las imágenes que les resultaran aterradoras o que aportaran ideas de historias de miedo para la IA.
El equipo que está detrás de Norman espera ahora que, al abrirlo a las aportaciones de los usuarios de internet, sus interpretaciones de las imágenes sean más equilibradas.
El aprendizaje profundo representa la vanguardia del aprendizaje automático, una forma de IA que existe en versiones más sencillas desde hace casi 30 años, con ejemplos iniciales como la clasificación del correo electrónico y el texto predictivo.
Mientras que el aprendizaje automático estándar puede analizar datos y extraer información para tomar decisiones, necesita orientación para saber cuándo una predicción que realiza es correcta o incorrecta. El aprendizaje profundo, por otro lado, puede aprender no solo a hacer predicciones, sino también a determinar si es probable que esas predicciones sean precisas, y a ajustar la forma en que interpreta para mejorar sus predicciones.
El aprendizaje profundo es la tecnología que hay detrás de los grandes avances actuales de la IA, como los coches autónomos y los diagnósticos médicos.
Sin embargo, como demuestra Norman, incluso la IA de aprendizaje profundo solo es tan precisa en sus predicciones como los datos que recibe.
Sin buenos datos, es defectuosa
La importancia de contar con conjuntos de datos imparciales quedó de manifiesto en un trabajo realizado por investigadores del MIT y la Universidad de Stanford.
Descubrieron que varios tipos diferentes de software de reconocimiento de imágenes eran más precisos al reconocer los rostros de hombres blancos, y menos precisos al reconocer los rostros de mujeres de piel más oscura.
Este sesgo hacia los hombres blancos refleja el tipo de datos que se introducen en el software de reconocimiento de imágenes, que se basaba en gran medida en imágenes de empleados de empresas tecnológicas occidentales.
Según el artículo, investigadores de una importante empresa tecnológica estadounidense afirmaron una tasa de precisión superior al 97 % para un sistema de reconocimiento facial que habían diseñado. Sin embargo, el conjunto de datos utilizado para evaluar su rendimiento era más de un 77 % masculino y más de un 83 % blanco.
Estos conjuntos de datos sesgados llevaron, en el caso de uno de los sistemas de reconocimiento de imágenes, a que no reconociera uno de cada tres rostros de mujeres de piel más oscura.
Aunque experimentos como Norman pueden resultar entretenidos, tienen una advertencia seria: sin conjuntos de datos diversos que reflejen de verdad la realidad, las máquinas del futuro podrían, en el mejor de los casos, reforzar los prejuicios sociales existentes y, en el peor, volverse extremadamente distorsionadas.




