Tres programas de análisis facial comercializados por importantes empresas tecnológicas presentan sesgos tanto por el tipo de piel como por el género, según un nuevo estudio que investigadores del MIT y la Universidad de Stanford presentarán a finales de este mes en la Conferencia sobre Equidad, Responsabilidad y Transparencia.
En los experimentos de los investigadores, las tasas de error de los tres programas al determinar el género de hombres de piel clara nunca superaron el 0,8 %. En cambio, en el caso de las mujeres de piel más oscura, las tasas de error se dispararon: superaron el 20 % en un caso y el 34 % en los otros dos.
Los hallazgos plantean interrogantes sobre cómo se entrenan y evalúan las redes neuronales actuales, que aprenden a realizar tareas computacionales al buscar patrones en enormes conjuntos de datos. Por ejemplo, según el estudio, investigadores de una importante empresa tecnológica estadounidense afirmaron que el sistema de reconocimiento facial que habían diseñado tenía una tasa de precisión superior al 97 %. Sin embargo, el conjunto de datos utilizado para evaluar su rendimiento estaba compuesto en más de un 77 % por hombres y en más de un 83 % por personas blancas.
«Lo realmente importante aquí es el método y cómo se aplica a otras áreas», afirma Joy Buolamwini, investigadora del grupo Civic Media del Media Lab del MIT y primera autora del nuevo estudio. «Las mismas técnicas centradas en los datos que pueden utilizarse para intentar determinar el género de alguien también se usan para identificar a una persona cuando se busca a un sospechoso de un delito o para desbloquear el teléfono. Y no se trata solo de visión artificial. Tengo muchas esperanzas de que esto impulse más investigaciones sobre otras disparidades».
Timnit Gebru, entonces estudiante de posgrado en Stanford cuando se realizó el trabajo y ahora investigadora posdoctoral en Microsoft Research, también es coautora del estudio junto con Buolamwini.
Descubrimientos fortuitos
Los tres programas que Buolamwini y Gebru investigaron eran sistemas de análisis facial de propósito general, capaces de comparar rostros en distintas fotografías y de evaluar características como el género, la edad y el estado de ánimo. Los tres sistemas trataban la clasificación de género como una decisión binaria —hombre o mujer—, lo que facilitaba especialmente la evaluación estadística de su rendimiento en esa tarea. Sin embargo, es probable que los mismos tipos de sesgo afecten también al rendimiento de los programas en otras tareas.
De hecho, la investigación de Buolamwini comenzó después de que descubriera por casualidad un aparente sesgo en el seguimiento facial de uno de los programas.
Hace varios años, cuando era estudiante de posgrado en el Media Lab, Buolamwini trabajaba en un sistema llamado Upbeat Walls, una instalación artística interactiva y multimedia que permitía a los usuarios controlar, moviendo la cabeza, patrones coloridos proyectados sobre una superficie reflectante. Para seguir los movimientos del usuario, el sistema utilizaba un programa comercial de análisis facial.
El equipo que Buolamwini reunió para trabajar en el proyecto tenía diversidad étnica, pero los investigadores descubrieron que, al presentar el dispositivo en público, tenían que recurrir a uno de los integrantes de piel más clara para hacer una demostración. El sistema simplemente no parecía funcionar de manera fiable con usuarios de piel más oscura.
Movida por la curiosidad, Buolamwini, que es negra, empezó a enviar fotos suyas a programas comerciales de reconocimiento facial. En varios casos, los programas ni siquiera reconocieron que las fotos mostraban un rostro humano. Cuando sí lo hacían, clasificaban sistemáticamente mal el género de Buolamwini.
Estándares cuantitativos
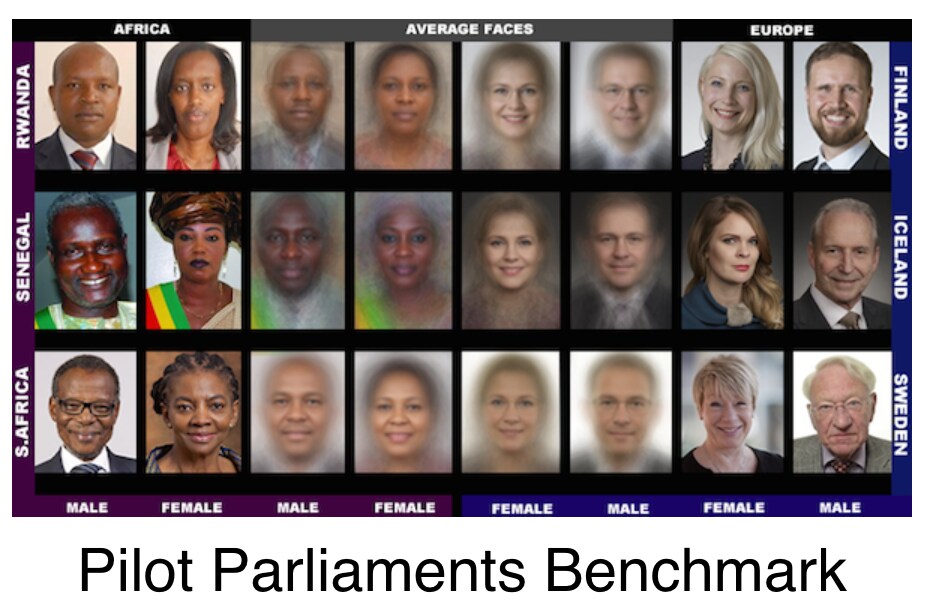
Para empezar a investigar sistemáticamente los sesgos de los programas, Buolamwini reunió primero un conjunto de imágenes en el que las mujeres y las personas de piel oscura estaban mucho mejor representadas que en los conjuntos de datos que suelen utilizarse para evaluar los sistemas de análisis facial. El conjunto final contenía más de 1.200 imágenes.
A continuación, trabajó con un cirujano dermatológico para codificar las imágenes según la escala de tonos de piel de Fitzpatrick, una escala de seis puntos, de claro a oscuro, desarrollada originalmente por dermatólogos para evaluar el riesgo de quemaduras solares.
Después, aplicó tres sistemas comerciales de análisis facial de importantes empresas tecnológicas al conjunto de datos que acababa de crear. En los tres, las tasas de error en la clasificación de género fueron sistemáticamente más altas para las mujeres que para los hombres, y para las personas de piel más oscura que para las de piel más clara.
En el caso de las mujeres de piel más oscura —aquellas clasificadas con los niveles IV, V o VI de la escala de Fitzpatrick—, las tasas de error fueron del 20,8 %, el 34,5 % y el 34,7 %. Sin embargo, en dos de los sistemas, las tasas de error fueron aún mayores para las mujeres de piel más oscura del conjunto de datos —las clasificadas con el nivel VI—: 46,5 % y 46,8 %. En esencia, para esas mujeres, el sistema bien podría haber estado adivinando el género al azar.
«Cuando un sistema comercial falla en uno de cada tres casos en una tarea reducida a una clasificación binaria, hay que preguntarse si eso se habría permitido de haberse registrado esas tasas de error en otro subgrupo», afirma Buolamwini. «La otra gran lección... es que nuestros parámetros de referencia, los estándares con los que medimos el éxito, pueden darnos una falsa impresión de progreso».
«En este ámbito, los conjuntos de datos influyen mucho en lo que le ocurre al modelo», afirma Ruchir Puri, arquitecto jefe del sistema de inteligencia artificial Watson de IBM. «Acabamos de presentar un nuevo modelo mucho más equilibrado en cuanto a precisión en el parámetro de referencia que examinó Joy. Tiene medio millón de imágenes con tipos equilibrados y una red neuronal subyacente distinta, mucho más sólida».
«Estas cosas llevan tiempo», añade. «Llevamos trabajando en esto aproximadamente entre ocho y nueve meses. El modelo no es específicamente una respuesta a su estudio, pero decidimos abordar directamente las preguntas que ella había planteado, incluido su parámetro de referencia. Planteó algunos puntos muy importantes y deberíamos analizar cómo se mide nuestro nuevo trabajo frente a ellos».




