El desarrollo de sistemas de inteligencia artificial (IA) suele estar sesgado y plantear problemas graves, como demostró recientemente el algoritmo de IA de Google que etiquetó a algunas personas negras como gorilas y el bot de Twitter Tay de Microsoft, que tuvo que ser desconectado cuando aprendió a ser racista en apenas 16 horas.
Es una idea equivocada creer que la IA es objetiva porque se basa en cálculos matemáticos; la creación de un sistema de IA es un proceso intrínsecamente dirigido por seres humanos. Es inevitable que estos sistemas contengan sesgos.
Cuando el sesgo de la IA es evidente, como en los ejemplos anteriores, a menudo puede corregirse. Esta rectificación nos muestra que el núcleo de la IA no es el algoritmo, sino la persona que lo manipula. En muchos casos de sesgo más sutil, puede resultar mucho más difícil corregir el sistema.
Veamos un ejemplo que ilustra cómo una elección aparentemente pequeña en un algoritmo de IA puede producir resultados muy distintos. Un conjunto de datos de recursos humanos muy popular y ampliamente disponible contiene 15.000 observaciones sobre los nueve factores que influyeron en las decisiones de los empleados de renunciar a una empresa. Entre esos factores figuran elementos como la satisfacción de los empleados, cuántos proyectos tienen a su cargo y su antigüedad en la empresa. Estos datos son útiles para los altos directivos que intentan determinar cómo asignar mejor los recursos para retener a los empleados.
Un gerente que desee utilizar la IA para contribuir a la retención de empleados podría elegir entre dos técnicas de aprendizaje automático muy populares: la regresión logística y las redes neuronales. Un algoritmo de regresión logística intenta predecir si se producirá un suceso (es decir, si alguien se irá o se quedará) a partir de un conjunto de variables estadísticamente relevantes; una red neuronal, en cambio, es un enfoque inspirado en la biología que intenta encontrar patrones en los datos que revelen relaciones significativas entre variables (también llamadas características). Al aplicar ambos algoritmos a este conjunto de datos de recursos humanos, su precisión predictiva es la misma: del 94 %, lo que significa que ninguno supera al otro en rendimiento.
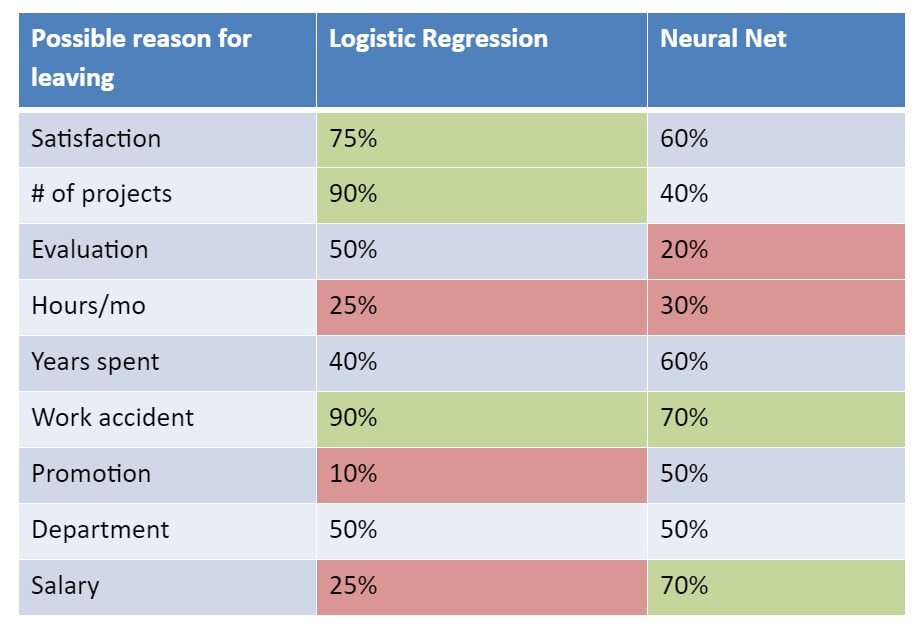
Sin embargo, como se muestra en la tabla siguiente, apuntan a dos líneas de actuación muy distintas para un gerente. Las celdas verdes de la tabla muestran los factores más probables detrás de la renuncia de un empleado y las rojas, los menos probables; los porcentajes indican en cada caso la probabilidad de que ese fuera el motivo.
Al observar la regresión logística, la gerente podría creer que aumentaría la retención de empleados centrándose en el número de proyectos que tenían y en si habían sufrido un accidente laboral. Pero, al observar la red neuronal, el salario aparece como un factor destacado, aunque la regresión logística indicaba que era poco probable que el salario influyera en la retención.
Entonces, ¿en qué modelo debería confiar un gerente? ¿Debería la empresa invertir en mejorar la satisfacción laboral, reducir el número de proyectos y disminuir los accidentes laborales? ¿O sería mejor aumentar los salarios y reducir los accidentes laborales? En este estudio de caso queda claro que la elección del algoritmo (recordemos que, desde el punto de vista estadístico, ambos son igual de correctos) tendría un gran impacto en la manera en que una empresa asigna sus recursos.
A menudo hay razones sólidas para elegir un algoritmo y explicar cómo hacerlo, pero esas elecciones pueden deberse a la familiaridad con lo que se enseñó en la universidad (algo que no está estandarizado en absoluto) o a lo que un jefe quiere que utilice un empleado (porque suele ser lo que mejor entiende). Desarrollar un enfoque fundamentado y documentado para diversos tipos de análisis de datos, comprender las fortalezas y limitaciones de esos enfoques y formar a la plantilla sobre su aplicación de manera estandarizada contribuiría en gran medida a ayudar a las empresas en estas iniciativas. Sin embargo, crear nuevas divisiones y procesos de IA puede ser una tarea abrumadora para las empresas que tienen dificultades para contratar a suficientes personas cualificadas en estos ámbitos.
En las circunstancias adecuadas, la IA puede ofrecer resultados asombrosos. Con un conjunto de datos grande, un algoritmo de IA puede revelar una relación que una persona no lograría reconocer, como un tumor en una imagen médica, o que no podría reconocer con la misma rapidez, como una colisión inminente de un automóvil. Pero la IA también puede ser extremadamente frágil: cuando se sale de un conjunto de circunstancias relativamente limitado, definido y ajustado por las personas que la crearon, puede fallar de forma estrepitosa. Además, aunque en aplicaciones de IA como el reconocimiento de voz podemos saber con gran certeza si un resultado es correcto, no puede decirse lo mismo de las aplicaciones de IA que intentan estimar la toma de decisiones humana.
Los algoritmos son creados por ingenieros e informáticos, que determinan cómo inicializar diversos parámetros estadísticos, a veces de forma algo arbitraria, y luego los calibran o ajustan a un conjunto de datos específico para lograr el resultado deseado. En algunos casos, se asignan etiquetas definidas por personas a distintos casos para mejorar la precisión predictiva general de un algoritmo. Estos parámetros, a menudo subjetivos, pueden hacer que los algoritmos de IA sean frágiles y fallen en condiciones imprevistas. El reciente accidente del automóvil autónomo de Google, que chocó contra un autobús porque no supo incorporarse eficazmente al tráfico, es un ejemplo de ello.
Una fuente de sesgo de la IA que suele pasarse por alto son las personas que interpretan los resultados de los algoritmos. Estos complejos algoritmos de IA producen conjuntos de probabilidades y agrupaciones de cifras que recuerdan a la famosa secuencia de números de las películas de Matrix. Los expertos humanos en razonamiento estadístico deben tomar esas cifras, darles un significado contextual y utilizarlo para indicar a otras personas o computadoras cómo interpretar los resultados. Estas indicaciones suelen adoptar la forma de algoritmos integrados y, debido a esta interdependencia, a menudo resulta muy difícil reconstruir por qué un sistema de IA funcionó de una manera determinada, lo que oculta cualquier sesgo que las capas humanas de interpretación anteriores hayan podido añadir. Es muy difícil explicar los resultados y las posibles limitaciones del espacio de soluciones.
Los investigadores empiezan a reconocer estas dificultades y está surgiendo un nuevo campo llamado IA explicable. Al reconocer que la mayoría de los algoritmos y los razonamientos probabilísticos en los que se basan son muy difíciles de comprender, los investigadores intentan determinar cómo diseñar o representar mejor el razonamiento de los algoritmos de IA para que sea más fácil entender la causa y el efecto.
Nuestras industrias pueden ayudar a este campo incipiente estableciendo nuevos requisitos para la IA explicable, lo que, a su vez, dará a ingenieros e informáticos la motivación necesaria para valorar el sistema de IA en su conjunto (persona que toma las decisiones + algoritmo), en lugar de competir entre sí con algoritmos nuevos e ingeniosos que solo ellos entienden. A medida que la IA se utiliza cada vez más en aplicaciones críticas para la seguridad, como dispositivos médicos, automóviles, aviones y trenes, así como en operaciones financieras e incluso en hogares inteligentes, es imperativo encontrar una manera de comunicar cuándo y dónde podría fallar un sistema habilitado por IA, para poder desarrollar sistemas resilientes en vez de frágiles.




