En una noticia que ha llamado la atención de bromistas de todo el mundo, ahora existe un programa informático que puede crear una simulación de video realista de alguien hablando.
Investigadores de la Universidad de Washington han demostrado su eficacia al crear un video con sincronización labial del expresidente de Estados Unidos Barack Obama que combina audio e imágenes existentes.
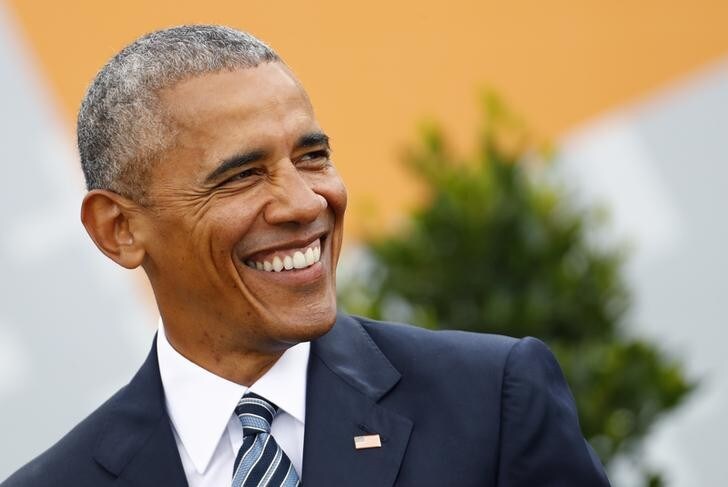
El programa utiliza inteligencia artificial (IA) para hacer coincidir el audio de una persona hablando con formas realistas de la boca, que luego incorpora a un video existente. Tras analizar millones de fotogramas de videos de archivo y estudiar las formas de la boca y los patrones de sonido, el programa puede producir simulaciones muy realistas.
Falsificaciones en la industria cinematográfica
Los investigadores afirman que esta tecnología podría utilizarse en efectos especiales. Actualmente, el proceso de conversión de audio a video implica filmar a muchas personas diciendo la misma frase e intentar encontrar una correlación entre los sonidos y las formas de la boca. Además de ser tedioso y llevar mucho tiempo, también genera el problema conocido como el «valle inquietante»: los videos son bastante realistas, pero no lo suficiente. En lugar de parecer convincentes, suelen resultar inquietantes.
La tecnología también podría mejorar la experiencia en videollamadas de baja calidad y podría aplicarse a personas con problemas de audición, permitiéndoles leer los labios en una síntesis de video creada a partir del audio de una llamada telefónica.
El equipo también estima que, al invertir el proceso —introducir video en el programa en lugar de solo audio—, podrían desarrollar un algoritmo para detectar si un video es real o falso.
El objetivo es mejorar los algoritmos para que generalicen situaciones y reconozcan la voz y los patrones del habla de una persona con menos datos; por ejemplo, con una hora de video para aprender en lugar de las 14 horas actuales.
El programa solo puede crear videos a partir de palabras pronunciadas por la misma persona: todavía no puedes poner tus palabras en boca de otra persona.




