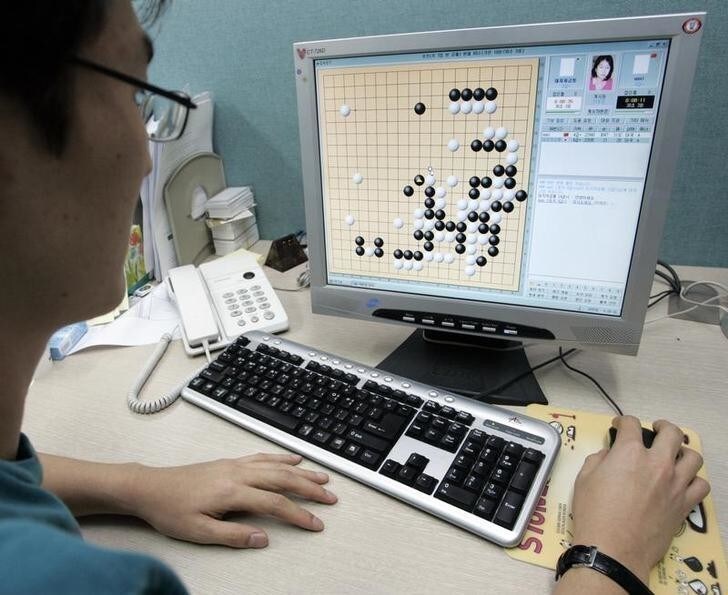
Apenas el año pasado, AlphaGo de Google DeepMind conmocionó al mundo de la inteligencia artificial (IA) al demostrar que un programa informático podía vencer a los mejores jugadores humanos de Go del mundo.
Pero, en una demostración del vertiginoso ritmo de progreso de la IA moderna, esta semana se AlphaGo Zeropublicaron en Nature los detalles de un nuevo hito alcanzado por una versión mejorada llamada .
Con menos potencia de cálculo y solo tres días de entrenamiento, AlphaGo Zero venció a la AlphaGo original por 100-0 en una partida a 100 juegos. Ni siquiera valía la pena que los humanos se presentaran.
Aprender a jugar al Go
El Go es un juego de estrategia entre dos jugadores que se turnan para colocar «piedras» en un tablero de 19x19. El objetivo es rodear una superficie mayor del tablero que el oponente.
El Go es un juego fácil de aprender, pero que a una persona le lleva toda la vida dominar… Paragorn Dangsombroon/Shutterstock
Para las computadoras, dominar el Go ha resultado mucho más difícil que dominar el ajedrez. En el Go hay muchas más jugadas posibles en cada posición que en el ajedrez, y muchas más partidas posibles.
La AlphaGo original aprendió primero estudiando 30 millones de jugadas de expertos humanos. Después superó la pericia humana al jugar muchas partidas contra sí misma, un proceso que requirió varios meses de tiempo de computación.
En cambio, AlphaGo Zero nunca vio jugar a los humanos. Empezó conociendo únicamente las reglas del juego. A partir de una cantidad relativamente modesta de cinco millones de partidas contra sí misma, en solo tres días y con una computadora menos potente que la de la AlphaGo original, aprendió a jugar a un nivel superior al de AlphaGo.
Resulta fascinante que su aprendizaje imitara, a grandes rasgos, algunas de las etapas que atraviesan los humanos a medida que dominan el Go. AlphaGo Zero aprendió rápidamente a rechazar objetivos ingenuos de corto plazo y desarrolló un pensamiento más estratégico, generando muchos de los patrones de jugadas que suelen utilizar los expertos humanos de primer nivel.
Pero, de forma sorprendente, luego empezó a rechazar algunos de esos patrones en favor de estrategias nuevas que nunca antes se habían visto en partidas humanas.
Más allá del juego humano
AlphaGo Zero logró esta hazaña al abordar el problema de manera distinta a la AlphaGo original. Ambas versiones utilizan una combinación de dos de los algoritmos más potentes que impulsan actualmente la IA: el aprendizaje profundo y el aprendizaje por refuerzo.
Para jugar a un juego como el Go, el programa debe aprender dos cosas básicas. La primera es una política: la probabilidad de realizar cada una de las jugadas posibles en una posición determinada. La segunda es un valor: la probabilidad de ganar desde cualquier posición dada.
En el enfoque de aprendizaje por refuerzo puro de AlphaGo Zero, la única información disponible para aprender políticas y valores consistía en predecir quién podría ganar al final. Para hacer esa predicción, utilizaba su política y sus valores actuales, aunque al principio estos eran aleatorios.
Está claro que este enfoque es más difícil que el de la AlphaGo original, que utilizó jugadas de expertos humanos para adelantarse en el aprendizaje. Sin embargo, la versión anterior aprendió las políticas y los valores con redes neuronales separadas.
El avance algorítmico de AlphaGo Zero consistió en descubrir cómo combinar ambos en una sola red. Esto simplificó enormemente el proceso de entrenamiento mediante partidas contra sí misma e hizo viable empezar desde cero, en lugar de aprender primero qué harían los expertos humanos.
La clasificación Elo es una medida muy utilizada del rendimiento de los jugadores en juegos como el Go y el ajedrez. El mejor jugador humano hasta la fecha, Ke Jie, tiene actualmente una clasificación Elo de unos 3,700 puntos.
AlphaGo Zero se entrenó durante tres días y alcanzó una clasificación Elo superior a 4,000, mientras que una versión ampliada del mismo algoritmo se entrenó durante 40 días y alcanzó casi 5,200.
Se trata de un salto extraordinariamente grande respecto del mejor jugador humano, mucho mayor que la diferencia actual entre el mejor ajedrecista humano, Magnus Carlsen (unos 2,800 puntos), y un programa de ajedrez (unos 3,400 puntos).
El próximo desafío
AlphaGo Zero representa un avance importante para la IA porque demuestra la viabilidad del aprendizaje por refuerzo puro, sin interferencia de ninguna orientación humana. Esto elimina la necesidad de contar desde el principio con muchos conocimientos de expertos humanos, algo que puede ser difícil de obtener en algunos ámbitos.
También significa que el algoritmo tiene libertad para desarrollar enfoques completamente nuevos, que quizá habrían sido mucho más difíciles de encontrar si desde el principio se le hubiera limitado a «pensar dentro de los esquemas humanos». Sorprendentemente, esta estrategia también resulta ser más eficiente desde el punto de vista computacional.
Pero el Go es un juego de información perfecta con reglas muy estrictas, sin las complicaciones de la mayoría de los problemas del mundo real. Entrenar a AlphaGo Zero exigió simular con precisión millones de partidas conforme a las reglas del Go.
Para muchos problemas prácticos, esas simulaciones son computacionalmente inviables o las propias reglas son menos claras.
Aún quedan muchos problemas por resolver para crear una IA de propósito general capaz de abordar una amplia variedad de problemas prácticos sin intervención humana especializada en cada ámbito.
Pero aunque los humanos han perdido de forma contundente la batalla contra los algoritmos de Go, por suerte la IA, a diferencia del Go, no es un juego de suma cero. Muchas partidas de AlphaGo Zero ya se han publicado, y ofrecen a los jugadores humanos de Go material inspirador para toda una vida de estudio.
Y lo que es más importante, AlphaGo Zero representa un paso hacia un mundo en el que los humanos puedan aprovechar IA potentes para encontrar soluciones creativas a problemas difíciles, soluciones inimaginables para las personas. En el mundo de la IA, nunca ha habido un mejor momento para lanzarse a ello.




