A pesar de la amplia conciencia sobre los riesgos de sesgo y errores en los algoritmos de IA, las empresas tecnológicas han cometido numerosos errores con sus chatbots de IA y sus generadores de imágenes.
Una razón probable del sesgo de la IA es que se entrenan con un grupo no representativo, lo que genera compensaciones entre la precisión y la equidad.
Un profesor de tecnología destaca la importancia de la diversidad para crear algoritmos inclusivos, a partir de su propia experiencia al crear involuntariamente un algoritmo de IA sesgado.
En 1998, creé involuntariamente un algoritmo de inteligencia artificial con sesgo racial. Hay lecciones en esa historia que resuenan aún con más fuerza hoy.
Los peligros del sesgo y los errores en los algoritmos de IA son hoy bien conocidos. ¿Por qué, entonces, se ha producido una oleada de errores garrafales por parte de las empresas tecnológicas en los últimos meses, sobre todo en el ámbito de los chatbots de IA y los generadores de imágenes? Las primeras versiones de ChatGPT produjeron resultados racistas. Los generadores de imágenes DALL-E 2 y Stable Diffusion mostraron sesgo racial en las imágenes que crearon.
Mi propia revelación como hombre blanco informático se produjo mientras impartía una clase de informática en 2021. La clase acababa de ver un poema en vídeo de Joy Buolamwini, investigadora de IA y artista y de la que se describe a sí misma como poeta del código. Su poema en vídeo de 2019 “AI, Ain’t I a Woman?” es una devastadora exposición de tres minutos sobre los sesgos raciales y de género en los sistemas automáticos de reconocimiento facial, desarrollados por empresas tecnológicas como Google y Microsoft.
Estos sistemas suelen fallar con las mujeres de color, etiquetándolas incorrectamente como hombres. Algunos de los fallos son especialmente flagrantes: el cabello de la líder afroamericana de derechos civiles Ida B. Wells fue etiquetado como un “gorro de piel de mapache”; otra mujer negra fue etiquetada como si tuviera un “bigote de morsa”.
Un eco a través de los años
Tuve un horrible momento de déjà vu en esa clase de informática: de repente recordé que yo también había creado en su día un algoritmo con sesgo racial. En 1998 era estudiante de doctorado. Mi proyecto consistía en seguir los movimientos de la cabeza de una persona a partir de la información de una cámara de vídeo. Mi director de tesis ya había desarrollado técnicas matemáticas para seguir con precisión la cabeza en determinadas situaciones, pero el sistema necesitaba ser mucho más rápido y robusto. Anteriormente, en los años noventa, investigadores de otros laboratorios habían demostrado que las zonas de una imagen con color de piel podían extraerse en tiempo real. Así que decidimos centrarnos en el color de piel como indicador adicional para el rastreador.
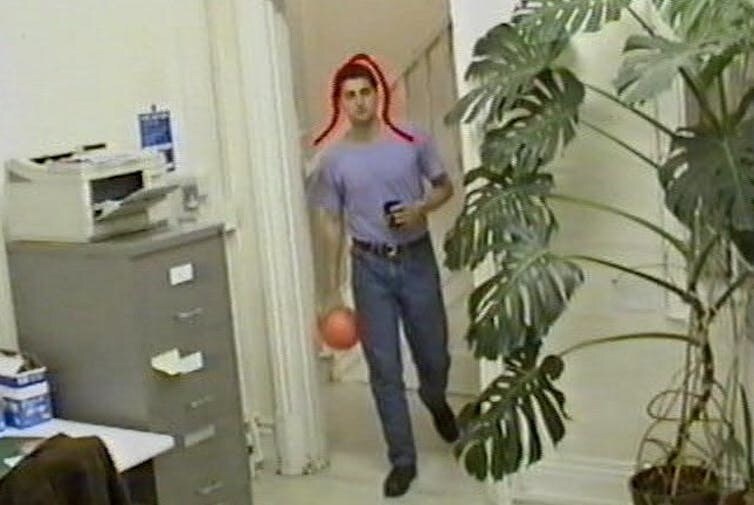
Utilicé una cámara digital, todavía una rareza en aquel momento, para tomar algunas fotos de mi propia mano y mi rostro, y también fotografié las manos y los rostros de dos o tres personas más que casualmente estaban en el edificio. Fue fácil extraer manualmente algunos de los píxeles de color de piel de estas imágenes y construir un modelo estadístico de los colores de piel. Tras algunos ajustes y depuración, obtuvimos un sistema en tiempo real, sorprendentemente robusto, de seguimiento de la cabeza.
Poco después, mi director me pidió que mostrara el sistema a unos ejecutivos de empresa que nos visitaban. Cuando entraron en la sala, me invadió de inmediato la ansiedad: los ejecutivos eran japoneses. En mi experimento informal para comprobar si un modelo estadístico sencillo funcionaría con nuestro prototipo, había recogido datos de mí mismo y de un puñado de otras personas que casualmente estaban en el edificio. Pero el 100 % de esos sujetos tenía piel “blanca”; los ejecutivos japoneses no.
Milagrosamente, el sistema funcionó razonablemente bien con los ejecutivos de todos modos. Pero me conmocionó darme cuenta de que había creado un sistema con sesgo racial que podría haber fallado fácilmente con otras personas no blancas.
Privilegio y prioridades
¿Cómo y por qué científicos bien formados y con buenas intenciones producen sistemas de IA sesgados? Las teorías sociológicas sobre el privilegio ofrecen una perspectiva útil.
Diez años antes de que creara el sistema de seguimiento de la cabeza, la académica Peggy McIntosh propuso la idea de una “mochila invisible” que llevan las personas blancas. Dentro de la mochila hay un tesoro de privilegios, como “puedo salir bien parado en una situación difícil sin que se diga que soy un orgullo para mi raza”, y “puedo criticar a nuestro gobierno y hablar de cuánto temo sus políticas y su comportamiento sin que se me considere un extraño cultural”.
En la era de la IA, esa mochila necesita algunos elementos nuevos, como “los sistemas de IA no darán malos resultados por mi raza”. La mochila invisible de un científico blanco también necesitaría: “puedo desarrollar un sistema de IA basado en mi propia apariencia, y saber que funcionará bien para la mayoría de mis usuarios”.
Un remedio sugerido para el privilegio blanco es ser activamente antirracista. En el caso del sistema de seguimiento de la cabeza de 1998, podría parecer obvio que el remedio antirracista consiste en tratar todos los colores de piel por igual. Sin duda, podemos y debemos garantizar que los datos de entrenamiento del sistema representen la gama de todos los colores de piel de la forma más equitativa posible.
Desafortunadamente, esto no garantiza que todos los colores de piel que observa el sistema vayan a tratarse por igual. El sistema debe clasificar cada color posible como piel o no piel. Por tanto, existen colores justo en la frontera entre piel y no piel: una región que los informáticos llaman frontera de decisión. Una persona cuyo color de piel cruce esta frontera de decisión será clasificada incorrectamente.
Los científicos también se enfrentan a un desagradable dilema subconsciente al incorporar la diversidad en los modelos de aprendizaje automático: los modelos diversos e inclusivos funcionan peor que los modelos restringidos.
Una analogía sencilla puede explicar esto. Imagine que se le da a elegir entre dos tareas. La tarea A consiste en identificar un tipo particular de árbol, por ejemplo, los olmos. La tarea B consiste en identificar cinco tipos de árboles: olmo, fresno, acacia, haya y nogal. Es obvio que, si dispone de un tiempo fijo para practicar, lo hará mejor en la tarea A que en la B.
De la misma manera, un algoritmo que solo rastrea la piel blanca será más preciso que uno que rastrea la gama completa de colores de piel humana. Aunque sean conscientes de la necesidad de diversidad y equidad, los científicos pueden verse afectados subconscientemente por esta necesidad de precisión, que compite con ella.
Oculto en los números
Mi creación de un algoritmo sesgado fue irreflexiva y potencialmente ofensiva. Aún más preocupante, este incidente demuestra cómo el sesgo puede permanecer oculto en lo profundo de un sistema de IA. Para entender por qué, considere un conjunto particular de 12 números en una matriz de tres filas y cuatro columnas. ¿Le parecen racistas? El algoritmo de seguimiento de la cabeza que desarrollé en 1998 está controlado por una matriz como esta, que describe el modelo de color de piel. Pero es imposible saber solo a partir de estos números que, en realidad, se trata de una matriz racista. Son simplemente números, determinados automáticamente por un programa informático.
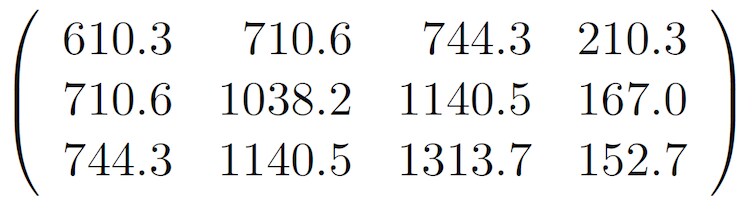
El problema del sesgo oculto a plena vista es mucho más grave en los sistemas modernos de aprendizaje automático. Las redes neuronales profundas – actualmente el tipo más popular y potente de modelo de IA – suelen tener millones de números en los que podría codificarse el sesgo. Los sistemas sesgados de reconocimiento facial criticados en “AI, Ain’t I a Woman?” son todos redes neuronales profundas.
La buena noticia es que ya se ha avanzado mucho en la equidad de la IA, tanto en el ámbito académico como en la industria. Microsoft, por ejemplo, cuenta con un grupo de investigación conocido como FATE, dedicado a la equidad, la rendición de cuentas, la transparencia y la ética en la IA. Una conferencia líder en aprendizaje automático, NeurIPS, ha detallado directrices éticas, que incluyen una lista de ocho puntos sobre los impactos sociales negativos que deben considerar los investigadores que presentan artículos.
Quién está en la sala es quien está en la mesa
Por otro lado, incluso en 2023, la equidad puede seguir siendo víctima de presiones competitivas en el ámbito académico y en la industria. Los defectuosos chatbots Bard y Bing de Google y Microsoft son pruebas recientes de esta sombría realidad. La necesidad comercial de ganar cuota de mercado llevó a la publicación prematura de estos sistemas.
Estos sistemas adolecen exactamente de los mismos problemas que mi rastreador de cabeza de 1998. Sus datos de entrenamiento están sesgados. Han sido diseñados por un grupo no representativo. Se enfrentan a la imposibilidad matemática de tratar todas las categorías por igual. Deben, de algún modo, sacrificar precisión por equidad. Y sus sesgos se ocultan tras millones de parámetros numéricos incomprensibles.
Entonces, ¿cuánto ha avanzado realmente el campo de la IA desde que, hace más de 25 años, fue posible que un estudiante de doctorado diseñara y publicara los resultados de un algoritmo con sesgo racial sin aparente supervisión ni consecuencias? Está claro que los sistemas de IA sesgados todavía pueden crearse de forma involuntaria y fácil. También está claro que el sesgo en estos sistemas puede ser dañino, difícil de detectar y aún más difícil de eliminar.
Hoy en día es un tópico decir que la industria y el mundo académico necesitan grupos diversos de personas “en la sala” diseñando estos algoritmos. Sería útil que el campo llegara a ese punto. Pero, en la práctica, dado que los programas de doctorado en informática de Norteamérica solo gradúan alrededor de un 23 % de mujeres y un 3 % de estudiantes negros y latinos, seguirá habiendo muchas salas y muchos algoritmos en los que los grupos subrepresentados no estarán representados en absoluto.
Por eso, las lecciones fundamentales de mi rastreador de cabeza de 1998 son aún más importantes hoy: es fácil cometer un error, es fácil que el sesgo se introduzca sin detectarlo y todos los presentes en la sala son responsables de evitarlo.




