En 2017, The Economist publicó un artículo muy citado que afirmaba que los datos habían sustituido al petróleo como el recurso más valioso del mundo; en concreto, los datos que empresas tecnológicas como Google, Facebook y Amazon recopilan de sus usuarios. El artículo reclamaba leyes antimonopolio adaptadas específicamente al sector tecnológico para democratizar el acceso a los datos y abrir espacio en el mercado a futuros agentes disruptivos. The Economist describía un panorama sombrío: los conglomerados FAANG (Facebook, Apple, Amazon, Netflix y Google) tendrían tantos datos a su disposición que podrían detectar y socavar a un posible competidor en la etapa más temprana, antes de que supusiera una amenaza creíble o lo conocieran más que unas pocas personas.
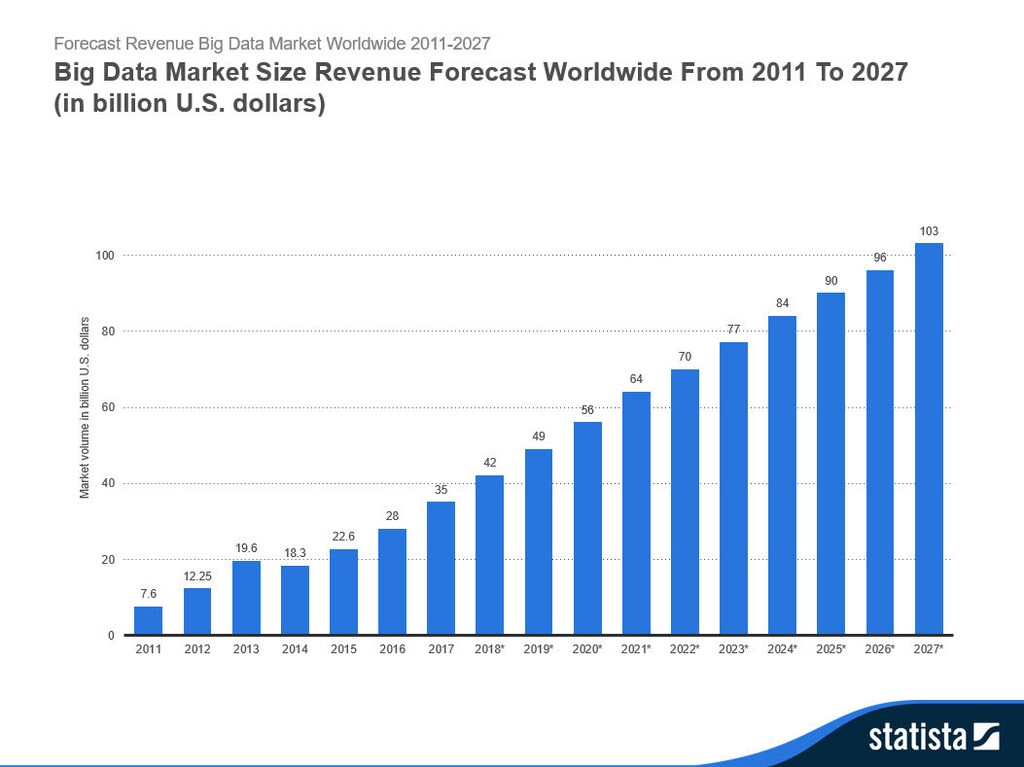
Sin embargo, el artículo de The Economist no explora qué ocurre con todos los datos que genera el mundo —y seguirá generando a un ritmo exponencial—, independientemente de que esos gigantes tecnológicos estén sujetos a leyes antimonopolio. Lo cierto es que, tanto si están en manos de unos pocos como de una multitud de empresas tecnológicas competidoras, los datos no van a desaparecer. Cada vez generamos más, y nuestra tecnología mejora constantemente su capacidad para analizarlos y obtener beneficios de ellos.
Durante las últimas décadas, no hemos tenido otra opción satisfactoria que entregar nuestros datos a las empresas tecnológicas (salvo desconectarnos por completo de Internet). Los datos no pueden simplemente «existir» si no tienen un lugar donde existir. Desde la llegada de Internet, el único lugar donde los datos podían residir realmente eran los servidores centralizados de las empresas tecnológicas. Sin embargo, eso también ha significado que el valor y el potencial económico de esos datos hayan quedado en gran medida restringidos a esos actores.
Debemos cambiar nuestra forma de concebir y tratar los datos para prepararnos mejor para un futuro cada vez más saturado de ellos. Con la expansión de la tecnología blockchain y su integración en sectores basados en datos, como la atención sanitaria y las redes sociales, podemos recuperar gradualmente el control de nuestros datos. Podremos ver qué empresas y entidades tienen acceso a qué partes de nuestros datos en línea (es decir, nuestra identidad digital). Podremos ver cómo se utilizan nuestros datos y responder en consecuencia, permitiendo o restringiendo el acceso posterior. También podremos solicitar una compensación, en forma de acceso a servicios y dinero, si una empresa quiere recopilar, estudiar y vender nuestra información. Al fin y al cabo, están haciendo una fortuna con ella.
A medida que estas capacidades se hagan realidad y empecemos a poseer y monetizar nuestros propios datos, tendremos que redefinir qué entendemos por «datos». Una forma de concebirlos es determinando que constituyen una clase de activo, igual que el petróleo y otras materias primas. Este artículo explora cómo sería un mundo en el que los datos fueran una clase de activo. La decisión que tenemos ante nosotros es si llevamos esta idea a la práctica o no.
«Información sobre la información»: el argumento a favor de convertir los datos en activos
En los albores de la era digital, Tim Berners-Lee, creador de Internet, describió un mundo que realiza transacciones en la web como uno en el que se puede comprar información con información. En otras palabras, todo pasa a representarse como datos e información. Lo vemos con el dinero, y eso ha cambiado nuestro mundo. Sabemos que nuestros patrones de conducta, los movimientos de nuestros dedos, nuestros gustos, hábitos de compra y desplazamientos, nuestras preferencias y tendencias políticas se recopilan y se nos presentan de nuevo en forma de anuncios. Pero apenas hemos visto la punta del iceberg. La tecnología blockchain anunciará una era de tokenización y transferencia de activos a gran escala. Cada día se realizarán transacciones con muchos más datos, a un ritmo exponencial. Sin una forma eficaz de recopilar y valorar estos datos, es probable que no se utilicen o que se exploten en nuestra contra.
Concebir los datos como una clase de activo
Si suponemos que hoy pudiéramos clasificar y gestionar los datos como una clase de activo, ¿cómo funcionaría? Una posibilidad sería crear «paquetes de datos», es decir, conjuntos de información organizados por sector, industria, conducta o plataforma. Estos conjuntos podrían ser modulares, reconfigurarse y desglosarse con mayor detalle según la información que una persona esté dispuesta a compartir o la que el mercado considere más valiosa. Por ejemplo, la información sobre compras en línea podría dividirse en categorías como alimentos, ropa, servicios y eventos. Una persona podría decidir agrupar todos esos paquetes y vendérselos a un gigante como Walmart, que quizá estaría dispuesto a pagar aproximadamente lo mismo por todas esas categorías. En cambio, a una tienda de ropa concreta solo le interesarían los datos sobre compras de ropa en línea y quizá pagaría un precio más alto por adquirir ese único paquete de datos.
La clasificación y optimización de la configuración de los paquetes de datos daría lugar, naturalmente, a una industria paralela de servicios que organizasen y clasificasen los datos de las personas de la forma más rentable posible. Este modelo también permite a las personas actuar conforme a sus propias convicciones económicas y personales. Alguien podría crear una amplia cartera de paquetes de datos generales y de alto nivel, similar a un fondo indexado de mercado actual, que diversifica las inversiones con la expectativa de obtener rendimientos menores pero más constantes. Por otro lado, si alguien se preocupa mucho por la privacidad de los datos y solo se siente cómodo compartiendo ciertos detalles de su estilo de vida, puede configurar y poner a disposición paquetes de datos que compartan información limitada.
La confianza es fundamental para que surja y tenga éxito esta industria de terceros dedicada a los «paquetes de datos». No se puede obligar a los consumidores de este nuevo mercado de servicios de datos a aceptar la misma estructura de incentivos que existe hoy, en la que sus datos quedan a la vista de una industria explotadora. Estas empresas deben poder ofrecer servicios de configuración de paquetes sin poner en riesgo la seguridad ni la identidad de ningún dato ni usuario.
También es interesante especular sobre los mecanismos mediante los cuales las personas podrían vender sus datos a empresas dispuestas a pagar. Alguien podría decidir vender datos históricos, por ejemplo, facilitando a una empresa información sobre sus compras en línea entre 2010 y 2015. Naturalmente, habría que considerar si las personas podrían eliminar elementos de sus datos correspondientes a ese período. Si una empresa pagara por datos «manipulados» mediante la eliminación de cierta actividad histórica, ¿reflejarían fielmente la conducta de los consumidores y justificarían el precio? ¿Tendrían las empresas derecho a determinar si se ha eliminado información de un paquete de datos? ¿Y podrían pagar menos por datos de usuarios editados?
Los usuarios también podrían recibir pagos periódicos por facilitar a una empresa o a un grupo de empresas dispuestas a pagar ciertos datos sobre su estilo de vida. Esta relación continua podría rescindirse legalmente en cualquier momento: un usuario podría decidir que ya no quiere poner cierta información a disposición, o una empresa podría decidir que ya no quiere pagar por determinados datos. Otra opción sería que la empresa y el consumidor se comprometieran mediante un contrato, acuerdo que quizá alcanzaría un precio más alto. Un usuario podría dar su consentimiento para vender a una empresa un conjunto de datos acordado durante, por ejemplo, los tres años siguientes. En teoría, ninguna de las partes podría rescindir legalmente el acuerdo, lo que proporcionaría a los usuarios ingresos adicionales confirmados y estables durante cierto tiempo. También cabe considerar la idea de «acontecimientos vitales» que podrían permitir a un usuario rescindir el contrato. Por ejemplo, si alguien enfermara, sus hábitos de consumo podrían cambiar de tal modo que fuera fácil identificarlo como paciente de una enfermedad concreta. El acuerdo podría incluir cláusulas que permitieran a los usuarios rescindir los contratos si se produjeran determinados acontecimientos vitales, como una enfermedad específica.
La exclusividad es otro aspecto interesante que cabe considerar al convertir los datos en activos y monetizarlos. En un mercado de datos libre, global, sin fronteras, abierto las 24 horas del día y con gran liquidez, una empresa estaría dispuesta a pagar más por ser la única destinataria de los datos de un usuario, en vez de compartirlos con varios competidores. Las empresas de servicios de datos de terceros mencionadas podrían identificar a un usuario como una persona de gran valor —entendido como la cantidad y la importancia de los datos que genera en línea— y sugerirle que ofrezca exclusividad a las empresas mediante un acuerdo histórico, continuo o contractual. Un usuario también podría optar por vender sus datos a más compradores, lo que quizá le reportaría menos dinero por paquete de datos, pero más en total si muchas empresas quisieran comprarlos.
Retos de convertir los datos en activos
Tanto si estamos de acuerdo con convertir los datos representados en blockchain en activos como si no, los retos para que este modelo tenga éxito y sea manejable, descentralizado y equitativo son considerables:
• Desarrollo técnico: La tecnología blockchain sigue mejorando y desarrollándose, pero aún está en sus primeras etapas en la mayoría de sus aplicaciones más esotéricas y abstractas, como la conversión de los datos en activos. En un contexto de debate en todo el sector sobre escalabilidad, redes privadas frente a públicas, interoperabilidad y privacidad, la identidad basada en blockchain —es decir, la capacidad de asociar de forma segura e inequívoca los datos de una persona con su identidad— plantea una cuestión específica en torno a los datos como activo.
• Experiencia de usuario: La experiencia de usuario (UX) de Web3 actual cuenta principalmente con la aceptación del sector de los videojuegos, ya que es un ecosistema que exige menos confianza y supone menos riesgos para sus usuarios. En cambio, las aplicaciones blockchain que supervisan el dinero, la información o la identidad de las personas siguen estando mediadas en gran medida por empresas con arquitectura Web2, en las que la gente confía más. Desde el punto de vista de la UX, esto tiene sentido. Si se pide a usuarios nuevos (o incluso veteranos) de Web3 que gestionen una larga lista de direcciones de monedero, claves privadas y frases semilla, junto con todos los riesgos asociados, es probable que una empresa pierda usuarios. Sin embargo, Internet tendrá que descentralizarse gradualmente, y la innovación en UX deberá seguir el ritmo para que los usuarios puedan realizar transacciones con confianza, ya sea con algo tan sencillo como un token o tan difuso como un «paquete» de datos de usuario.
• Valoración: Concebir los datos como un activo exige agrupar fragmentos de datos pertinentes en «paquetes» identificables y valiosos, relacionados con la conducta, la industria, el estilo de vida, etc. Valorar esos paquetes dependerá del aprendizaje automático y de las estrategias de rentabilidad de las empresas. ¿Cómo determinamos si el paquete de datos de una persona es más valioso que el de otra, aunque ambos se refieran al mismo tipo de conducta en línea? ¿Cómo valoramos la cantidad frente a la calidad de los datos? ¿Quién determina el valor de los paquetes de datos: las empresas de terceros, los organismos reguladores, los propietarios de los datos o quienes los venden? ¿Cómo sería un mercado de paquetes de datos? Si los datos fueran propiedad de las personas y no de las empresas, ¿podría vender a Twitter mi información de tráfico de Facebook? Lo más probable es que surja una industria paralela junto con la conversión de los datos en activos. Estos servicios organizarían algorítmicamente la información de las personas —de forma segura y sin que el propio tercero pudiera identificarla— en las combinaciones de datos más rentables, según las tendencias actuales del mercado. Es razonable que estos terceros se queden con una parte de los beneficios de un paquete de datos, pero no deberían tener acceso al contenido de los datos de los usuarios. De lo contrario, volveríamos al punto de partida, con terceros extrayendo nuestros datos para obtener beneficios propios.
• Tecnología de aprendizaje de datos: Junto con el reto de valorar los datos, es necesario analizarlos, organizarlos y valorarlos adecuadamente mediante la IA y el aprendizaje automático. La mayor parte de los datos que genera el tráfico en línea es «ruido», y los imperios tecnológicos se han construido separando la señal del ruido. A medida que mejore la tecnología de aprendizaje automático, podrán sintetizarse más datos para obtener información útil, lo que generará mayores oportunidades económicas tanto para los consumidores como para las empresas.
• Regulación: Todo el ecosistema blockchain contiene más o menos la respiración mientras los reguladores debaten y determinan cómo abordar exactamente esta nueva tecnología y los casos de uso que permite (en especial, la actividad monetaria descentralizada). Para bien o para mal, la regulación siempre ha ido un paso por detrás de la innovación técnica privada. De ahí surge la pregunta: si decidiéramos ahora que los datos deberían ser una clase de activo, ¿podrían serlo legalmente? De las cinco clases de activos que suelen reconocerse —materias primas, bienes inmuebles, renta fija, renta variable y efectivo—, ¿dónde debería encuadrarse la información digital propia? Podría argumentarse que corresponde a las materias primas [es decir, la propiedad de un «bien» que tiene utilidad] o a la renta fija [es decir, prestar dinero (en forma de datos) a alguien (una empresa)]. O quizá sea necesario crear una nueva clase de activo. Los bienes inmuebles se definen como la «propiedad de un espacio físico». Tal vez necesitemos una clase de activos digitales, definida como la «propiedad de un espacio digital». Sea cual sea el resultado de la regulación, las empresas deben crear primero posibles soluciones para mostrar a los reguladores qué opciones existen antes de pedirles que tomen una decisión.
Perspectivas de futuro
Gracias a las aplicaciones de la tecnología blockchain, los datos volverán gradualmente a manos de quienes los generan. Las empresas tendrán que crear mecanismos alternativos de incentivos para acceder a ellos, lo que permitirá exigir responsabilidades al mercado de forma radical en cuanto al uso ético, autorizado y equitativo de la información de cada persona. Recrear los modelos económicos lleva tiempo, pero, si logramos integrar en los sistemas financieros existentes nuevas conductas monetarias habilitadas por blockchain, podremos acelerar su adopción. Clasificar los datos como una clase de activo contribuye a ello y nos acerca un paso más a una relación equitativa y empoderadora con Internet.




