Cada día generamos 2,5 trillones de bytes de datos. Organizada y analizada correctamente, esta información tiene el poder de crear un futuro mejor para todos. Los macrodatos pueden detectar con precisión terremotos, inundaciones y hambrunas antes de asignar recursos allí donde más se necesitan. Los datos abiertos tienen el potencial de mejorar el acceso a la educación, la atención sanitaria y los servicios financieros.
A pesar de sus promesas, los conjuntos de datos son producto del diseño humano: reflejan los defectos, las preferencias y las experiencias de sus creadores imperfectos. Casi todos los datos son definidos, interpretados y manipulados por personas que a menudo deciden en función de sus valores qué incluir. Por eso, comprender qué elementos se han excluido de un conjunto de datos es tan importante como comprender los propios datos.
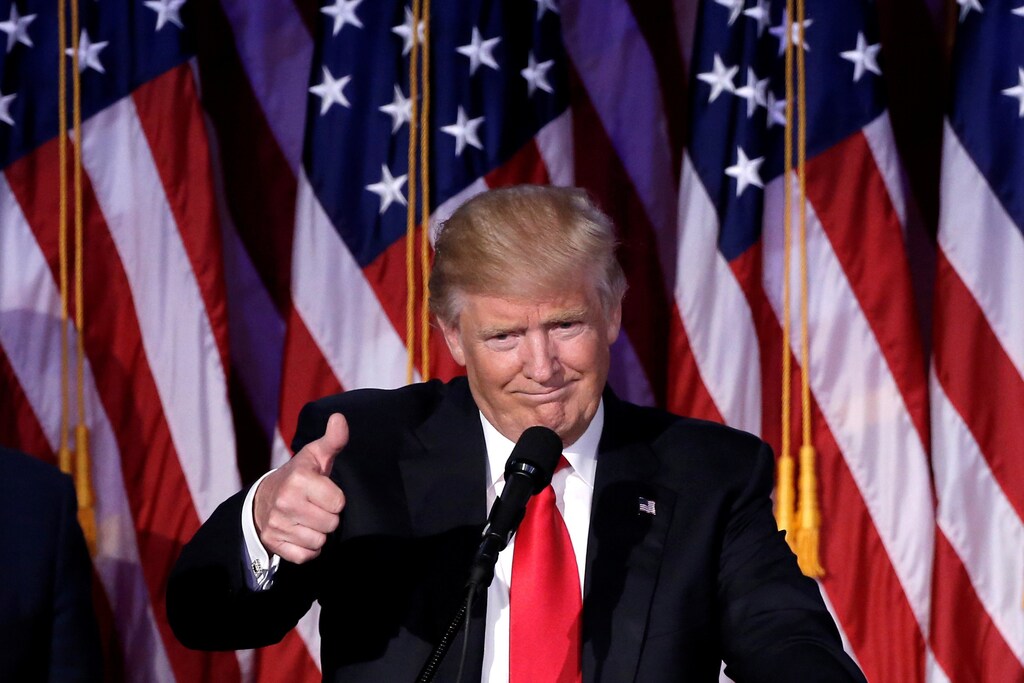
Como seres humanos, padecemos el sesgo de confirmación: la tendencia a buscar o interpretar información de maneras que refuerzan nuestras opiniones existentes, ignorando cualquier evidencia contradictoria. Un buen ejemplo son las elecciones presidenciales de Estados Unidos de 2016, cuando la mayoría de los encuestadores no logró predecir la victoria de Donald Trump. El día de las elecciones, según los datos, se le atribuía a Trump un 15% de probabilidades de ganar. Sin embargo, los expertos pasaron por alto muchos factores: la falta de precisión de los modelos de participación electoral, la sobrerrepresentación de los graduados universitarios en las encuestas, el impacto de los grupos difíciles de contactar y la sinceridad de los votantes ante desconocidos. Estos descuidos no se evitarán teniendo acceso a más datos, sino rompiendo las burbujas de filtro que nos hacen creer que todo el mundo piensa y actúa como nosotros.
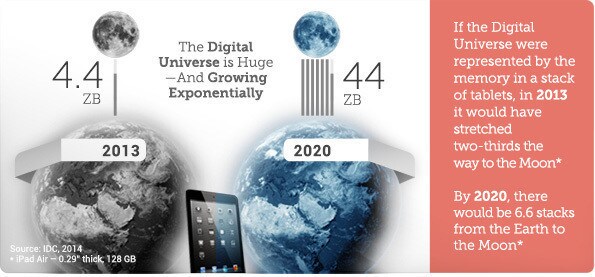
Al mismo tiempo, se ha creado más datos en los últimos dos años que en los 5.000 años anteriores de historia humana. Este flujo acelerado de nueva información aumenta nuestra dependencia de la «heurística de disponibilidad»: la tendencia a tomar decisiones basadas en la información más reciente disponible. La mayoría de los gobiernos, economistas y periodistas no previeron la crisis financiera de 2007-8, porque los modelos matemáticos predominantes no apuntaban a una recesión. Si tan solo se hubieran centrado menos en los datos más recientes y más en la naturaleza cíclica de los mercados financieros.
Asimismo, hay muchos más datos sobre ciertas personas, grupos y países que sobre otros. Esto ha provocado una brecha de datos, especialmente entre países desarrollados y en desarrollo. Si me basara únicamente en los datos, estos me dirían que mi familia de las montañas Zagros no existe. Simplemente porque no tiene acceso a internet y nunca ha rellenado una encuesta en su vida. La infrarrepresentación de idiomas, culturas y regiones geográficas en los conjuntos de datos crea relatos sesgados y versiones distorsionadas de la realidad.
Para empeorar las cosas, el pasado suele ser un pésimo indicador del futuro. Sirve de poco usar sistemas existentes, dependientes de variables conocidas, la constancia y la lógica, para generar información cuando quizá no la haya. Nassim Taleb, profesor de probabilidad, aborda esa incertidumbre en su libro, El cisne negro. Un cisne negro es un caso atípico, fuera de lo esperado, que, pese a su baja probabilidad, cambia fundamentalmente el curso de la historia. Lo más fascinante es que a menudo se racionaliza un cisne negro a posteriori, cuando ya se dispone de suficientes datos. Vivimos en un mundo aleatorio, lleno de incertidumbre, variación y coincidencias; en esas circunstancias, los datos solo pueden llevarnos hasta cierto punto.
Los datos solo miden lo que se puede medir. ¿Qué ocurre con aquello que no se puede medir? Los valores binarios de 0 y 1 no pueden captar las realidades complejas y, a menudo, irracionales de la experiencia humana. ¿Podemos cuantificar de forma fiable el amor, la bondad o la felicidad? Como afirmó el sociólogo William Bruce Cameron: «No todo lo que se puede contar cuenta, y no todo lo que cuenta se puede contar». La obsesión por las métricas ha culminado en el sesgo de cuantificación: la veneración de los números por encima de todo. Aunque los datos tengan una precisión del 100%, solo pueden decirnos qué está ocurriendo, no por qué. Sin una capa humana de comprensión, los datos carecen de contexto y matices. Los números solo cobran sentido cuando descubrimos las emociones, conductas y motivaciones humanas subyacentes.
Sobre el papel, los datos prometen crear una sociedad más informada, conectada e inclusiva. Sin embargo, como ya se ha señalado, nuestros sistemas de pensamiento son frágiles y susceptibles a los sesgos. Tendemos a pensar que los datos son una verdad objetiva, independiente de la influencia humana. En realidad, los datos prolongan nuestros sesgos humanos en los algoritmos. Al entrar en la Cuarta Revolución Industrial, con su proliferación de información y el crecimiento exponencial de la IA, tenemos la oportunidad de diseñar una sociedad más igualitaria, ya que la tecnología refuerza el pensamiento humano.
Los datos «para el bien» requieren un nuevo debate, ideas renovadas y un nuevo contrato social que refleje los avances radicales de la tecnología. Sobre todo, los datos deben reflejar y representar las diversas opiniones y necesidades de los 7.600 millones de personas que habitan nuestro planeta. En última instancia, el futuro de la civilización humana podría depender de si el acceso a la información se concentra en unos pocos o está abierto a todos. Los datos no son la respuesta; son simplemente una herramienta que permite a las personas descubrir nuevas preguntas y crear nuevas posibilidades.




