¿Alguna vez te has planteado qué hace realmente el aprendizaje automático? Si el aprendizaje automático es un caballo de carga para el procesamiento de información, una red neuronal es la zanahoria que hace avanzar al caballo. Para que un sistema pueda aprender de verdad, no debe programarse para realizar una tarea concreta, sino para aprender a realizarla. Para ello, el sistema necesita utilizar una forma más refinada de aprendizaje automático llamada aprendizaje profundo que se basa en redes neuronales. Con las redes neuronales, el sistema puede detectar de forma independiente patrones en los datos para aprender a realizar una tarea.
Las redes neuronales o, más concretamente, las redes neuronales artificiales (RNA) son dispositivos de procesamiento. Pueden ser algoritmos o hardware propiamente dicho, y se inspiran de manera general en la estructura neuronal de la corteza cerebral, aunque a menor escala.
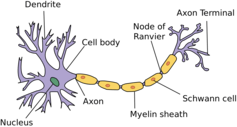
El origen de las RNA modernas se basa en un modelo matemático de la neurona llamado perceptrón, introducido por Frank Rosenblatt en 1957. Como puede verse a continuación, el modelo se asemeja mucho a la estructura de la neurona, con entradas similares a las dendritas (una prolongación corta de una neurona que transmite señales electroquímicas de una neurona a otra).
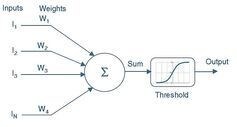
En el modelo original creado por Warren McCulloch y Walter Pitts, las entradas eran 0 o 1. Cada dendrita/entrada también tenía un peso de +1 o -1. Así, la entrada se multiplicaba por su peso y la suma de las entradas ponderadas se introducía después en un modelo. Por tanto, el perceptrón toma varias entradas binarias (I1, I2… IN) y produce una única salida binaria, que es el promedio ponderado de las múltiples entradas. Si la salida acumulada supera un umbral establecido, el modelo genera una salida determinada. En otras palabras, salida = 0 si el resultado es menor o igual que el umbral; salida = 1 si el resultado es mayor que el umbral.
El poder de las capas
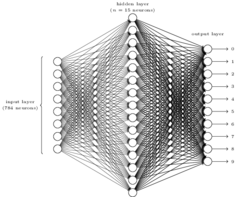
A partir de este esquema inicial, el modelo de perceptrón permite que las entradas de las neuronas y los pesos adopten cualquier valor. Por tanto, una RNA no es más que capas interconectadas de perceptrones, como se muestra a continuación:
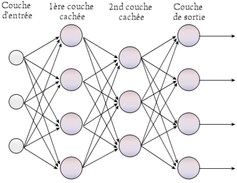
Al variar los pesos y el umbral, podemos obtener distintos modelos de toma de decisiones. Las salidas de una capa oculta también pueden introducirse en otra capa oculta del perceptrón. La primera capa de un perceptrón toma decisiones muy sencillas al ponderar las pruebas de entrada. Después, estas salidas se introducen en una segunda capa, que toma una decisión ponderando los resultados de la primera capa.
Siguiendo este método, un perceptrón de la segunda capa puede decidir en un nivel más complejo y abstracto que el perceptrón de la primera capa. Si se añade una tercera capa, las decisiones que tomen esos perceptrones serán aún más complejas. De este modo, una red «profunda» de perceptrones con muchas capas puede realizar una toma de decisiones sofisticada. Cuanto mayor sea el número de capas de perceptrones, mayor será la capacidad de tomar decisiones, algo aplicable en numerosos ámbitos.
Pero ¿por qué el aprendizaje profundo está despegando justo ahora? Una respuesta es que, gracias al aumento de la potencia informática, es posible procesar rápidamente las entradas y generar resultados. Curiosamente, en 2009 se descubrió que los chips especializados utilizados en ordenadores y consolas de videojuegos para generar gráficos complejos también eran muy adecuados para modelar redes neuronales. Además, el auge de Internet ha puesto a disposición una gran cantidad de documentos, vídeos y fotos para el entrenamiento.
El aprendizaje profundo y las RNA han transformado el mundo de la inteligencia artificial en los últimos años. Más aún, han desempeñado un papel importante en la mejora de la «inteligencia» de la IA. Las tareas y capacidades que antes se consideraban propias de los seres humanos ahora las realizan redes neuronales profundas. El aprendizaje profundo permitió que una máquina venciera al mejor jugador de Go del mundo.
Implicaciones para las empresas
Esto demuestra que, con enormes cantidades de datos y potencia informática, las máquinas ya pueden reconocer objetos, traducir el habla, entrenarse para identificar patrones complejos, aprender a diseñar estrategias y elaborar planes de contingencia en tiempo real. La inteligencia artificial no solo puede realizar tareas. Está empezando a pensar.
Las empresas estudian ahora la posibilidad de utilizar el aprendizaje profundo en puertos y aeropuertos para detectar armas ocultas. En el ámbito financiero, el mundo del comercio algorítmico y la gestión de activos se ha orientado cada vez más hacia el aprendizaje profundo. Los gestores de activos lo utilizan para buscar patrones generales en múltiples fuentes de datos, como recibos de envíos, opiniones de clientes en Twitter y discursos de miembros de la Reserva Federal, por citar solo algunos ejemplos. Cabe señalar que, dado que la mayoría de estos datos no están estructurados, sería casi imposible crear modelos predictivos sencillos con modelos estadísticos convencionales.
Sin embargo, el aprendizaje profundo permite analizar datos sin etiquetar, encontrar patrones y obtener conocimientos. Esto ayuda a comprender mejor las correlaciones entre diversas fuentes de datos y a hacer predicciones. Por ejemplo, al aplicar métodos de aprendizaje profundo a las finanzas, los investigadores han podido obtener resultados más útiles que con los modelos estadísticos y económicos convencionales. El aprendizaje profundo se ha utilizado para detectar y aprovechar interacciones en los datos que, al menos por ahora, son invisibles para cualquier teoría económica financiera existente.
En el próximo artículo veremos otro avance relacionado, llamado procesamiento del lenguaje natural y computación afectiva, antes de reunirlos todos bajo el paraguas de la inteligencia artificial.





