En las películas de Iron Man, Tony Stark utiliza un ordenador holográfico para proyectar datos en 3D en el aire, manipularlos con las manos y encontrar soluciones a sus problemas de superhéroe. En la misma línea, investigadores del MIT y de la Universidad de Brown han desarrollado ahora un sistema de análisis interactivo de datos que funciona en pantallas táctiles y permite a todos —no solo a genios tecnológicos multimillonarios— abordar problemas del mundo real.
Durante años, los investigadores han estado desarrollando un sistema interactivo de ciencia de datos llamado Northstar, que funciona en la nube, pero dispone de una interfaz compatible con cualquier dispositivo táctil, incluidos los teléfonos inteligentes y las grandes pizarras interactivas. Los usuarios introducen conjuntos de datos en el sistema y los manipulan, combinan y extraen características en una interfaz fácil de usar, con los dedos o con un lápiz digital, para descubrir tendencias y patrones.
En un artículo que se presentará en la conferencia ACM SIGMOD, los investigadores describen un nuevo componente de Northstar, llamado VDS por «científico de datos virtual», que genera de forma instantánea modelos de aprendizaje automático para ejecutar tareas de predicción sobre sus conjuntos de datos. Los médicos, por ejemplo, pueden usar el sistema para ayudar a predecir qué pacientes tienen más probabilidades de padecer determinadas enfermedades, mientras que los propietarios de negocios podrían querer pronosticar las ventas. Si se utiliza una pizarra interactiva, todos también pueden colaborar en tiempo real.
El objetivo es democratizar la ciencia de datos, facilitando la realización de análisis complejos de forma rápida y precisa.
«Incluso un propietario de una cafetería que no sabe de ciencia de datos debería poder predecir sus ventas de las próximas semanas para calcular cuánto café tiene que comprar», afirma el coautor y responsable de larga trayectoria del proyecto Northstar, Tim Kraska, profesor asociado de ingeniería eléctrica e informática en el Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT y codirector fundador del nuevo Laboratorio de Sistemas de Datos e IA (DSAIL). «En las empresas que tienen científicos de datos hay mucho ir y venir entre los científicos de datos y los no expertos, así que también podemos reunirlos en una misma sala para hacer análisis juntos.»
VDS se basa en una técnica cada vez más popular en inteligencia artificial llamada aprendizaje automático automatizado (AutoML), que permite a personas con conocimientos limitados de ciencia de datos entrenar modelos de IA para hacer predicciones basadas en sus conjuntos de datos. Actualmente, la herramienta lidera la competición DARPA D3M Automatic Machine Learning, que cada seis meses decide cuál es la herramienta AutoML con mejor rendimiento.
Junto a Kraska, en el artículo participan: el primer autor, Zeyuan Shang, estudiante de posgrado, y Emanuel Zgraggen, becario postdoctoral y principal colaborador de Northstar, ambos de EECS, CSAIL y DSAIL; Benedetto Buratti, Yeounoh Chung, Philipp Eichmann y Eli Upfal, todos de Brown; y Carsten Binnig, que recientemente se trasladó de Brown a la Universidad Técnica de Darmstadt, en Alemania.

Un «lienzo sin límites» para el análisis
El nuevo trabajo se basa en años de colaboración en Northstar entre investigadores del MIT y de Brown. Durante cuatro años, los investigadores han publicado numerosos artículos que detallan componentes de Northstar, como la interfaz interactiva, las operaciones en múltiples plataformas, la aceleración de resultados y los estudios sobre el comportamiento de los usuarios.
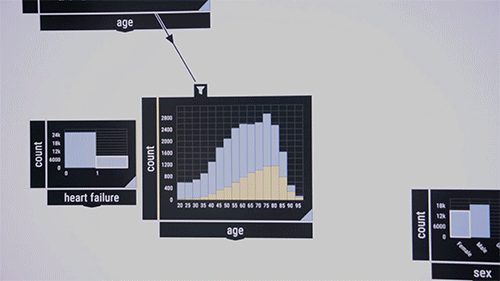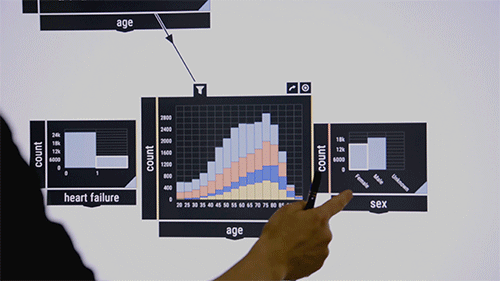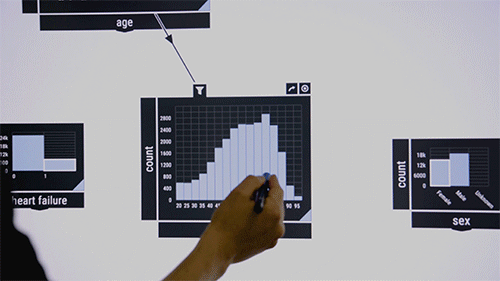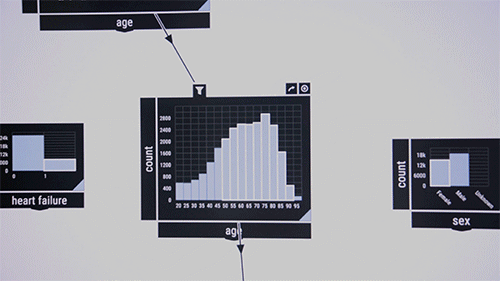
Northstar comienza como una interfaz en blanco. Los usuarios cargan conjuntos de datos en el sistema, que aparecen en un recuadro de «conjuntos de datos» a la izquierda. Las etiquetas de datos se rellenan automáticamente en un recuadro independiente de «atributos» situado debajo. También hay un recuadro de «operadores» que contiene diversos algoritmos, así como la nueva herramienta AutoML. Todos los datos se almacenan y analizan en la nube.
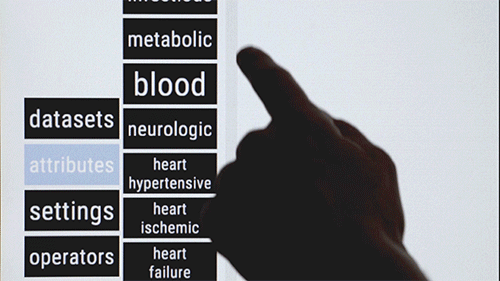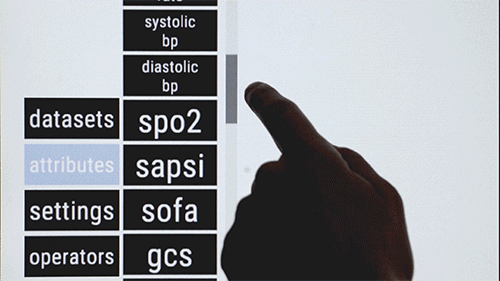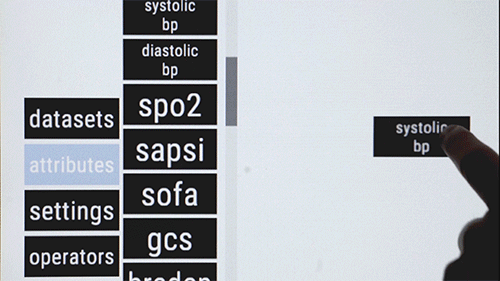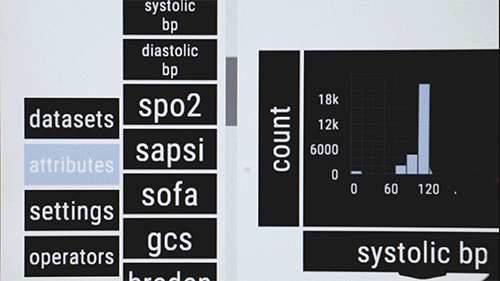
Los investigadores suelen demostrar el sistema con un conjunto de datos público que contiene información sobre pacientes de unidades de cuidados intensivos. Consideremos a investigadores médicos que quieren examinar las coocurrencias de determinadas enfermedades en determinados grupos de edad. Arrastran y sueltan en el centro de la interfaz un algoritmo de comprobación de patrones, que al principio aparece como un recuadro en blanco. Como entrada, introducen en el recuadro características de enfermedades etiquetadas como, por ejemplo, «sangre», «infecciosa» y «metabólica». Los porcentajes de esas enfermedades en el conjunto de datos aparecen en el recuadro. Después, arrastran la característica «edad» a la interfaz, que muestra un gráfico de barras con la distribución de edades de los pacientes. Al trazar una línea entre los dos recuadros, se vinculan entre sí. Al rodear con un círculo los rangos de edad, el algoritmo calcula de inmediato la coocurrencia de las tres enfermedades en ese rango de edad.
«Es como un gran lienzo sin límites en el que puedes disponer todo como quieras», afirma Zgraggen, principal inventor de la interfaz interactiva de Northstar. «Luego, puedes vincular elementos entre sí para crear preguntas más complejas sobre tus datos.»
Aproximación de AutoML
Con VDS, los usuarios también pueden ejecutar análisis predictivos sobre esos datos obteniendo modelos personalizados para sus tareas, como la predicción de datos, la clasificación de imágenes o el análisis de estructuras de grafos complejas.
Siguiendo el ejemplo anterior, supongamos que los investigadores médicos quieren predecir qué pacientes pueden padecer una enfermedad de la sangre a partir de todas las características del conjunto de datos. Arrastran y sueltan «AutoML» desde la lista de algoritmos. Al principio aparecerá un recuadro en blanco, pero con una pestaña «objetivo», en la que soltarían la característica «sangre». El sistema encontrará automáticamente las canalizaciones de aprendizaje automático con mejor rendimiento, presentadas como pestañas con porcentajes de precisión que se actualizan constantemente. Los usuarios pueden detener el proceso en cualquier momento, afinar la búsqueda y examinar la tasa de errores, la estructura, los cálculos de cada modelo y otros aspectos.
Según los investigadores, VDS es, hasta la fecha, la herramienta AutoML interactiva más rápida, gracias en parte a su «motor de estimación» personalizado. El motor se sitúa entre la interfaz y el almacenamiento en la nube. El motor aprovecha y crea automáticamente varias muestras representativas de un conjunto de datos que pueden procesarse de forma progresiva para producir resultados de alta calidad en segundos.
«Junto con mis coautores dediqué dos años a diseñar VDS para imitar la forma de pensar de un científico de datos», afirma Shang, lo que significa que identifica de inmediato qué modelos y pasos de preprocesamiento debe o no debe ejecutar en determinadas tareas, según diversas reglas codificadas. Primero elige entre una amplia lista de esas posibles canalizaciones de aprendizaje automático y ejecuta simulaciones sobre el conjunto de muestra. Al hacerlo, recuerda los resultados y afina su selección. Tras entregar resultados aproximados rápidos, el sistema los refina en segundo plano. Pero las cifras finales suelen estar muy cerca de la primera aproximación.
«Para usar un predictor, no quieres esperar cuatro horas para obtener tus primeros resultados. Quieres ver ya lo que está pasando y, si detectas un error, puedes corregirlo de inmediato. Normalmente, eso no es posible en ningún otro sistema», afirma Kraska. El estudio previo de usuarios de los investigadores, de hecho, «muestra que, en el momento en que retrasas los resultados a los usuarios, empiezan a perder interés por el sistema».
Los investigadores evaluaron la herramienta con 300 conjuntos de datos del mundo real. En comparación con otros sistemas AutoML de última generación, las aproximaciones de VDS fueron igual de precisas, pero se generaron en segundos, lo que es mucho más rápido que otras herramientas, que operan en minutos u horas.
A continuación, los investigadores buscan añadir una función que alerte a los usuarios sobre posibles sesgos o errores en los datos. Por ejemplo, para proteger la privacidad de los pacientes, a veces los investigadores etiquetan conjuntos de datos médicos con pacientes de 0 años (si no se conoce su edad) y 200 (si el paciente tiene más de 95 años). Pero los principiantes pueden no reconocer estos errores, que podrían alterar por completo sus análisis.
«Si eres un usuario nuevo, puede que obtengas resultados y pienses que son estupendos», afirma Kraska. «Pero podemos advertir a la gente de que, de hecho, puede haber valores atípicos en el conjunto de datos que podrían indicar un problema.»




