En la Tierra hay aproximadamente 10 billones de gigabytes de datos digitales, cifra que aumenta rápidamente cada día a medida que los seres humanos producen más.
Los centros de datos de exabytes contienen grandes cantidades de estos datos y cuestan alrededor de 1000 millones de dólares en construirlos y mantenerlos.
Científicos del MIT trabajan en un método más eficaz para almacenar datos con ADN, que puede contener cantidades masivas a una densidad muy alta.
Aunque esta investigación es prometedora, se necesitan más conocimientos antes de que el ADN pueda convertirse en un medio de almacenamiento viable.
En la Tierra, en este momento, hay unos 10 billones de gigabytes de datos digitales, y cada día los seres humanos producen correos electrónicos, fotos, tuits y otros archivos digitales que suman otros 2,5 millones de gigabytes de datos. Gran parte de estos datos se almacena en enormes instalaciones conocidas como centros de datos de exabytes (un exabyte equivale a 1000 millones de gigabytes), que pueden tener el tamaño de varios campos de fútbol y cuestan alrededor de 1000 millones de dólares en construirlos y mantenerlos.
Muchos científicos creen que una solución alternativa reside en la molécula que contiene nuestra información genética: el ADN, que evolucionó para almacenar cantidades masivas de información a una densidad muy alta. Una taza de café llena de ADN podría, en teoría, almacenar todos los datos del mundo, afirma Mark Bathe, profesor de ingeniería biológica del MIT.
«Necesitamos nuevas soluciones para almacenar las enormes cantidades de datos que acumula el mundo, especialmente los datos de archivo», afirma Bathe, que también es miembro asociado del Broad Institute of MIT and Harvard. «El ADN es mil veces más denso que incluso la memoria flash, y otra propiedad interesante es que, una vez fabricado el polímero de ADN, no consume energía. Puedes escribir el ADN y luego almacenarlo para siempre».
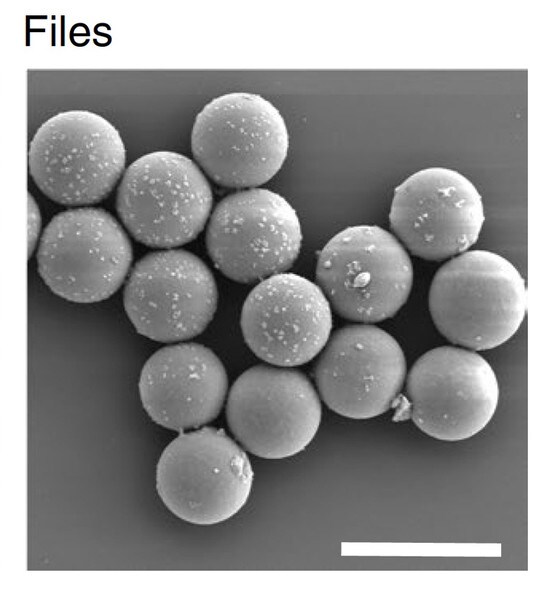
Los científicos ya han demostrado que pueden codificar imágenes y páginas de texto como ADN. Sin embargo, también se necesitará una forma sencilla de seleccionar el archivo deseado de una mezcla de muchos fragmentos de ADN. Bathe y sus colegas han demostrado ahora una forma de hacerlo, encapsulando cada archivo de datos en una partícula de sílice de 6 micrómetros, etiquetada con secuencias cortas de ADN que revelan su contenido.
Con este enfoque, los investigadores demostraron que podían extraer con precisión imágenes individuales almacenadas como secuencias de ADN a partir de un conjunto de 20 imágenes. Dado el número de etiquetas posibles que podrían utilizarse, este enfoque podría escalar hasta 1020 archivos.
Bathe es el autor principal del estudio, que se publica hoy en Nature Materials. Los autores principales del artículo son James Banal, investigador postdoctoral sénior del MIT, Tyson Shepherd, antiguo investigador asociado del MIT, y Joseph Berleant, estudiante de posgrado del MIT.
Almacenamiento estable
Los sistemas de almacenamiento digital codifican textos, fotos o cualquier otro tipo de información como una serie de 0 y 1. Esta misma información puede codificarse en ADN utilizando los cuatro nucleótidos que componen el código genético: A, T, G y C. Por ejemplo, G y C podrían usarse para representar el 0, mientras que A y T representan el 1.
El ADN tiene otras características que lo hacen deseable como medio de almacenamiento: es extremadamente estable y relativamente fácil (aunque costoso) de sintetizar y secuenciar. Además, debido a su alta densidad —cada nucleótido, equivalente a hasta dos bits, mide alrededor de 1 nanómetro cúbico—, un exabyte de datos almacenado como ADN cabría en la palma de la mano.
Un obstáculo para este tipo de almacenamiento de datos es el coste de sintetizar cantidades tan grandes de ADN. Actualmente, escribir un petabyte de datos (1 millón de gigabytes) costaría 1 billón de dólares. Para ser competitivo con la cinta magnética, que a menudo se utiliza para almacenar datos de archivo, Bathe estima que el coste de la síntesis de ADN tendría que reducirse en unos seis órdenes de magnitud. Bathe afirma que prevé que eso ocurrirá en una o dos décadas, de forma similar a como el coste de almacenar información en memorias flash ha caído drásticamente en las últimas dos décadas.
Al margen del coste, el otro gran cuello de botella para usar el ADN como almacenamiento de datos es la dificultad de seleccionar el archivo que se quiere entre todos los demás.
«Suponiendo que las tecnologías de escritura de ADN lleguen a un punto en que sea rentable escribir un exabyte o un zettabyte de datos en ADN, ¿y qué? Tendrás una pila de ADN con un sinfín de archivos, imágenes, películas y otras cosas, y necesitarás encontrar la única imagen o película que buscas», afirma Bathe. «Es como intentar encontrar una aguja en un pajar».
Actualmente, los archivos de ADN se recuperan de forma convencional mediante PCR (reacción en cadena de la polimerasa). Cada archivo de datos de ADN incluye una secuencia que se une a un cebador de PCR concreto. Para extraer un archivo específico, se añade ese cebador a la muestra para localizar y amplificar la secuencia deseada. Sin embargo, un inconveniente de este enfoque es que puede haber interferencias cruzadas entre el cebador y secuencias de ADN no objetivo, lo que hace que se extraigan archivos no deseados. Además, el proceso de recuperación por PCR requiere enzimas y acaba consumiendo la mayor parte del ADN que había en la mezcla.
«Es como quemar el pajar para encontrar la aguja, porque el resto del ADN no se amplifica y básicamente lo estás desechando», afirma Bathe.
Recuperación de archivos
Como alternativa, el equipo del MIT desarrolló una nueva técnica de recuperación que consiste en encapsular cada archivo de ADN en una pequeña partícula de sílice. Cada cápsula está etiquetada con «códigos de barras» de ADN monocatenario que corresponden al contenido del archivo. Para demostrar este enfoque de manera rentable, los investigadores codificaron 20 imágenes diferentes en fragmentos de ADN de unos 3000 nucleótidos de longitud, lo que equivale a unos 100 bytes. (También demostraron que las cápsulas podían contener archivos de ADN de hasta un gigabyte de tamaño).
Cada archivo se etiquetó con códigos de barras que corresponden a etiquetas como «gato» o «avión». Cuando los investigadores quieren extraer una imagen específica, toman una muestra del ADN y añaden cebadores que corresponden a las etiquetas que buscan; por ejemplo, «gato», «naranja» y «salvaje» para una imagen de un tigre, o «gato», «naranja» y «doméstico» para un gato de casa.
Los cebadores están marcados con partículas fluorescentes o magnéticas, lo que facilita extraer e identificar cualquier coincidencia de la muestra. Esto permite retirar el archivo deseado y dejar el resto del ADN intacto para volver a almacenarlo. Su proceso de recuperación permite que sentencias lógicas booleanas como «presidente Y siglo XVIII» generen como resultado a George Washington, de forma similar a lo que se obtiene con una búsqueda de imágenes en Google.
«En el estado actual de nuestra prueba de concepto, estamos en una velocidad de búsqueda de 1 kilobyte por segundo. La velocidad de búsqueda de nuestro sistema de archivos está determinada por el tamaño de datos por cápsula, que actualmente está limitado por el coste prohibitivo de escribir incluso 100 megabytes de datos en ADN, y por el número de clasificadores que podemos usar en paralelo. Si la síntesis de ADN se abarata lo suficiente, podríamos maximizar el tamaño de datos que podemos almacenar por archivo con nuestro enfoque», afirma Banal.
Para sus códigos de barras, los investigadores utilizaron secuencias de ADN monocatenario de una biblioteca de 100 000 secuencias, de unos 25 nucleótidos de longitud cada una, desarrollada por Stephen Elledge, profesor de genética y medicina en la Facultad de Medicina de Harvard. Si se colocan dos de estas etiquetas en cada archivo, se pueden etiquetar de forma única 1010 (10 000 millones) de archivos diferentes, y con cuatro etiquetas en cada uno, se pueden etiquetar de forma única 1020 archivos.
George Church, profesor de genética en la Facultad de Medicina de Harvard, describe la técnica como «un gran salto para la gestión del conocimiento y la tecnología de búsqueda».
¿Qué está haciendo el Foro Económico Mundial sobre la Cuarta Revolución Industrial?
El Centro para Tecnologías de Frontera e Innovación reúne a científicos, responsables políticos y líderes empresariales para comprender las tecnologías emergentes y sus implicaciones en el mundo real.
Al facilitar la colaboración y la experimentación, el Centro ayuda a los socios a traducir la innovación de la investigación en aplicaciones prácticas que abordan desafíos globales compartidos.
«El rápido avance en la escritura, copia y lectura, así como en el almacenamiento de datos de archivo de bajo consumo energético en forma de ADN, ha dejado poco exploradas las oportunidades para la recuperación precisa de archivos de datos en bases de datos enormes (de 1021 bytes, a escala zetta)», afirma Church, quien no participó en el estudio. «El nuevo estudio aborda esto de manera espectacular mediante una capa externa de ADN completamente independiente y aprovechando diferentes propiedades del ADN (hibridación en lugar de secuenciación), y además, utilizando instrumentos y químicas ya existentes».
Bathe prevé que este tipo de encapsulación de ADN podría ser útil para almacenar datos «fríos», es decir, datos que se guardan en un archivo y a los que no se accede con mucha frecuencia. Su laboratorio está creando una startup, Cache DNA, que actualmente desarrolla tecnología para el almacenamiento a largo plazo de ADN, tanto para el almacenamiento de datos de ADN a largo plazo como para muestras clínicas y otras muestras de ADN preexistentes a corto plazo.
«Aunque puede que todavía pase un tiempo antes de que el ADN sea viable como medio de almacenamiento de datos, ya existe una necesidad apremiante de soluciones de almacenamiento masivo de bajo coste para muestras de ADN y ARN preexistentes procedentes de las pruebas de Covid-19, la secuenciación genómica humana y otras áreas de la genómica», afirma Bathe.
La investigación fue financiada por la Oficina de Investigación Naval, la Fundación Nacional de Ciencias y la Oficina de Investigación del Ejército de los Estados Unidos.




