Con la ayuda de varios socios de investigación, DeepMind ha publicado una base de datos que contiene las estructuras de casi todas las proteínas del cuerpo humano.
Estas estructuras se determinan computacionalmente mediante AlphaFold, un revolucionario sistema de plegamiento de proteínas.
La base de datos es de uso gratuito para cualquier persona y podría convertirse en una herramienta transformadora en biología y medicina.
DeepMind y varios socios de investigación han publicado una base de datos con las estructuras 3D de casi todas las proteínas del cuerpo humano, determinadas computacionalmente por el revolucionario sistema de plegamiento de proteínas presentado el año pasado, AlphaFold. La base de datos de acceso libre representa un enorme avance y una gran comodidad para científicos de cientos de disciplinas y campos, y bien podría sentar las bases de una nueva etapa en la biología y la medicina.
La Base de datos de estructuras de proteínas AlphaFold es una colaboración entre DeepMind, el Instituto Europeo de Bioinformática y otros, y consta de cientos de miles de secuencias de proteínas cuyas estructuras han sido predichas por AlphaFold; el plan es añadir millones más para crear un «almanaque proteico del mundo».
«Creemos que este trabajo representa la contribución más significativa que la IA ha hecho hasta la fecha al avance del conocimiento científico, y es un gran ejemplo de los tipos de beneficios que la IA puede aportar a la sociedad», afirmó Demis Hassabis, fundador y CEO de DeepMind.
Del genoma al proteoma
Si no estás familiarizado con la proteómica en general —y es completamente natural si ese es el caso—, quizá la mejor forma de pensarlo sea en función de otro gran esfuerzo: la secuenciación del genoma humano. Como quizá recuerdes de finales de los años noventa y principios de los dos mil, fue una tarea enorme emprendida por un gran grupo de científicos y organizaciones de todo el mundo durante muchos años. El genoma, finalmente terminado, ha sido fundamental para el diagnóstico y la comprensión de innumerables afecciones, así como para el desarrollo de fármacos y tratamientos contra ellas.
Sin embargo, fue solo el inicio del trabajo en ese campo; algo así como terminar todas las piezas de los bordes de un gigantesco rompecabezas. Y uno de los siguientes grandes proyectos hacia los que todos volvieron la mirada en aquellos años fue comprender el proteoma —es decir, todas las proteínas utilizadas por el cuerpo humano y codificadas en el genoma.
El problema del proteoma es que es mucho, mucho más complejo. Las proteínas, como el ADN, son secuencias de moléculas conocidas; en el ADN son las pocas bases familiares (adenina, guanina, etc.), pero en las proteínas son los 20 aminoácidos (cada uno de los cuales está codificado por múltiples bases en los genes). Esto por sí solo añade mucha más complejidad, pero es solo el comienzo. Las secuencias no son simplemente «código», sino que se retuercen y pliegan hasta convertirse en diminutas máquinas de origami molecular que realizan todo tipo de tareas dentro de nuestro cuerpo. Es como pasar del código binario a un lenguaje complejo que da forma a objetos en el mundo real.
En la práctica, esto significa que el proteoma no está formado solo por 20.000 secuencias de cientos de aminoácidos cada una, sino que cada una de esas secuencias tiene una estructura física y una función. Una de las partes más difíciles de comprenderlas es determinar qué forma adopta una secuencia dada. Esto suele hacerse de forma experimental, mediante técnicas como la cristalografía de rayos X, un proceso largo y complejo que puede llevar meses o incluso más determinar una sola proteína, si se dispone de los mejores laboratorios y técnicas. La estructura también puede predecirse computacionalmente, aunque el proceso nunca había sido lo bastante bueno como para confiar en él, hasta que llegó AlphaFold.
Un campo tomado por sorpresa
Sin entrar en toda la historia de la proteómica computacional (por mucho que me gustaría), pasamos esencialmente de tácticas distribuidas de fuerza bruta hace 15 años —¿recuerdan Folding@home?— a procesos más depurados en la última década. Luego, los enfoques basados en IA irrumpieron con fuerza en 2019, cuando AlphaFold de DeepMind superó con un salto a todos los demás sistemas del mundo; después dio otro salto en 2020, alcanzando niveles de precisión y fiabilidad tan altos que algunos expertos declararon resuelto el problema de convertir una secuencia arbitraria en una estructura 3D.
Solo comprimo esta larga historia en un párrafo porque fue ampliamente cubierta en su momento, pero es difícil exagerar lo repentino y completo que fue este avance. Se trataba de un problema que había desconcertado a las mejores mentes del mundo durante décadas, y pasó de «quizás tenemos un enfoque que funciona más o menos, pero de forma extremadamente lenta y a un gran coste» a «preciso, fiable y realizable con ordenadores convencionales» en el espacio de un año.
Los detalles de los avances de DeepMind y de cómo los logró los dejaré en manos de especialistas en biología computacional y proteómica, quienes sin duda analizarán y perfeccionarán este trabajo en los próximos meses y años. Lo que nos interesa hoy son los resultados prácticos, ya que desde la publicación de AlphaFold 2 (la versión presentada en 2020) la empresa dedicó su tiempo no solo a ajustar el modelo, sino a ejecutarlo… sobre cada una de las secuencias de proteínas que pudo obtener.
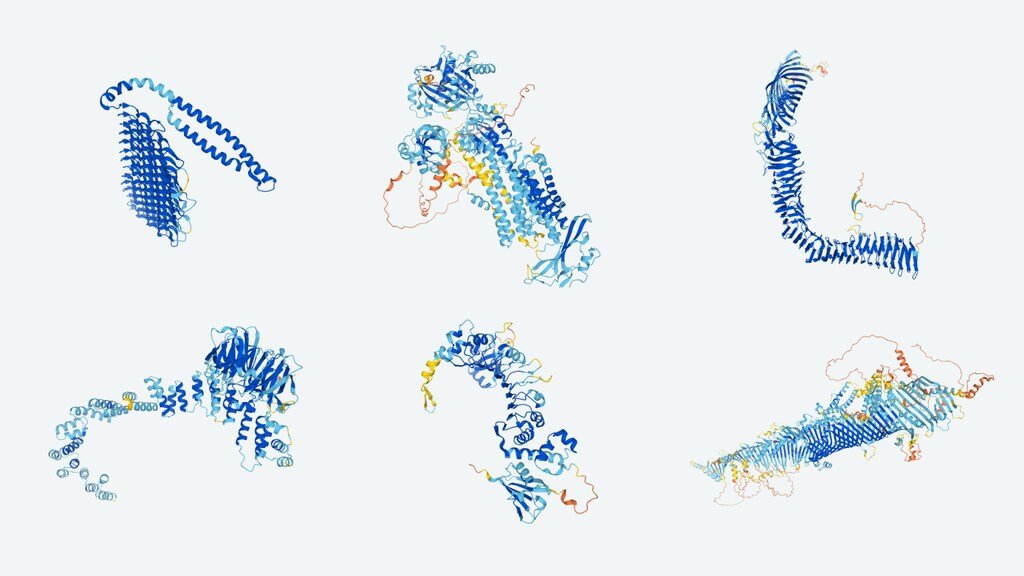
El resultado es que el 98,5 % del proteoma humano está ahora «plegado», como se dice, lo que significa que existe una estructura predicha en la que el modelo de IA confía lo suficiente (y, lo que es importante, nosotros confiamos lo suficiente en su confianza) representa lo real. Ah, y además plegaron el proteoma de 20 otros organismos, como la levadura y E. coli, lo que suma unas 350.000 estructuras de proteínas en total. Es, con mucho —en órdenes de magnitud—, la colección más grande y mejor de esta información absolutamente crucial.
Todo ello estará disponible como una base de datos de navegación libre en la que cualquier investigador puede simplemente introducir una secuencia o el nombre de una proteína y obtener de inmediato la estructura 3D. Los detalles del proceso y de la base de datos pueden consultarse en un artículo publicado hoy en la revista Nature.
«La base de datos, tal como la verán mañana, es una barra de búsqueda, casi como Google para estructuras de proteínas», dijo Hassabis en una entrevista con TechCrunch. «Se puede visualizar en el visualizador 3D, hacer zoom, interrogar la secuencia genética… y lo bueno de hacerlo con EMBL-EBI es que está vinculada a todas sus otras bases de datos. Así que puedes ir de inmediato a ver genes relacionados. Y está vinculada a todas estas otras bases de datos; puedes ver genes relacionados, relacionados en otros organismos, otras proteínas con funciones relacionadas, etcétera.»
«Como científico/a que trabaja con una proteína casi inconcebible», dijo Edith Heard, de EMBL-EBI (no especificó qué proteína), «es realmente emocionante saber que ahora se puede averiguar cuál es el extremo activo de una proteína en tan poco tiempo; habría llevado años. Así que poder acceder a la estructura y decir “¡ajá, esto es el extremo activo”, puedes entonces centrarte en averiguar qué hace ese extremo activo. Y creo que esto acelera la ciencia en pasos de años, algo parecido a lo que hizo hace décadas la capacidad de secuenciar genomas.»
Tan nueva es la idea misma de poder hacer esto que Hassabis afirmó que espera plenamente que todo el campo cambie, y que la base de datos cambie con él.
«Los biólogos estructurales aún no están acostumbrados a la idea de que puedan buscar cualquier cosa en cuestión de segundos, en lugar de tardar años en determinar experimentalmente estas cosas», dijo. «Y creo que eso debería dar lugar a tipos de enfoques totalmente nuevos para las preguntas que se pueden plantear y los experimentos que se pueden realizar. Una vez que empecemos a percibirlo, podríamos empezar a construir otras herramientas que respondan a este tipo de serendipia: ¿y si quiero analizar 10.000 proteínas relacionadas de una forma particular? No hay realmente una manera normal de hacerlo, porque no es una pregunta normal que alguien haría actualmente. Así que imagino que tendremos que empezar a producir nuevas herramientas, y habrá demanda de ellas una vez que empecemos a ver cómo interactúa la gente con esto.»
Eso incluye versiones derivadas y mejoradas de forma incremental del propio software, que se ha publicado como código abierto junto con una amplia historia de desarrollo. Ya hemos visto un sistema desarrollado de forma independiente, RoseTTAFold, de investigadores del Laboratorio Baker de la Universidad de Washington, que extrapoló el rendimiento de AlphaFold del año pasado para crear algo similar pero más eficiente; aunque DeepMind parece haber recuperado la delantera con su última versión. Pero se dejó claro que la «salsa secreta» está al alcance de todos.




