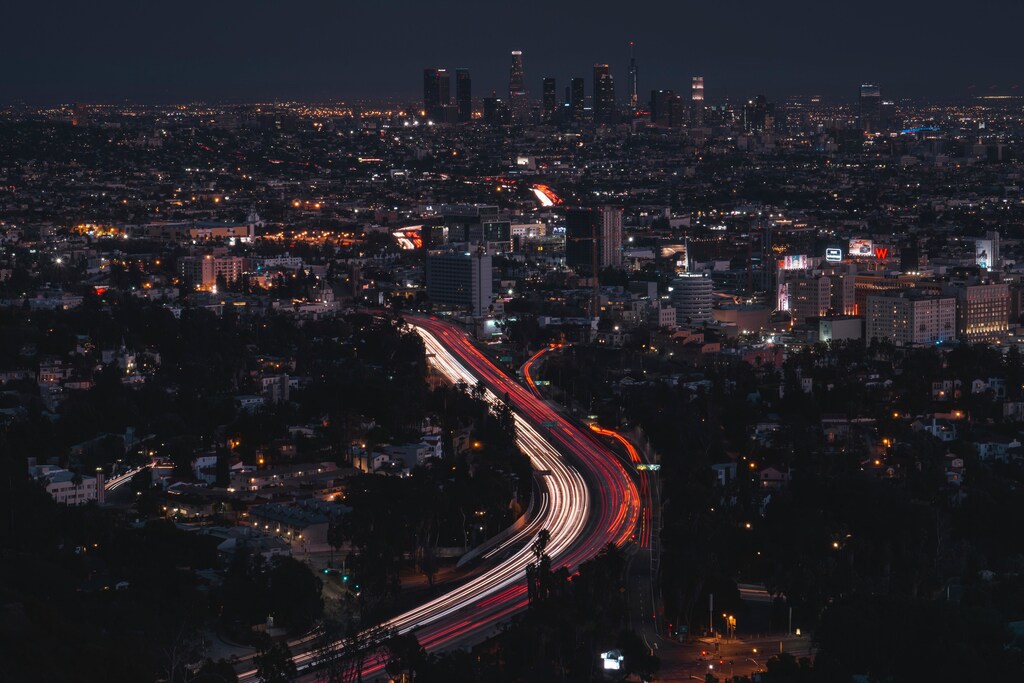
Científicos del MIT y del Centro de Inteligencia Artificial de Catar han desarrollado un modelo de aprendizaje profundo que predice mapas de riesgo de accidentes de muy alta resolución.
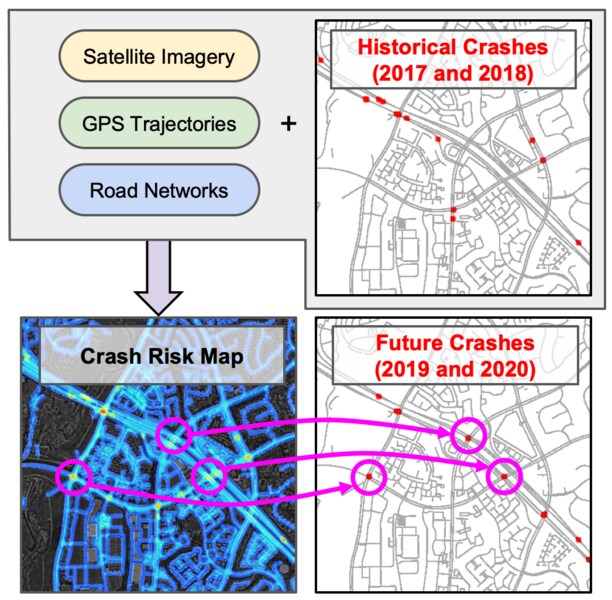
Esta tecnología combina datos históricos de accidentes, mapas de carreteras, imágenes satelitales y GPS.
Para crear el modelo, los científicos utilizaron datos sobre accidentes de 2017 y 2018 y evaluaron su capacidad para predecir los accidentes ocurridos en 2019 y 2020
El conjunto de datos abarcaba 7.500 kilómetros cuadrados de Los Ángeles, Nueva York, Chicago y Boston; Los Ángeles registró la mayor densidad de accidentes.
El acceso a esta información puede permitir a las personas actuar con antelación para reducir el riesgo de los trayectos que realizan.
El mundo actual es un gran laberinto, conectado por capas de hormigón y asfalto que nos ofrecen el lujo de desplazarnos en vehículo. Muchos de nuestros avances relacionados con las carreteras —el GPS nos permite esforzarnos menos gracias a las aplicaciones de mapas, las cámaras nos avisan de roces y arañazos potencialmente costosos, y los coches eléctricos autónomos tienen menores costes de combustible— han dejado atrás nuestras medidas de seguridad. Seguimos dependiendo de una dieta constante de semáforos, confianza y el acero que nos rodea para ir de forma segura del punto A al punto B.
Para anticiparse a la incertidumbre inherente a los accidentes, científicos del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT y del Centro de Inteligencia Artificial de Catardesarrollaron un modelo de aprendizaje profundo que predice mapas de riesgo de accidentes de muy alta resolución. Alimentados con una combinación de datos históricos de accidentes, mapas de carreteros, imágenes satelitales y recorridos GPS, los mapas de riesgo describen el número previsto de accidentes durante un período futuro, para identificar zonas de alto riesgo y predecir accidentes.
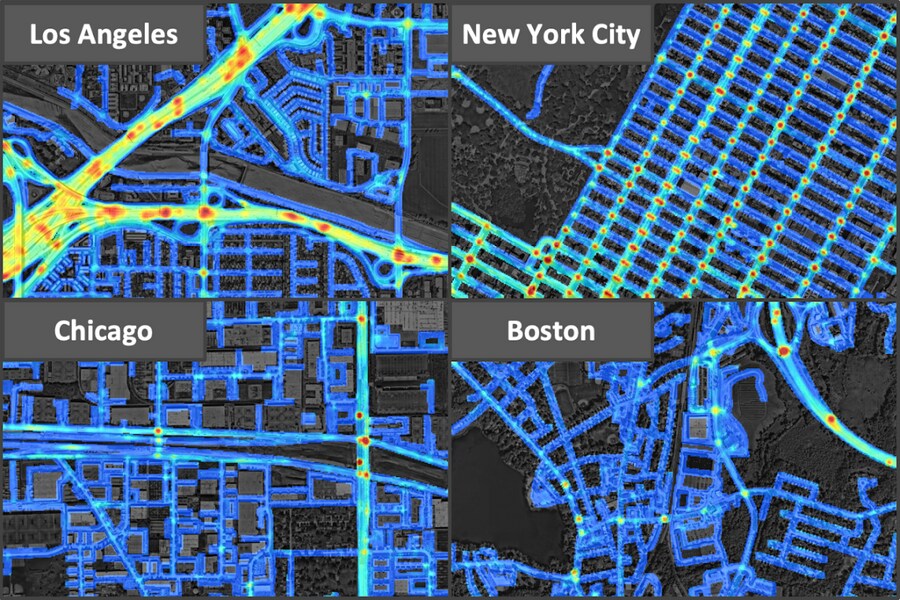
Por lo general, estos mapas de riesgo se elaboran con resoluciones mucho menores, de unos cientos de metros, lo que hace que se pasen por alto detalles cruciales, pues las carreteras se difuminan entre sí. En cambio, estos mapas se componen de celdas de cuadrícula de 5x5 metros, y la mayor resolución aporta una claridad nueva: los científicos descubrieron que, por ejemplo, una autopista presenta más riesgo que las carreteras residenciales cercanas, y que los ramales de incorporación y salida de la autopista conllevan un riesgo aún mayor que otras vías.
«Al capturar la distribución subyacente del riesgo que determina la probabilidad de futuros accidentes en todos los lugares, y sin ningún dato histórico, podemos encontrar rutas más seguras, permitir que las compañías de seguros de automóviles ofrezcan planes de seguro personalizados basados en los trayectos de conducción de sus clientes, ayudar a los urbanistas a diseñar carreteras más seguras e incluso predecir futuros accidentes», afirma Songtao He, estudiante de doctorado del MIT CSAIL y autor principal de un nuevoartículo sobre la investigación.
Aunque los accidentes de tráfico son poco frecuentes, cuestan alrededor del 3 por ciento del PIB mundial y son la principal causa de muerte entre niños y adultos jóvenes. Esta escasez dificulta inferir mapas con una resolución tan alta. Los accidentes de este nivel están muy dispersos: la probabilidad media anual de que ocurra un accidente en una celda de cuadrícula de 5x5 es de aproximadamente una entre 1.000, y rara vez ocurren dos veces en el mismo lugar. Los intentos anteriores de predecir el riesgo de accidentes han sido en gran medida «históricos»: una zona solo se consideraba de alto riesgo si ya había ocurrido un accidente cerca.
El enfoque del equipo abarca un campo más amplio para captar datos importantes. Identifica lugares de alto riesgo mediante patrones de trayectorias GPS, que aportan información sobre la densidad, la velocidad y la dirección del tráfico, e imágenes satelitales que describen las estructuras viales, como el número de carriles, si hay arcén o si circulan muchos peatones. Así, aunque no consten accidentes en una zona de alto riesgo, esta puede identificarse como tal basándose únicamente en sus patrones de tráfico y su topología.
Para evaluar el modelo, los científicos utilizaron datos sobre accidentes de 2017 y 2018 y evaluaron su capacidad para predecir los accidentes ocurridos en 2019 y 2020. Se identificaron muchos lugares como zonas de alto riesgo, aunque no constaban accidentes en ellos, y también se produjeron accidentes allí durante los años posteriores.
«Nuestro modelo puede generalizar de una ciudad a otra al combinar varias pistas procedentes de fuentes de datos aparentemente inconexas. Es un paso hacia la inteligencia artificial general, porque nuestro modelo puede predecir mapas de accidentes en territorios inexplorados», afirma Amin Sadeghi, científico principal del Instituto de Investigación Informática de Catar (QCRI) y coautor del artículo. «El modelo puede utilizarse para inferir un mapa de accidentes útil incluso cuando no hay datos históricos de accidentes, lo que podría tener un efecto positivo en la planificación urbana y la elaboración de políticas al comparar escenarios hipotéticos».
El conjunto de datos abarcaba 7.500 kilómetros cuadrados de Los Ángeles, Nueva York, Chicago y Boston. De las cuatro ciudades, Los Ángeles era la menos segura, pues tenía la mayor densidad de accidentes, seguido de Nueva York, Chicago y Boston.
«Si las personas pueden utilizar el mapa de riesgo para identificar tramos de carretera potencialmente peligrosos, pueden actuar con antelación para reducir el riesgo de los trayectos que realizan. Aplicaciones como Waze y Apple Maps tienen funciones para informar de incidentes, pero nosotros intentamos anticiparnos a los accidentes, antes de que ocurran», afirma He.
He y Sadeghi escribieron el artículo junto con Sanjay Chawla, director de investigación del QCRI, y los profesores de ingeniería eléctrica y ciencias de la computación del MIT Mohammad Alizadeh, Hari Balakrishnan y Sam Madden. Presentarán el artículo en la Conferencia Internacional sobre Visión por Computador de 2021.




