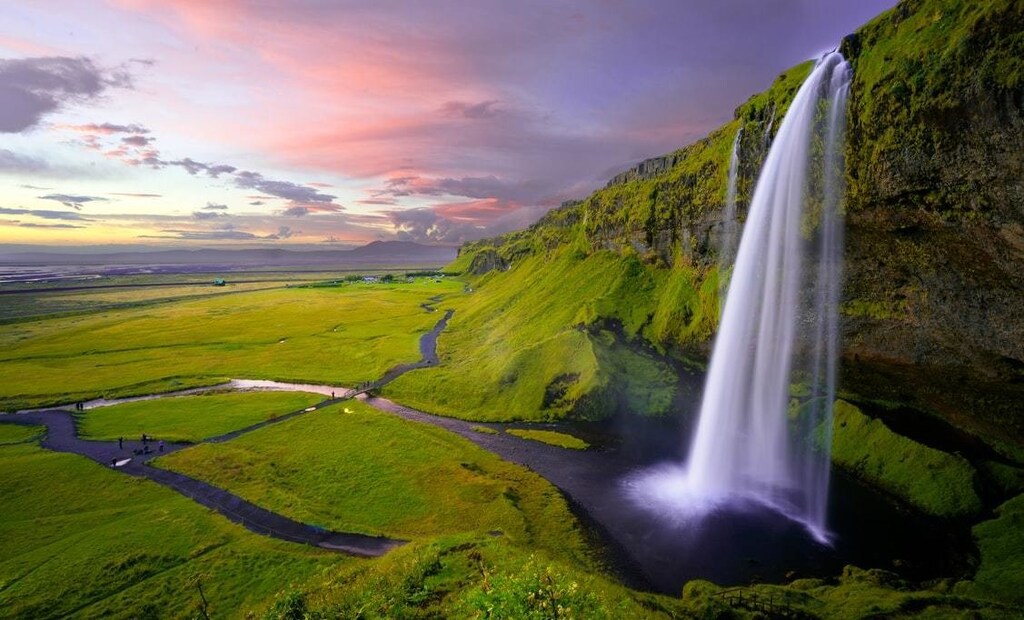
Un nuevo método de aprendizaje profundo puede animar material en movimiento, como cascadas, humo o nubes, a partir de una sola foto.
La técnica predice cómo se movían las cosas cuando se tomó una foto y, a continuación, utiliza esa información para crear la animación.
Además, el método no requiere ninguna aportación del usuario ni información adicional.
En el futuro, podría utilizarse para animar el cabello de las personas al soplar el viento.
A veces, las fotos no pueden capturar realmente una escena. ¡Cuánto más épica sería esa foto de vacaciones de las cataratas del Niágara si el agua se moviera!
Un nuevo método de aprendizaje profundo puede hacer justamente eso: dada una sola foto de una cascada, el sistema crea un video que muestra cómo el agua cae en cascada. Solo falta el estruendo del agua y la sensación de la rociada en el rostro.
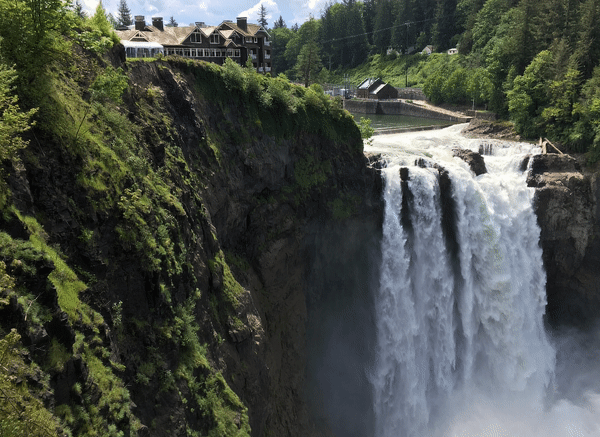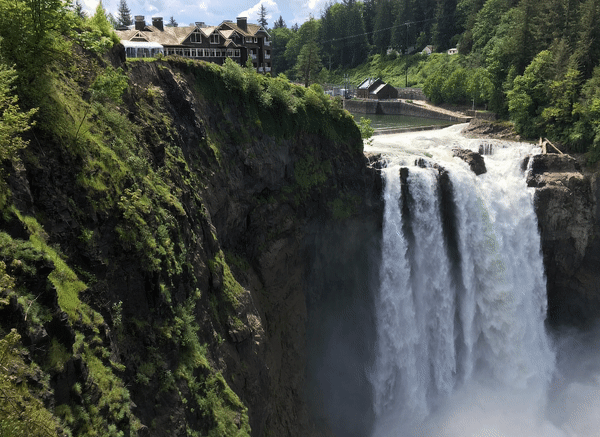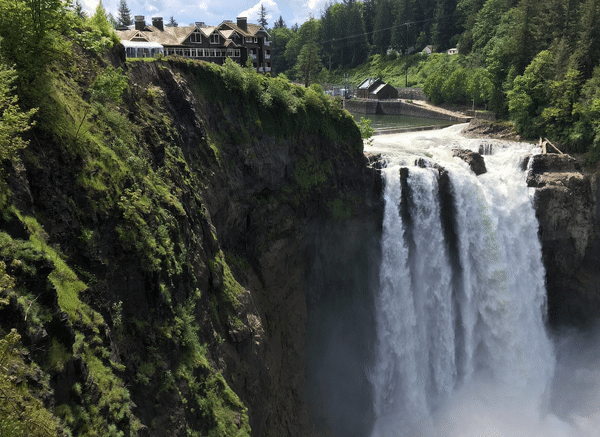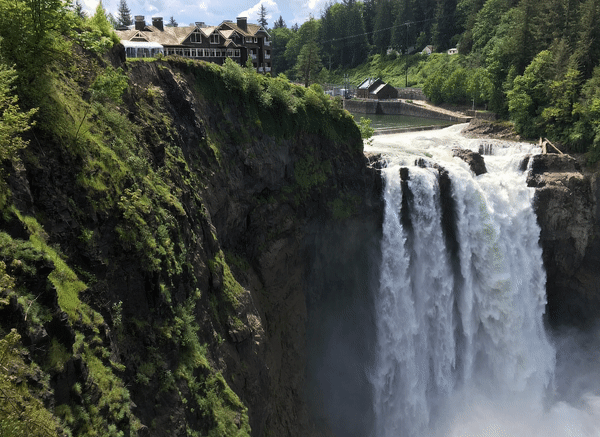
La técnica produce un video corto que se repite sin interrupciones, lo que da la impresión de un movimiento sin fin. Los investigadores presentarán este enfoque en la Conferencia sobre Visión Artificial y Reconocimiento de Patrones.
“Una imagen captura un momento congelado en el tiempo. Pero en una imagen estática se pierde mucha información. ¿Qué llevó a este momento y cómo están cambiando las cosas? Piense en la última vez que se obsesionó con algo realmente interesante; lo más probable es que no fuera totalmente estático”, afirma el autor principal Aleksander Hołyński, estudiante de doctorado en la Escuela Paul G. Allen de Informática e Ingeniería de la Universidad de Washington.
“Lo especial de nuestro método es que no requiere ninguna aportación del usuario ni información adicional”, afirma Hołyński. “Solo se necesita una imagen. Y produce como resultado un video de alta resolución, con un bucle perfecto, que a menudo parece un video real.”
Tome una foto, haga un video
Desarrollar un método que convierta una sola foto en un video creíble video ha sido un reto para el campo. “Requiere, en efecto, predecir el futuro”, afirma Hołyński. “Y en el mundo real hay posibilidades casi infinitas de lo que podría suceder a continuación.”
El sistema del equipo consta de dos partes: primero, predice cómo se movían las cosas cuando se tomó una foto y, después, utiliza esa información para crear la animación.
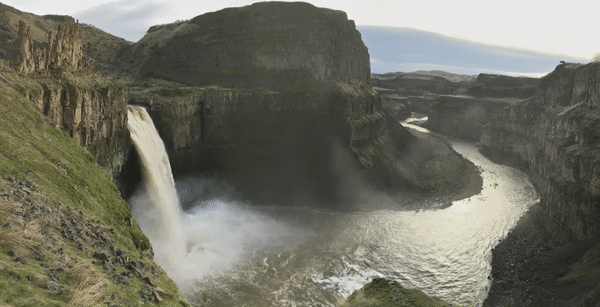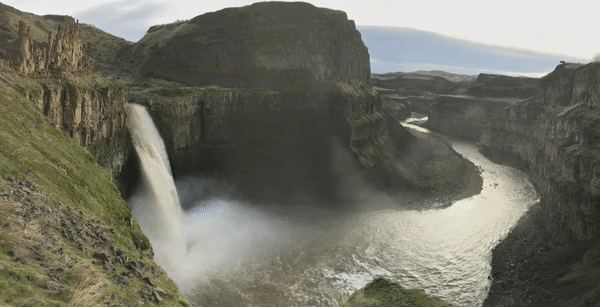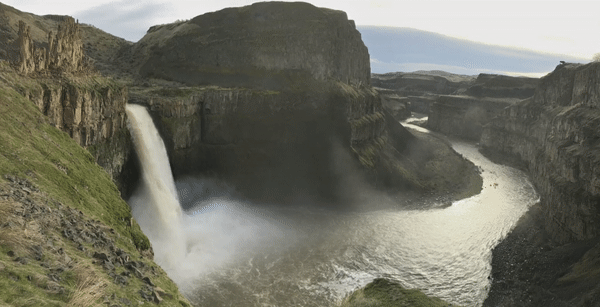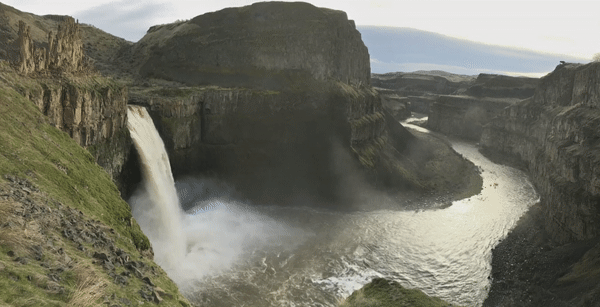
Para estimar el movimiento, el equipo entrenó una red neuronal con miles de videos de cascadas, ríos, océanos y otro material con movimiento fluido. El proceso de entrenamiento consistió en pedir a la red que adivinara el movimiento de un video cuando solo se le proporcionaba el primer fotograma. Tras comparar su predicción con el video real, la red aprendió a identificar pistas (por ejemplo, las ondulaciones de un arroyo) que la ayudan a predecir lo que sucedió después. Luego, el sistema del equipo utiliza esa información para determinar si cada píxel debe moverse y cómo hacerlo.
Los investigadores intentaron usar una técnica llamada “splatting” para animar la foto. Este método mueve cada píxel según su movimiento predicho. Pero esto creó un problema.
“Piensen en una cascada que fluye”, afirma Hołyński. “Si simplemente movemos los píxeles hacia abajo por la cascada, después de unos pocos fotogramas del video, ¡no quedará ningún píxel en la parte superior!”
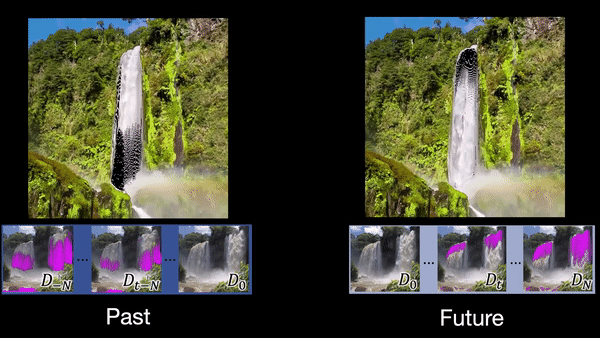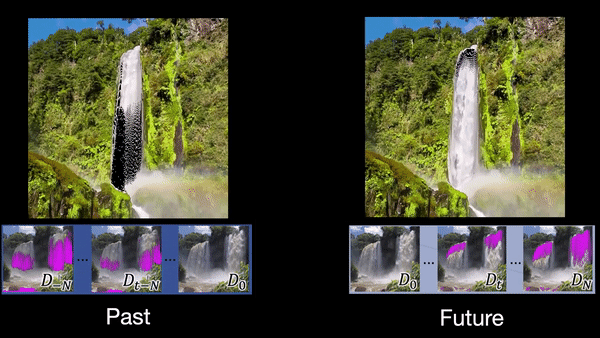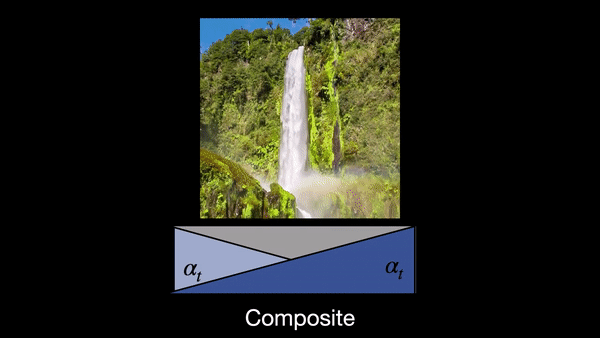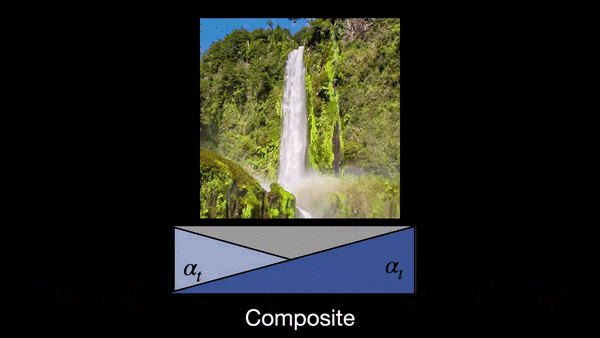
Por eso el equipo creó el “splatting simétrico”. En esencia, el método predice tanto el futuro como el pasado de una imagen y luego los combina en una sola animación.
“Volviendo al ejemplo de la cascada: si vamos al pasado, los píxeles subirán por la cascada. Así que empezaremos a ver un hueco cerca de la base”, afirma Hołyński. “Integramos la información de ambas animaciones para que nunca haya huecos especialmente grandes y llamativos en nuestras imágenes deformadas.”
Por último, los investigadores querían que su animación se repitiera sin interrupciones para crear la sensación de movimiento continuo. La red de animación sigue algunos trucos para mantener la limpieza, como la transición de distintas partes del fotograma en momentos diferentes y decidir con qué rapidez o lentitud mezclar cada píxel según su entorno.
El cabello al soplar el viento
El método del equipo funciona mejor con objetos que tienen un movimiento fluido predecible. Actualmente, la tecnología tiene dificultades para predecir cómo deberían moverse los reflejos o cómo el agua distorsiona la apariencia de los objetos que hay debajo.
“Cuando vemos una cascada, sabemos cómo debe comportarse el agua. Lo mismo ocurre con el fuego o el humo. Estos tipos de movimientos obedecen al mismo conjunto de leyes físicas, y normalmente hay indicios en la imagen que nos indican cómo deberían moverse las cosas”, afirma Hołyński.
“Nos encantaría ampliar nuestro trabajo para operar con una gama más amplia de objetos, como animar el cabello de una persona al soplar el viento. Espero que, con el tiempo, las imágenes que compartimos con nuestros amigos y familiares dejen de ser fotos estáticas. En cambio, todas serán animaciones dinámicas como las que produce nuestro método.”
El Reality Lab de la Universidad de Washington, Facebook, Google, Futurewei y Amazon financiaron el trabajo.




