Este artículo se publica en colaboración con The Conversation.
El último vídeo de un yihadista del Estado Islámico con el rostro cubierto que, al parecer, habla con acento británico llevó a que se lo identificara de forma provisional como Siddhartha Dhar, converso musulmán del este de Londres. Según se informa, expertos en reconocimiento de voz estaban trabajando con los servicios de inteligencia del Reino Unido mediante análisis de voz. Pero ¿cómo funciona esta tecnología y de qué es capaz?
La mayoría de nosotros, al escuchar una voz que conocemos bien, podemos reconocer quién habla tras unas pocas palabras, mientras que las voces menos familiares pueden tardar un poco más. Si el contexto y el contenido de las palabras pronunciadas nos resultan familiares, esto lo facilita aún más. En general, las máquinas se enfrentan a las mismas limitaciones cuando intentan comparar grabaciones y encontrar una coincidencia.
Los sistemas computacionales que pretenden determinar quiénes son las personas a partir de su voz – identificación de hablantes – se diferencian según su objetivo: detectar la presencia de un único hablante conocido; asociar una locución a uno de varios hablantes conocidos; detectar lo que resulta reconocible en una grabación de origen desconocido; o verificar que una grabación de voz procede efectivamente del hablante esperado.
Los sistemas modernos tienden a adoptar un enfoque de macrodatos, en el que los algoritmos de aprendizaje automático se entrenan con grandes conjuntos de grabaciones conocidas para poder reconocer las características vocales de cada hablante. La idea es que los rasgos relevantes que distinguen a unos hablantes de otros se aprenden de forma automática. En cambio, los métodos más antiguos especificaban qué tipo de rasgos lingüísticos y fonéticos del habla se consideraban importantes para compararlos entre hablantes.
Aunque realmente no sabemos qué combinación de características es la más adecuada para el reconocimiento de voz, podemos clasificarlas como acústicas o lingüísticas.
Características acústicas y lingüísticas
Las características acústicas describen la manera en que los seres humanos producen el habla. Al hablar, el aire sale de los pulmones, asciende por la tráquea, atraviesa la laringe y sale por la boca y la nariz. Al pasar, hace vibrar las cuerdas vocales, que, al relajarse o contraerse, modifican la frecuencia de vibración y, con ello, el tono de nuestra voz.
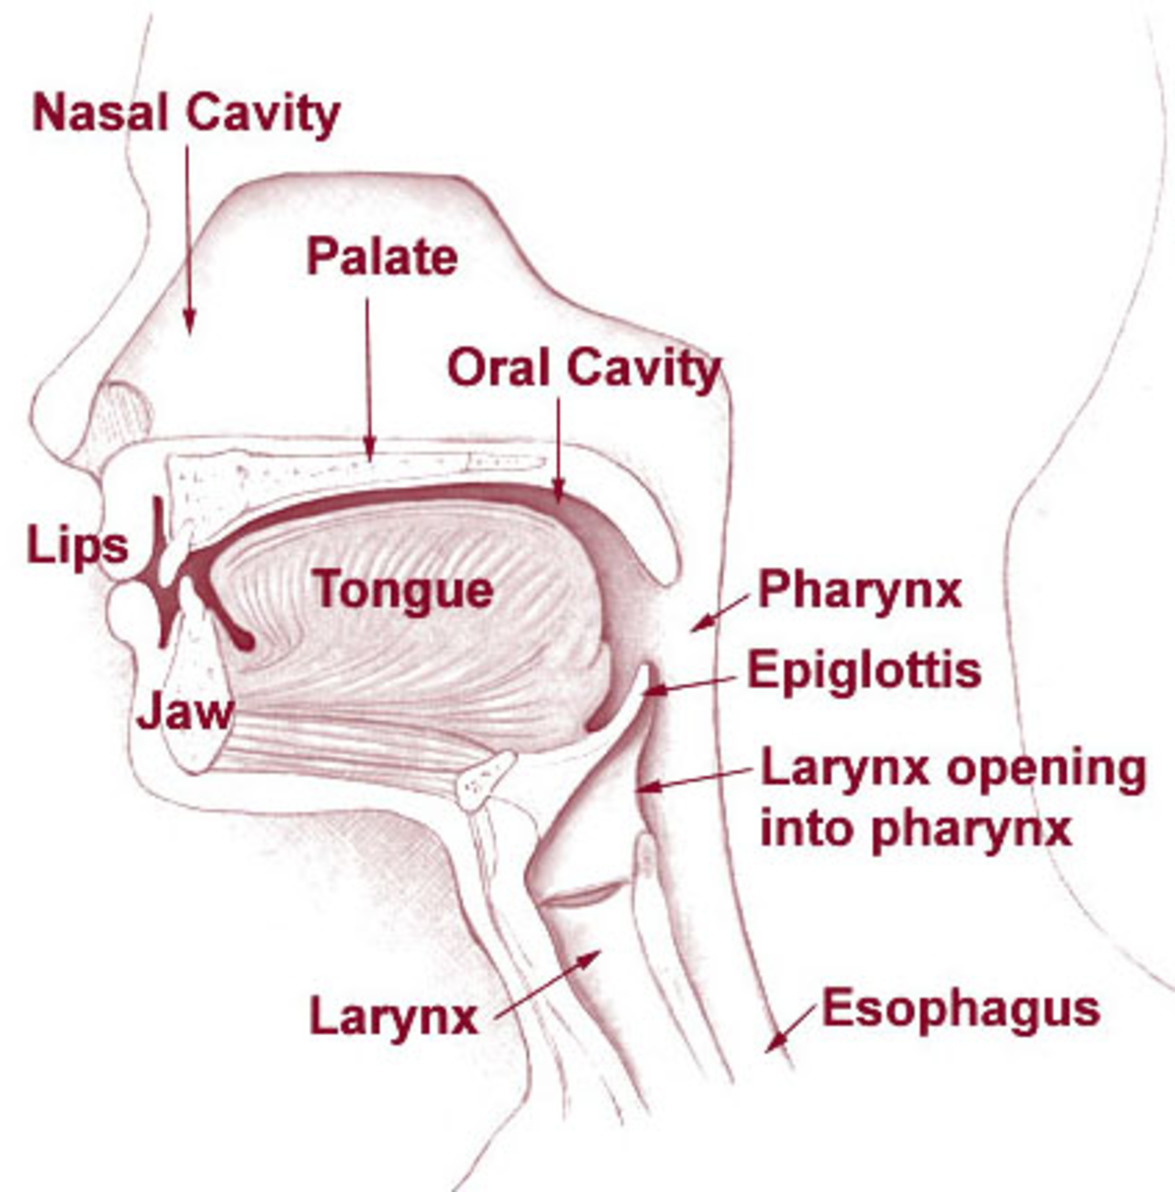
Fuente: National Cancer Institute
Varias partes del interior de las cavidades vocal y nasal, como la lengua, los dientes y los labios – conocidos como articuladores – modifican los sonidos para crear distintas resonancias – llamadas formantes – que dan lugar a otras características variables del habla. Lo que percibimos como habla es la combinación de todas estas interacciones del aire que pasa por estas cavidades y sobre estas partes del cuerpo y entre ellas.
Cada uno de nosotros tiene características propias al hablar: la forma en que los pulmones expulsan el aire, la manera en que resuenan las cuerdas vocales y la acción de los articuladores producen sonidos únicos. La “a” de una persona puede ser muy distinta de la de otra, y eso es solo uno de los 44 fonemas (la unidad sonora más pequeña que forma las palabras) de la lengua inglesa. También es distinta la forma en que nuestro habla une los fonemas y pasa de unos a otros, así como la velocidad a la que ocurre. Piénsese en la diferencia entre el ritmo constante y las vocales redondeadas de un acento rural inglés y el habla más rápida y entrecortada habitual en las grandes ciudades.
Las características lingüísticas se refieren a qué fonemas elegimos utilizar y en qué secuencia, más que a cómo se producen. Si yo digo “tomahto” y tú dices “tomayto”, hemos pronunciado la misma palabra, con una elección distinta de fonemas. Existe un gran número de pronunciaciones alternativas, basadas en la familiaridad y, con frecuencia, en diferencias regionales y generacionales. La elección de palabras, las distintas palabras, los patrones gramaticales, las pausas características, los acentos tónicos, las estructuras oracionales o las frases también permiten identificar a distintos hablantes.
En un nivel aún más alto está el significado de las propias palabras. Tendemos a tomar decisiones distintas sobre lo que decimos y sobre cómo decidimos decirlo: qué tan directo, confrontativo, evasivo o intelectual es nuestro modo de hablar. Si alguna vez has conocido a alguien y has pensado que habla como un abogado, un profesor o un artista, los patrones que reconoces también pueden ser reconocidos por los ordenadores.

Espectrograma de tiempo/frecuencia de la frase ‘I owe you’. Jonas.kluk
Dar sentido a todo ello
En términos computacionales, primero se aíslan las características lingüísticas y acústicas, condensando la gran cantidad de datos en conjuntos manejables de rasgos que capturan de forma sucinta sus matices más importantes. Después se utiliza la comparación de patrones para contrastar estos con los de otra grabación.
Entre las características del habla que pueden extraerse automáticamente se incluyen el tono, la frecuencia de los formantes, la longitud del tracto vocal y la velocidad a la que se pronuncian las sílabas. Algunos métodos modernos funcionan mejor con características de bajo nivel, que requieren menos procesamiento y ofrecen menos significado intrínseco para el oído humano. Suelen ser mapas bidimensionales de tiempo y frecuencia, como los espectrogramas.
Una vez que el habla compleja se ha reducido a un conjunto de características representativas más simplificadas, se aplica un proceso de comparación de patrones generalizado, que determina cuál es la mejor forma de realizar la comparación y en qué grado coinciden los patrones. Si se dispone de suficiente habla de buena calidad para analizar, es posible asociar de forma convincente al hablante con una persona de entre un pequeño grupo de sospechosos. Cuanta más habla tengamos de ambos conjuntos para comparar, mejor será la coincidencia. En este caso, los expertos disponían de varias grabaciones de Dhar concediendo entrevistas cuando aún estaba en el Reino Unido.
Sin sospechosos en los que basarse, la tarea sería casi imposible, como buscar una aguja en un pajar. Pero lo que podemos aprender e inferir sobre un hablante a partir de una grabación puede, por sí mismo, reducir el pajar a un tamaño más manejable. Por ejemplo, los oyentes expertos pueden acotar la región de origen, la edad, el sexo y la emoción, e incluso deducir algo sobre el nivel de formación del hablante. En algunos casos, los expertos en habla pueden determinar dónde nació un hablante, si sus padres hablaban otra lengua y si han vivido en otro lugar más recientemente. Quizá incluso cuándo salieron del Reino Unido.
¿Ciencia ficción o realidad?
Aunque gran parte está envuelta en secreto, se cree que la tecnología de identificación de hablantes es utilizada por agencias de seguridad nacional como GCHQ en el Reino Unido, la NSA en Estados Unidos y Public Security Bureau en China, entre otras. También se cree ampliamente que en algunos países se capturan huellas de voz en los controles de inmigración de los aeropuertos, lo que quizá explique por qué pueden hacerte una pregunta o dos sin sentido durante el trámite; al fin y al cabo, el reconocimiento facial ya está muy extendido en los aeropuertos, ¿por qué no también el de voz?
La tecnología comercial de comparación de voces de empresas como GoVivace, iFlytek, IBM y Nuance probablemente esté al menos una generación por detrás de la que emplean los gobiernos. Hasta qué punto esta tecnología es útil en la actualidad es discutible, pero las entidades financieras la utilizan a diario como medio de validación del hablante – que ofrece una prueba de que son quienes dicen ser.
El análisis de huellas de voz se ha utilizado en casos penales desde la década de 1970, con resultados desiguales, y por lo general para la tarea menos exigente de demostrar que el habla de una grabación determinada pertenece a un hablante concreto. Tratar de identificar a un hablante entre un conjunto enorme de posibilidades, que quizá ni siquiera incluya la coincidencia correcta, es mucho más difícil. Pero no es imposible, y los sistemas están mejorando.
La publicación no implica el respaldo de las opiniones por parte del Foro Económico Mundial.
Para estar al tanto de la Agenda, suscríbete a nuestro boletín semanal.
Autor: Ian McLoughlin es catedrático de Informática y director de la Escuela (Medway) de la Universidad de Kent.
Imagen: Un combatiente del Estado Islámico camina cerca de una bandera negra del Estado Islámico mientras un vehículo del ejército turco se posiciona cerca de la localidad siria de Kobani. REUTERS/Umit Bektas.




