Necesitamos una tecnología centrada en las personas que mejore la productividad y genere un mayor ROI.
Con la tecnología asistida por ML integrada en el proceso de etiquetado de datos, puede reducir el tiempo, el dinero y las personas necesarios.
Existen muchas oportunidades para evitar que los colaboradores se vean sesgados por las predicciones del modelo.
Con los métodos tradicionales de aprendizaje automático (ML), las personas realizan la tarea, a menudo larga y costosa, de anotar cada una de las filas de datos necesarias; los modelos de inteligencia artificial (IA) exitosos requieren miles, si no millones, de unidades de datos de entrenamiento etiquetados con precisión.
A medida que evolucionamos nuestros enfoques de la IA, este nivel de esfuerzo manual resulta cuestionable.
Ahora que disponemos de la base de múltiples modelos de etiquetado previo de última generación, es imperativo que los aprovechemos para mejorar los procesos en todo el ciclo de implementación de la IA, de principio a fin. Estos modelos incluyen el etiquetado previo de píxeles de imagen para vehículos autónomos, el etiquetado previo de transcripción de imágenes y documentos, el etiquetado previo de segmentación de audio y otros modelos de etiquetado previo o clasificación. Al avanzar en nuestras herramientas, necesitamos invertir en un determinado tipo de tecnología centrada en las personas: aquella que mejora la productividad y genera un mayor ROI.
La tecnología centrada en las personas considera que el operador es un activo y no un obstáculo. Reconoce el valor de la habilidad, el conocimiento, la flexibilidad y la creatividad del operador.
Nuestro objetivo al optimizar la tecnología centrada en las personas debe tener dos vertientes: crear flujos de trabajo de IA más rápidos y eficientes sin sacrificar la calidad, y promover el trato justo de los colaboradores reduciendo la carga humana de las tareas de etiquetado, que suelen ser repetitivas y mentalmente agotadoras. La anotación de vídeos a menudo requiere etiquetar por separado los fotogramas de los vídeos, con cambios muy pequeños en las anotaciones. Por ejemplo, un vídeo de coches que circulan por la carretera se divide en varios fotogramas, y cada vehículo debe etiquetarse. Este tipo de anotaciones requeriría muchísimo tiempo si se hicieran a mano, dado el número de fotogramas que componen incluso un vídeo corto. Mediante el aprendizaje automático, podemos automatizar el proceso de anotación, aplicando de inmediato las predicciones de anotación a los fotogramas para que el anotador simplemente pueda ajustarlas según sea necesario, en lugar de tener que crear cada anotación.
Las herramientas asistidas por ML son la base de nuestro empeño por una tecnología centrada en las personas. Con la tecnología asistida por ML integrada en el proceso de etiquetado de datos, puede reducir el tiempo, el dinero y las personas necesarios para este paso crucial en la construcción del modelo.
También ofrece la posibilidad de automatizar y mejorar la calidad y la entrega de la anotación de datos. En este enfoque (en Appen lo llamamos «etiquetado inteligente»), existen puntos de contacto críticos antes, durante y después de la finalización del trabajo.
Punto de contacto uno: antes del trabajo
Antes de ejecutar un trabajo de anotación, puede aprovechar modelos preentrenados o entrenables para proporcionar una hipótesis inicial para sus etiquetas de datos. A diferencia de los procesos de etiquetado manual, sus colaboradores verificarán la exactitud de la hipótesis en lugar de añadir una etiqueta desde cero.
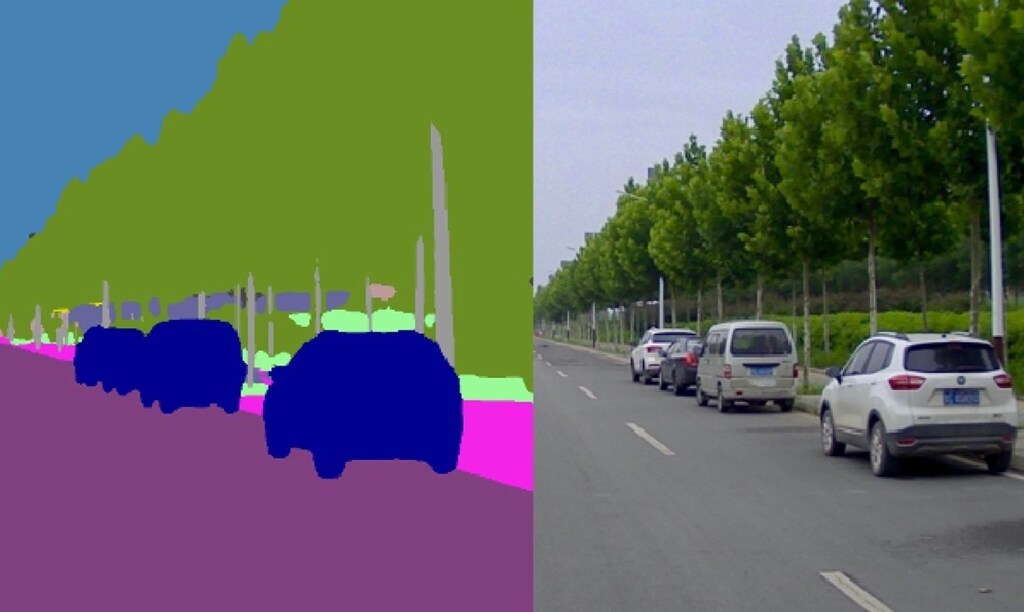
Por ejemplo, si está trabajando en un trabajo de anotación de imágenes para identificar coches en la carretera, puede usar un modelo preentrenado para preclasificar esos objetos o coches objetivo.
Existen varios modelos que pueden llevar a cabo tareas específicas, según su caso de uso. Van desde la censura de contenido explícito hasta el difuminado de datos personales y la adición de cuadros delimitadores alrededor de objetos. Usar modelos existentes para proporcionar etiquetas de datos iniciales ahorra tiempo y dinero al automatizar una parte del proceso de anotación. La precisión dependerá del modelo o de la combinación de modelos que seleccione.
Pero, ¿cómo evitamos que los colaboradores se vean sesgados por las predicciones del modelo? Quizá se lo pregunte.
De hecho, lo comprobamos mediante pruebas A/B a gran escala en varios proyectos de anotación, y descubrimos todo lo contrario: el etiquetado previo de datos mejoró la calidad de las etiquetas. Dicho de otro modo, los datos cuyas etiquetas o anotaciones iniciales completa un modelo de ML antes de entregarse al colaborador para la anotación final generaron etiquetas de mayor calidad que los datos sin etiquetas iniciales.
En un proyecto de etiquetado de píxeles de imagen para vehículos autónomos, el uso de un modelo de ML para el etiquetado inicial mejoró la productividad de los colaboradores un 91,5 % y la calidad de la anotación un 10 % en todas nuestras pruebas.
Si su equipo sigue preocupado por el sesgo, existen más oportunidades de mitigación en las dos fases siguientes del flujo de trabajo.
Punto de contacto dos: durante el trabajo
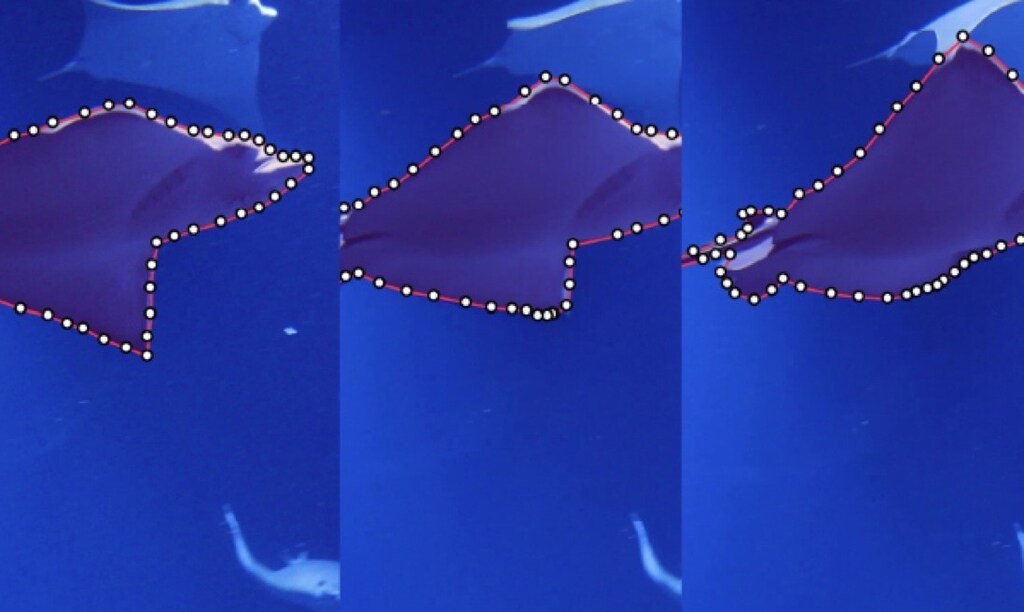
Una vez dentro del trabajo, puede aprovechar los modelos de ML para asistir en los juicios humanos. Por ejemplo, si su trabajo incluye anotación de vídeo, un proceso manual podría ser así: los vídeos se dividen en secuencias fotograma a fotograma y los colaboradores etiquetan cada objeto objetivo en cada fotograma.
Con una frecuencia de fotogramas estándar de 24 fotogramas por segundo, esta tarea de etiquetado se vuelve laboriosa y repetitiva con rapidez. En cambio, con la tecnología asistida por ML, el colaborador puede etiquetar el objeto objetivo una sola vez, y un modelo puede rastrear y predecir su ubicación en los fotogramas siguientes. Siguiendo el mismo ejemplo de los coches en la carretera, el colaborador etiquetaría cada coche en el primer fotograma y el modelo rastrearía su ubicación para anotar los coches en el resto de fotogramas.
A continuación, los colaboradores asumen el papel de revisores de los fotogramas restantes, realizando las correcciones necesarias.
Con la ayuda de la tecnología asistida por ML durante el trabajo, los colaboradores pueden trabajar más rápido y con mayor precisión. Este método puede permitir velocidades de anotación de hasta 100 veces superiores a las de los métodos manuales, sin sacrificar la calidad. Los beneficios también alcanzan a los colaboradores: este método reduce la carga cognitiva y mejora la comodidad durante toda la tarea.
Último punto de contacto: después del trabajo
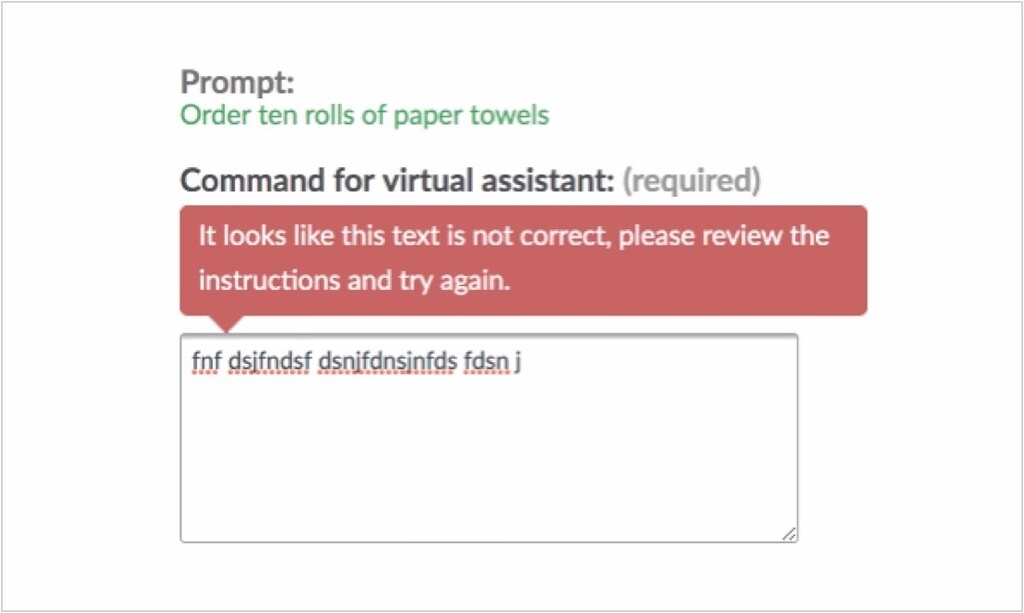
Una vez que el modelo y el colaborador han emitido sus juicios sobre sus datos, puede pasar a la fase de validación. En este paso, puede usar modelos de ML para verificar los juicios emitidos y notificar a los colaboradores si su aportación no se ajusta a los umbrales de calidad esperados.
Este enfoque tiene un par de ventajas destacables. En particular, elimina la necesidad de preguntas de prueba o revisiones entre pares y, además, reduce el riesgo de terminar pagando por juicios que no se ajustan a sus requisitos. Tras la validación del modelo, el colaborador puede enviar el trabajo.
Debemos invertir no solo en soluciones de IA, sino también en la mejora de los procesos que las respaldan.
Wilson Pang
Si tiene un proyecto de enunciados de texto, por ejemplo, puede utilizar herramientas de validación asistidas por ML combinadas con indicadores establecidos, como la coherencia o el idioma. El modelo marcará cualquier etiqueta de datos que no cumpla sus requisitos de precisión para estos indicadores.
A continuación, un anotador humano revisa y corrige las etiquetas. Appen probó herramientas de validación asistidas por ML en un proyecto de enunciados de texto que implicaba el entrenamiento de chatbots. Constatamos una reducción del 35 % en las tasas de error mediante modelos en tiempo real.
«No se trata solo de IA, sino de mejores procesos de IA»
Combinar el aprendizaje automático con el esfuerzo humano, en forma de tecnología centrada en las personas, es el camino a seguir para la innovación en IA.
Las funciones asistidas por ML en los flujos de anotación de datos benefician tanto a las empresas como a los colaboradores: las empresas pueden destinar menos recursos al lanzamiento de soluciones de IA de alta calidad, y hacerlo más rápido, mientras que los colaboradores pueden realizar tareas que implican menos carga mental y repetición. Este último aspecto es especialmente importante para fomentar prácticas de IA justas para todas las personas que trabajan en proyectos de IA.
Debemos invertir no solo en soluciones de IA, sino también en la mejora de los procesos que las respaldan. De este modo, podremos evolucionar nuestro enfoque de la IA ética y acelerar nuestra capacidad para resolver problemas globales con soluciones impulsadas por máquinas.
La IA no está pensada para depender exclusivamente de la máquina o del ser humano; más bien, aprovechar una combinación de ambos puede potenciar las fortalezas de cada uno y favorecer resultados exitosos.




