En los últimos años, la IA ha liderado indiscutiblemente las tendencias tecnológicas y se espera que siga haciéndolo durante las próximas décadas.
Desde los coches autónomos hasta la medicina predictiva y el aprendizaje personalizado, la IA está dando forma cada vez más a aspectos tanto prácticos como íntimos de nuestra vida cotidiana, incluso ayudándonos a encontrar a nuestra media naranja. Cuando hablamos de IA, a menudo nos interesan sus casos de uso: ¿qué permitirá hacer la IA a continuación? En la carrera por crear potentes sistemas y aplicaciones de IA, el público, incluidos los expertos en tecnología, suele pasar por alto la estrecha interconexión entre la IA y la computación. Sin embargo, la revolución de la IA que estamos presenciando no habría sido posible sin la evolución del hardware y del ecosistema de la computación.
La relación entre la IA y la computación
En pocas palabras, la IA busca que los ordenadores imiten la inteligencia humana. Una forma de lograrlo es mediante el aprendizaje automático (ML), que consiste en un conjunto de técnicas estadísticas que permiten a las máquinas aprender de los datos, en lugar de programarlas explícitamente para realizar determinadas tareas. Entre las técnicas de ML más conocidas se encuentran los modelos de regresión, los árboles de decisión y las redes neuronales, que son sistemas adaptativos de nodos interconectados que modelan patrones de relación entre los datos de entrada y de salida. Las redes neuronales multicapa son especialmente útiles para realizar tareas complejas, como el reconocimiento de imágenes y la síntesis de texto. Estas forman un subconjunto del aprendizaje automático denominado aprendizaje profundo (DL), por la profundidad de las redes neuronales subyacentes. Las técnicas de ML en general, y las de DL en particular, requieren grandes cantidades de datos y capacidad de computación. Una red neuronal profunda básica que clasifique imágenes de animales en perros y gatos necesita cientos de miles de imágenes de animales clasificadas como datos de entrenamiento y miles de millones de cálculos iterativos para imitar la capacidad de un niño de cuatro años para distinguir gatos de perros. En este sentido, los datos y la computación son los pilares para crear sistemas de IA de alto rendimiento.
Principales tendencias de computación que están dando forma a la IA
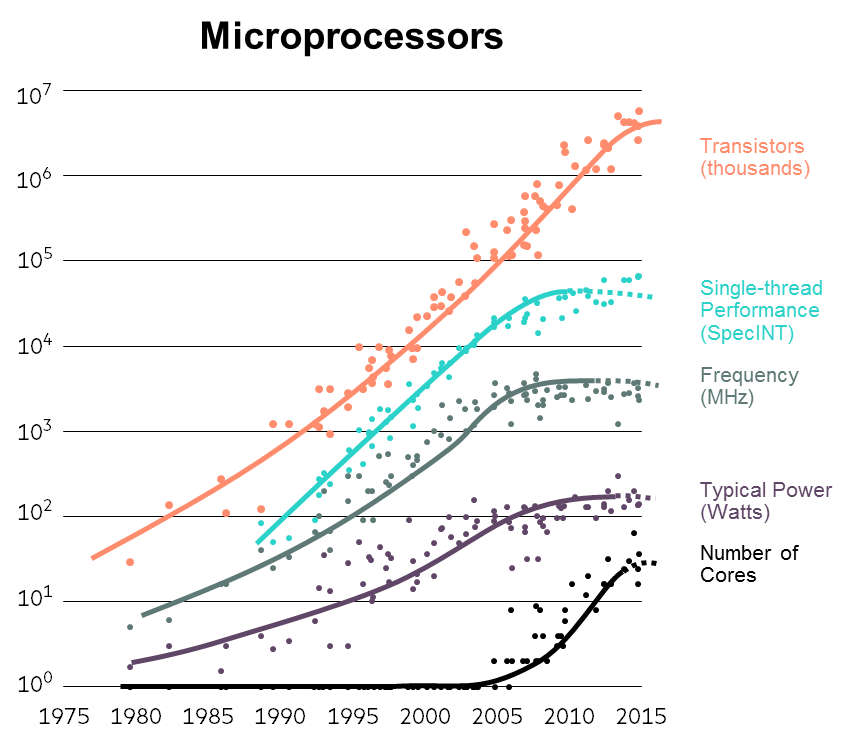
• La ley de Moore: Denominada así por Gordon Moore, cofundador de Intel, la ley de Moore establece que el número de transistores por pulgada cuadrada en un circuito integrado (CI) se ha duplicado cada 18 meses o dos años desde mediados de la década de 1960. Gracias a esta ley, los ordenadores se han vuelto más pequeños y rápidos a un ritmo exponencial, lo que ha reducido los costes de computación alrededor de un 30 % al año, ha permitido ejecutar operaciones matemáticas complejas en pequeños CI y ha allanado el camino hacia la computación integrada y ubicua.
• Internet de las cosas (IoT): Se prevé que para 2020 haya más de 40.000 millones de (mini)ordenadores conectados a internet. El IoT permite recopilar exabytes de datos de entrenamiento en forma de texto, voz, imágenes y otros formatos, que alimentan los modelos de ML y DL y aumentan su exactitud y precisión.
• El auge del hardware de computación específico para aplicaciones (e IA): Un ordenador está compuesto por muchas unidades de procesamiento, cada una de las cuales contiene uno o varios núcleos o CI. Una CPU (unidad central de procesamiento) es el microprocesador más estandarizado y de propósito general, programable y utilizable para casi cualquier fin. En los últimos años han surgido nuevos tipos de unidades de procesamiento, como las GPU (unidades de procesamiento gráfico) y las TPU (unidades de procesamiento tensorial). En condiciones ideales, una GPU o TPU contiene más núcleos que una CPU y también presenta una topología de transistores diferente a nivel de circuito integrado (CI). Gracias a su arquitectura especializada, las GPU y las TPU son especialmente adecuadas para aplicaciones de aprendizaje profundo con un uso intensivo de la computación, como el procesamiento de imágenes y el reconocimiento de voz, así como la minería de texto no estructurado.
• La era de la computación a exaescala: Junto con la explosión de los datos, la evolución del hardware de computación y de las necesidades de computación de aplicaciones como la IA y la cadena de bloques ha llevado a gigantes de la computación como HPE a empezar a construir superordenadores. Ubicados en centros de datos centralizados, estos superordenadores son capaces de realizar al menos un exaFLOPS, es decir, mil billones de billones (un quintillón) de cálculos por segundo. Esta capacidad multiplica por mil la del primer ordenador a escala petaflop, que entró en funcionamiento en 2008. China y la UE también están invirtiendo millones en la carrera por la computación a exaescala.
Retos del statu quo de la computación
Debido a la gran disponibilidad y al descenso de los costes de la computación en la nube, tanto propia como bajo demanda, rara vez se ha considerado la computación un recurso escaso para impulsar la revolución de la IA. Sin embargo, los sistemas informáticos se enfrentan a numerosas limitaciones que pueden ralentizar el desarrollo de las aplicaciones de IA que se basan en ellos. Entre los principales retos figuran:
• El fin de la ley de Moore: Debido a limitaciones físicas, los transistores no pueden reducirse por debajo de cierto tamaño, lo que probablemente hará que la ley de Moore deje de cumplirse antes de lo esperado y limitará la posibilidad de reducir indefinidamente el tamaño de los microprocesadores.
• El aumento de la regulación de los datos: Para procesar datos rápidamente a exaescala en superordenadores centralizados, es necesario almacenarlos cerca de los procesadores. La creciente tendencia mundial a regular los datos, incluida la reciente adopción del RGPD en Europa, probablemente dificultará su almacenamiento centralizado y pondrá en duda la propia razón de construir superordenadores.
• Los costes (y la viabilidad) de la transferencia y el almacenamiento de datos: Retomando el punto anterior, el gran volumen de datos de entrenamiento y los costes de ancho de banda asociados a transferirlos cerca de procesadores centralizados hacen necesario rediseñar la memoria de los ordenadores y las operaciones de E/S (entrada/salida) subyacentes, así como realizar inversiones importantes en la capacidad de la red. El funcionamiento de superordenadores centralizados también conlleva costes operativos (OPEX) y medioambientales, especialmente por el consumo de energía y la generación de emisiones de CO2.
• La falta de un ecosistema que respalde la computación: A medida que más profesionales de TI se incorporan a gigantes tecnológicos o crean empresas emergentes de IA, disminuye el interés por trabajar para fabricantes tradicionales de ordenadores o por fundar empresas centradas en desarrollar nuevo hardware de computación. Aunque la aparición de lenguajes de programación de alto nivel, API y bibliotecas acelera la creación de prototipos de productos de IA, también contribuye a una comprensión menos matizada de las arquitecturas de computación y de las operaciones informáticas básicas, incluso entre los científicos de la computación.
El camino a seguir
Es probable que las restricciones normativas y los costes energéticos y de ancho de banda asociados a la supercomputación centralizada impulsen el almacenamiento de datos y la computación hacia el borde de la red. Intel ya ha desarrollado una memoria USB que permite a los usuarios realizar eficazmente tareas de visión artificial y reconocimiento de imágenes en dispositivos de borde de red, como cámaras inteligentes y hardware de realidad aumentada.
El inminente fin de la ley de Moore probablemente impulsará la aparición de arquitecturas de computación más especializadas, centradas en cambiar la estructura de las unidades de procesamiento y los circuitos individuales para mejorar el rendimiento sin reducir más el tamaño de los transistores o procesadores.
Por otro lado, una nueva forma de computación, la computación cuántica, va ganando terreno progresivamente, aunque su aplicación práctica sigue siendo un reto. Los ordenadores cuánticos replantean la computación al aprovechar las extrañas leyes de la mecánica cuántica. En vez de utilizar transistores diseñados en torno a las unidades binarias de los ordenadores clásicos, los ordenadores cuánticos emplean «bits cuánticos» o «qubits». A diferencia de los bits, que solo pueden ser 1 o 0 en todo momento, los qubits pueden existir en «superposición», lo que les permite simular varios estados al mismo tiempo. Otra propiedad de la materia a nivel cuántico, el «entrelazamiento», permite conectar varios qubits mediante puertas lógicas. Las propiedades de «superposición» y «entrelazamiento» de la computación cuántica hacen posible ejecutar en paralelo muchos flujos de operaciones, tanto con un solo «qbit» como con muchos «qbits». Esto hace que un ordenador cuántico sea más adecuado que uno clásico para abordar problemas computacionales complejos. Dicho esto, construir físicamente un ordenador cuántico «universal» sigue siendo extremadamente difícil desde el punto de vista de la ingeniería. Crear y mantener qubits requiere sistemas estables en condiciones extremas; por ejemplo, mantener la temperatura de los componentes muy cerca del cero absoluto.
Animar a más personas a formarse en ciencia, tecnología, ingeniería y matemáticas (STEM), y retener el talento tecnológico, proporcionará a la industria de fabricación de ordenadores el talento que necesita para reinventarse y responder a las necesidades de la revolución de la IA.
Por último, al crear modelos de ML y escribir algoritmos, los científicos de datos y de la computación, los ingenieros de ML y los profesionales de la IA deberían considerar la forma menos compleja de resolver el problema en cuestión. Elegir una red neuronal compleja cuando una regresión podría haber ofrecido una precisión adecuada, o ejecutar canalizaciones de datos a diario cuando bastaría con actualizarlos semanalmente, son ejemplos concretos de cómo el talento tecnológico desperdicia a diario un recurso escaso como la capacidad de computación. Promover prácticas que favorezcan un uso eficiente de la computación en el ecosistema tecnológico se ha vuelto necesario para que la industria tecnológica mantenga su propio crecimiento, especialmente en el ámbito de la IA.




