El impacto de una política pública depende en parte de su eficacia a la hora de seleccionar a sus destinatarios. El aprendizaje automático puede ayudar aprovechando la creciente disponibilidad de información. Utilizando datos de Italia, esta columna presenta dos ejemplos de cómo emplear el aprendizaje automático para focalizar los grupos que, con verosimilitud, podrían beneficiarse más de la política. Ilustra las ventajas de la focalización mediante aprendizaje automático en comparación con la práctica habitual de aplicar reglas generales de asignación basadas en unas pocas características elegidas de forma arbitraria.
Para orientar la elaboración de políticas necesitamos respuestas tanto a preguntas causales como predictivas. Kleinberg et al. (2015) ofrecen un ejemplo que ayuda a distinguir entre ambas. Un responsable político que actúa frente a una sequía podría necesitar saber si una danza de la lluvia producirá los efectos previstos. Se trata de una pregunta puramente causal. Pero otras decisiones relacionadas con la lluvia, como si repartir paraguas, solo requieren una buena predicción de la probabilidad de mal tiempo, porque el beneficio de llevar un paraguas se conoce, al menos con cierto grado de aproximación. Esto es lo que Kleinberg et al. (2015) denominan un ‘problema de política predictiva’.
La mayor parte de la literatura sobre evaluación de políticas se ha centrado en preguntas causales. La ‘revolución de la credibilidad’ en econometría (Angrist y Pischke 2010) nos ha proporcionado herramientas para la estimación ex post de los efectos causales de los programas públicos. No obstante, el impacto de una política también depende de su eficacia a la hora de seleccionar a sus destinatarios. Predecir qué destinatario puede generar un mayor rendimiento puede ser crucial cuando los recursos son escasos. Aquí es donde resulta útil el aprendizaje automático. Los algoritmos de aprendizaje automático desarrollados en estadística e informática (Hastie et al. 2009) han demostrado ser especialmente potentes para tareas predictivas (Mullainathan y Spiess 2017).1
Presentamos dos ejemplos de cómo emplear el aprendizaje automático para focalizar los grupos que, con verosimilitud, podrían beneficiarse más de la política.2 Los ejemplos ilustran las ventajas de la focalización mediante aprendizaje automático en comparación con la práctica habitual de aplicar reglas de asignación generales basadas en características observables elegidas de forma arbitraria. Sin embargo, solo los métodos de evaluación ex post nos dirán, en última instancia, si la focalización basada en predicciones proporciona las ganancias previstas. La columna también aborda algunas de las cuestiones —transparencia, manipulación, etc.— que surgen cuando se utilizan algoritmos de aprendizaje automático en las políticas públicas.
Ejemplos de focalización mediante aprendizaje automático
En Andini et al. (2018a) analizamos un régimen de devolución fiscal introducido en Italia en 2014 con el objetivo de impulsar el consumo de los hogares. El Gobierno italiano optó por una regla de focalización general y concedió la devolución únicamente a los empleados con ingresos anuales entre 8.145 y 26.000 euros. Dado el objetivo de la política, una alternativa habría sido focalizarse en los hogares con restricciones de consumo, que, según se supone, consumirían más con cargo a la bonificación.
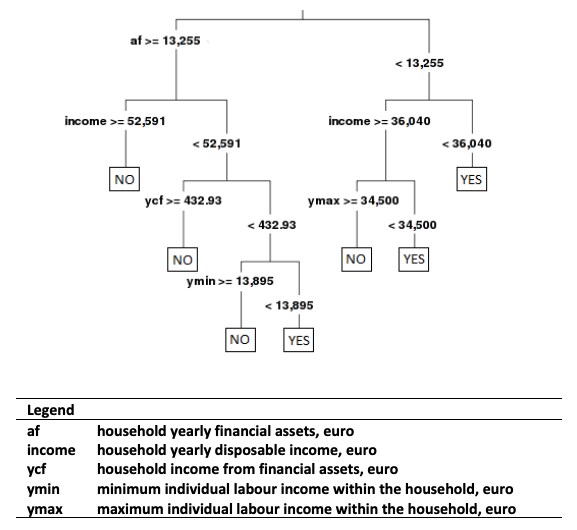
Las encuestas suelen contener medidas autodeclaradas que pueden utilizarse como indicadores indirectos de las restricciones de consumo. Utilizamos las oleadas de 2010 y 2012 de la Encuesta sobre la Renta y la Riqueza de los Hogares (SHIW) del Banco de Italia, que preguntaba a los hogares por su capacidad para llegar a fin de mes. Empleamos métodos de aprendizaje automático listos para usar con el fin de predecir esta condición a partir de un amplio conjunto de variables que podrían utilizarse para la focalización. Nuestro algoritmo preferido es el árbol de decisión, que lleva al mecanismo de asignación mostrado en la Figura 1. Selecciona solo unas pocas variables, básicamente relacionadas con la renta y la riqueza de los hogares. Por ejemplo, se predice que los hogares con activos financieros inferiores a 13.255 € y renta disponible inferior a 36.040 € tienen restricciones de consumo. Los demás grupos previstos con esta condición pueden identificarse fácilmente observando la figura.
Figura 1. Modelo de predicción mediante árbol de decisión para la condición de restricción de consumo
Aunque tengamos razones para creer que los hogares previstos como restringidos en su consumo son más propensos a gastar la devolución, nada garantiza que así sea (Athey 2017). Para atenuar estas preocupaciones, estimamos por separado, con los datos de la SHIW de 2014, el efecto de la bonificación para los hogares previstos como restringidos en su consumo y para los que no lo están. Para ello recurrimos a la econometría estándar, asumiendo una selección basada en variables observables y ejecutando regresiones.
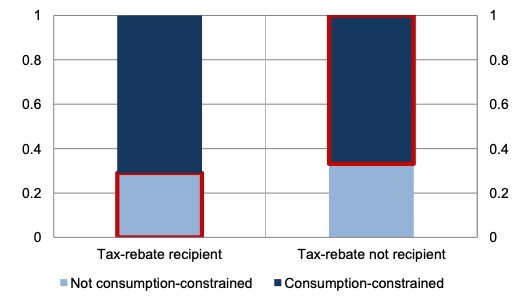
El efecto estimado es positivo y significativo solo para los hogares previstos como restringidos en su consumo. La distribución de los beneficiarios de la devolución fiscal sugiere que podrían lograrse grandes ganancias utilizando el aprendizaje automático para la focalización (Figura 2, delimitada en rojo): alrededor de un tercio de los beneficiarios reales se prevé que no tengan restricciones de consumo, mientras que cerca de dos tercios de los no beneficiarios se prevé que sí las tengan.
Figura 2. Proporción de hogares previstos con restricciones de consumo según su condición de beneficiarios de la devolución fiscal
En la segunda aplicación (Andini et al. 2018b) nos centramos en el ‘problema de política predictiva’ consistente en asignar garantías de crédito públicas a empresas. Estos programas pretenden apoyar el acceso de las empresas al crédito bancario mediante la provisión de colateral financiado con fondos públicos. En principio, los programas de garantías deberían dirigirse a empresas que sean a la vez solventes —para garantizar la sostenibilidad financiera del programa— y racionadas —porque es probable que otras empresas obtengan crédito de todos modos (Banco Mundial 2015). En la práctica, los programas de garantías existentes suelen basarse en reglas simplistas que excluyen a los prestatarios con baja solvencia. Proponemos un mecanismo de asignación alternativo basado en predicciones de aprendizaje automático, en el que se abordan de forma explícita tanto la solvencia como el racionamiento del crédito.
La investigación se refiere a Italia, donde un Fondo de Garantía público opera desde 2000. Utilizando datos a nivel micro del registro de crédito, que incluye medidas tanto del racionamiento del crédito3 como de la aparición de préstamos morosos, identificamos las empresas objetivo hipotéticas y estimamos un modelo de aprendizaje automático para predecir esta situación. En este caso, nuestro algoritmo de aprendizaje automático preferido es el bosque aleatorio, que es, en esencia, el promedio de muchos árboles de decisión.
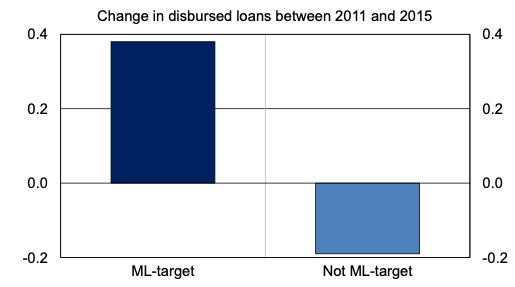
Para evaluar si la focalización en estas empresas mejorará el impacto del programa en la disponibilidad de crédito, consideramos primero el conjunto de empresas que recibieron la garantía y las dividimos en dos grupos, según el aprendizaje automático las prediga como objetivo o no. Una comparación simple de la tasa de crecimiento de los préstamos bancarios desembolsados en los años posteriores a la concesión de la garantía muestra que el grupo focalizado mediante aprendizaje automático obtuvo mejores resultados (Figura 3). El resultado se confirma aplicando un diseño de discontinuidad de regresión más riguroso (como en de Blasio et al. 2018), que muestra un mayor impacto de la garantía en la disponibilidad de crédito para el grupo objetivo del aprendizaje automático.
Figura 3. Resultados de las empresas beneficiarias del Fondo de Garantía según su condición de objetivo del aprendizaje automático
Cuestiones relacionadas con la focalización mediante aprendizaje automático
Aplicar métodos de aprendizaje automático a la focalización de políticas exige abordar algunas cuestiones controvertidas. Una preocupación surge con la interpretabilidad de la regla de decisión, que puede producirse a costa de la precisión. En algunas aplicaciones, los algoritmos simples son suficientemente precisos, como ocurre con el árbol de decisión del ejemplo de la devolución fiscal. En otros casos, la regla de focalización preferible basada en aprendizaje automático funciona como una caja negra, como el bosque aleatorio mencionado anteriormente para el programa de garantías públicas. La falta de interpretabilidad de las reglas de caja negra puede considerarse una amenaza para la transparencia, porque los agentes excluidos pueden no entender fácilmente por qué no han sido seleccionados (Athey 2017). La relación entre precisión y transparencia depende de la aplicación concreta.
No obstante, existe una dimensión de la transparencia, que podría denominarse transparencia sustantiva, relativa a la rendición de cuentas del responsable político para cumplir su misión, es decir, utilizar el dinero público de forma eficaz. En este sentido, la focalización mediante aprendizaje automático supera claramente a las reglas generales de asignación.
Otra preocupación es que las reglas de focalización basadas en aprendizaje automático se construyen atendiendo a un beneficio específico (por ejemplo, mejorar el acceso de las empresas al crédito). Para alcanzar este objetivo, la regla de focalización selecciona determinados grupos (los objetivos) y no otros. Esta selección puede perjudicar otros objetivos de política (‘beneficios omitidos’; véase Kleinberg et al. 2018). Por ejemplo, al profundizar en el caso del Fondo de Garantía, la garantía pública también fue defendida con firmeza como contramedida frente a la recesión. Cabe preguntarse si nuestra regla de focalización basada en aprendizaje automático acaba excluyendo a las empresas situadas en las regiones del sur, que se vieron más golpeadas por la crisis. Este no es el caso: la regla basada en aprendizaje automático prioriza el sur, mientras que la regla real del Fondo de Garantía favorece al norte.
La última preocupación es que, una vez conocida una regla de focalización, los agentes pueden manipular sus características observables para beneficiarse de la política. Sin embargo, esto ocurre con cualquier tipo de focalización. Si comparamos, por ejemplo, el árbol de decisión con la regla real de la devolución fiscal, se observa que, para obtener la bonificación, el posible beneficiario tendría que manipular varias variables (por ejemplo, tanto los activos financieros como la renta en el caso más sencillo), mientras que la medida real se basa solo en la renta.




