Según una nueva investigación, nuestro cerebro tiene una función de «autocorrección» que utilizamos al reinterpretar sonidos ambiguos.
«Lo que una persona cree oír no siempre coincide con las señales reales que llegan al oído…»
El estudio arroja luz sobre cómo el cerebro utiliza la información recopilada después de detectar un sonido inicial para facilitar la comprensión del habla. Los hallazgos, publicados en Journal of Neuroscience, apuntan a nuevas formas en que utilizamos la información y el contexto para facilitar la comprensión del habla.
«Lo que una persona cree oír no siempre coincide con las señales reales que llegan al oído», explica la autora principal, Laura Gwilliams, doctoranda del Departamento de Psicología de la Universidad de Nueva York e investigadora del Laboratorio de Neurociencia del Lenguaje de NYU Abu Dhabi.
«Esto se debe a que, según sugieren nuestros resultados, el cerebro vuelve a evaluar la interpretación de un sonido del habla cada vez que oye el siguiente, para actualizarla cuando sea necesario», afirma Gwilliams.
«Sorprendentemente, nuestra audición puede verse afectada por un contexto que aparece hasta un segundo después, sin que el oyente llegue a ser consciente de esta percepción alterada».
«Por ejemplo, un sonido inicial ambiguo, como “b” o “p”, se oye de una forma u otra según aparezca en la palabra “parakeet” o “barricade”», añade el investigador principal, Alec Marantz, profesor de los departamentos de Lingüística y Psicología y codirector del Laboratorio de Neurociencia del Lenguaje, donde los investigadores llevaron a cabo su trabajo.
«Esto ocurre sin que seamos conscientes de la ambigüedad, aunque la información que permite resolverla no llega hasta la mitad de la tercera sílaba».
Los investigadores han creado ejemplos de estos estímulos, que puedes escuchar aquí.
El contexto es clave
Es bien sabido que la percepción de un sonido del habla está determinada por el contexto que lo rodea —palabras, frases y otros sonidos del habla—. En muchos casos, esta información contextual se oye después de la señal sensorial inicial.
«Lo interesante es que este contexto puede aparecer después de los sonidos que se están interpretando y aun así utilizarse para modificar cómo se percibe el sonido…»
Esto ocurre en la vida cotidiana: cuando hablamos, el habla que producimos suele ser ambigua. Por ejemplo, si una amiga dice que tiene una «abolladura» en el coche, quizá oigas «tienda». Aunque este tipo de ambigüedad se da con frecuencia, como oyentes apenas somos conscientes de ella.
«Esto se debe a que el cerebro resuelve automáticamente la ambigüedad por nosotros: elige una interpretación y eso es lo que percibimos que oímos», explica Gwilliams. «El cerebro lo hace utilizando el contexto circundante para reducir las posibilidades de lo que puede querer decir quien habla».
En el estudio, los investigadores intentaron comprender cómo utiliza el cerebro esta información posterior para modificar nuestra percepción de lo que oímos inicialmente.
Ahora escucha esto
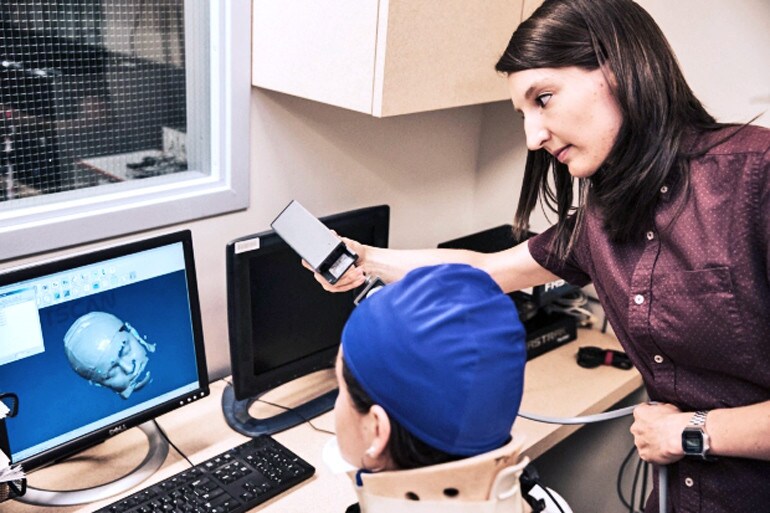
Para ello, realizaron una serie de experimentos en los que los sujetos escucharon sílabas aisladas y palabras de sonido similar (por ejemplo, barricade y parakeet). Para medir la actividad cerebral de los sujetos, los científicos emplearon la magnetoencefalografía (MEG), una técnica que registra los campos magnéticos generados por las corrientes eléctricas producidas por el cerebro y permite cartografiar la actividad neuronal.
Se colocan electroimanes en la cabeza del participante para determinar dónde se encuentra dentro de la máquina. (Crédito: Kate Lord/NYU)
Los resultados arrojaron tres hallazgos principales:
La corteza auditiva primaria del cerebro es sensible al grado de ambigüedad de un sonido del habla apenas 50 milisegundos después de que comienza el sonido. El cerebro «reproduce» sonidos del habla anteriores mientras interpreta los siguientes, lo que sugiere que vuelve a evaluarlos a medida que se desarrolla el resto de la palabra. Al cabo de aproximadamente medio segundo, el cerebro se compromete con su «mejor hipótesis» sobre cómo interpretar la señal.
«Lo interesante es que este contexto puede aparecer después de los sonidos que se están interpretando y aun así utilizarse para modificar cómo se percibe el sonido», añade Gwilliams.
Por ejemplo, el mismo sonido se percibirá como «k» al comienzo de «kiss» y como «g» al comienzo de «gift», aunque la diferencia entre las palabras («ss» frente a «ft») aparezca después del sonido ambiguo.
«En concreto, descubrimos que el sistema auditivo mantiene activamente la señal acústica en la corteza auditiva mientras, al mismo tiempo, formula hipótesis sobre la identidad de las palabras que se están diciendo», afirma Gwilliams. «Esta estrategia de procesamiento permite acceder rápidamente al contenido del mensaje y, a la vez, volver a analizar la señal acústica para reducir los errores auditivos».
El estudio fue financiado por el Instituto de Investigación de NYU Abu Dhabi, el Consejo Europeo de Investigación, la Agencia Nacional de Investigación de Francia y los Institutos Nacionales de Salud.
Otros investigadores de NYU y de la Universidad Johns Hopkins contribuyeron al trabajo.



