El aprendizaje automático analizó 3,5 millones de libros y descubrió que los adjetivos atribuidos a las mujeres tienden a describir el aspecto físico, mientras que las palabras que se refieren al comportamiento se asocian con los hombres.
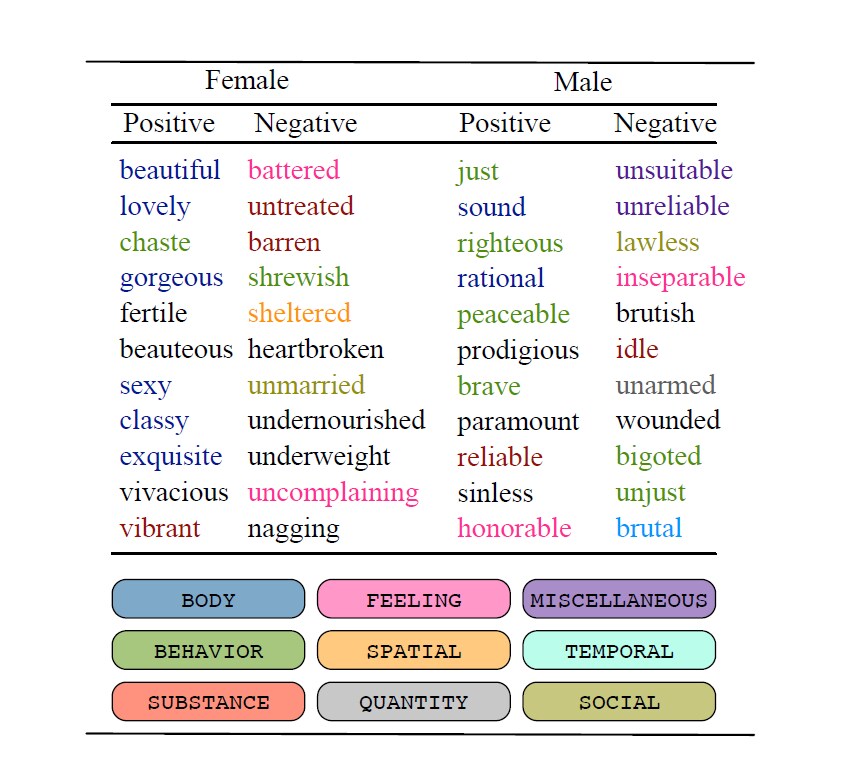
«Hermosa» y «sexy» son dos de los adjetivos que más se utilizan para describir a las mujeres. Entre los calificativos habituales para los hombres figuran «justo», «racional» y «valiente».
Los investigadores examinaron una enorme cantidad de libros con el fin de determinar si existe una diferencia entre los tipos de palabras que describen a hombres y mujeres en la literatura. Mediante un nuevo modelo informático, analizaron un conjunto de datos de 3,5 millones de libros, todos ellos publicados en inglés entre 1900 y 2008. Los libros incluyen una mezcla de literatura de ficción y de no ficción.
«Está claro que podemos ver que las palabras utilizadas para las mujeres se refieren mucho más a su apariencia que las palabras utilizadas para describir a los hombres. Así, hemos podido confirmar una percepción generalizada, aunque ahora a nivel estadístico», afirma la científica informática e profesora adjunta Isabelle Augenstein, del departamento de informática de la Universidad de Copenhague.
Los investigadores extrajeron adjetivos y verbos asociados a sustantivos específicos de género (por ejemplo, «hija» y «azafata»). Por ejemplo, en combinaciones como «azafata sexy» o «chicas chismorreando». A continuación, analizaron si las palabras tenían un sentimiento positivo, negativo o neutro, y después clasificaron las palabras en categorías semánticas como «comportamiento», «cuerpo», «sentimiento» y «mente».
El conjunto de datos se basa en el Corpus Google Ngram.
11 000 millones de palabras
Su análisis demuestra que los verbos negativos asociados al cuerpo y a la apariencia aparecen cinco veces más a menudo en las figuras femeninas que en las masculinas. El análisis también demuestra que los adjetivos positivos y neutros relacionados con el cuerpo y la apariencia aparecen aproximadamente el doble de veces en las descripciones de figuras femeninas, mientras que las masculinas se describen con mayor frecuencia mediante adjetivos que se refieren a su comportamiento y cualidades personales.
En el pasado, los lingüistas solían examinar la prevalencia del lenguaje con connotaciones de género y del sesgo, pero utilizando conjuntos de datos más pequeños. Hoy en día, los científicos informáticos pueden desplegar algoritmos de aprendizaje automático para analizar enormes volúmenes de datos; en este caso, 11 000 millones de palabras.
Aunque muchos de los libros se publicaron hace varias décadas, siguen desempeñando un papel activo, señala Augenstein. Los algoritmos utilizados para crear máquinas y aplicaciones capaces de comprender el lenguaje humano se alimentan de datos en forma de material textual disponible en línea. Es la tecnología que permite a los teléfonos inteligentes reconocer nuestra voz y que Google ofrezca sugerencias de palabras clave.
¿Por qué son tan importantes los adjetivos?
«Los algoritmos trabajan para identificar patrones y, siempre que se observa uno, se percibe que algo es “verdadero”. Si alguno de estos patrones se refiere a un lenguaje sesgado, el resultado también estará sesgado. Los sistemas adoptan, por así decirlo, el lenguaje que usamos las personas y, por tanto, nuestros estereotipos y prejuicios de género», afirma Augenstein. Pone un ejemplo de dónde puede ser importante: «Si el lenguaje que utilizamos para describir a hombres y mujeres difiere en las recomendaciones de empleados, por ejemplo, influirá en quién recibe una oferta de trabajo cuando las empresas utilizan sistemas informáticos para clasificar las solicitudes de empleo».
A medida que la inteligencia artificial y la tecnología del lenguaje cobran mayor protagonismo en la sociedad, es importante ser conscientes del lenguaje con connotaciones de género.
Augenstein añade: «Podemos intentar tenerlo en cuenta al desarrollar modelos de aprendizaje automático, ya sea utilizando textos menos sesgados o obligando a los modelos a ignorar o contrarrestar el sesgo. Las tres cosas son posibles».
Los investigadores señalan que el análisis tiene sus limitaciones, ya que no tiene en cuenta quién escribió cada pasaje ni las diferencias en el grado de sesgo según si los libros se publicaron en un periodo anterior o posterior dentro de la línea temporal del conjunto de datos. Además, no distingue entre géneros, por ejemplo, entre novelas románticas y no ficción. Los investigadores están dando seguimiento actualmente a varios de estos aspectos.
Otros coautores del estudio pertenecen a la Universidad de Maryland, Google Research, la Universidad Johns Hopkins, la Universidad de Massachusetts Amherst y Microsoft Research.
Presentaron un artículo sobre el tema en la Reunión Anual de 2019 de la Asociación de Lingüística Computacional.




