No hace tanto tiempo que vivíamos en un mundo totalmente analógico. Desde los teléfonos hasta los televisores, y desde los libros hasta los archivadores, la tecnología digital estaba en gran medida relegada al laboratorio.
Pero en la década de 1960, la informática había empezado a abrirse paso en las trastiendas administrativas de las grandes organizaciones, realizando funciones como contabilidad, nóminas y gestión de existencias. Sin embargo, la gran mayoría de los sistemas de aquella época (como el sistema sanitario, las redes eléctricas o las redes de transporte), así como la tecnología con la que interactuábamos, seguían siendo analógicos.
Avancemos una generación, y hoy nuestro mundo es altamente digital. Los unos y los ceros impregnan nuestra vida. La informática ha invadido casi todos los aspectos de la actividad humana, desde la atención sanitaria y la industria manufacturera hasta las telecomunicaciones, el deporte, el entretenimiento y los medios de comunicación.
Tomemos como ejemplo los teléfonos inteligentes, que existen desde hace menos de una década, y consideremos cuántos objetos analógicos distintos han reemplazado: un callejero, un reproductor de casetes, un cuaderno, una libreta de direcciones, un periódico, una cámara de fotos, una videocámara, postales, una brújula, un diario personal, un dictáfono, un buscapersonas, un teléfono e incluso ¡un nivel de burbuja!
Todo ello, por supuesto, se ha sustentado en la explosión de internet. Además del uso de internet por parte de las personas, asistimos a un uso aún más generalizado para conectar entre sí todo tipo de dispositivos, máquinas y sistemas: el llamado Internet de las cosas (o “Internet industrial” o “Internet-of-Everything”).
Sistemas complejos
Vivimos hoy en una era en la que la mayoría de los sistemas han sido instrumentados y producen volúmenes muy grandes de datos digitales. El análisis de estos datos puede aportar información sobre estos sistemas de formas que nunca fueron posibles en un mundo analógico.
La ciencia de datos reúne disciplinas como la estadística, el aprendizaje automático, la analítica y la visualización para ofrecer una base rigurosa a este campo. Y lo hace del mismo modo en que la informática surgió en la década de 1950 para sustentar la computación.
En el pasado, hemos desarrollado con éxito modelos matemáticos complejos para explicar y predecir fenómenos físicos. Por ejemplo, podemos predecir con precisión la resistencia de un puente o la interacción de las moléculas químicas.
Luego está el tiempo atmosférico, cuya predicción es notoriamente difícil. Sin embargo, basándonos en modelos numéricos de predicción meteorológica, en grandes volúmenes de datos observacionales y en potentes ordenadores, hemos mejorado la precisión de los pronósticos hasta el punto de que una previsión a cinco días de hoy es tan fiable como lo era una previsión a dos días hace 20 años.
Pero hay muchos problemas en los que los modelos subyacentes no son fáciles de definir. No existe un conjunto de ecuaciones matemáticas que caractericen el sistema sanitario ni los patrones de la ciberdelincuencia.
Lo que sí tenemos, sin embargo, es un volumen creciente de datos recopilados de innumerables fuentes. El reto es que estos datos suelen presentarse en muchas formas, proceden de múltiples fuentes, están en distintas escalas y contienen errores e incertidumbre.
Así, en lugar de intentar desarrollar modelos deterministas, como hicimos con los puentes o las interacciones químicas, podemos desarrollar modelos basados en datos. Estos modelos integran datos de todas las fuentes diversas y pueden tener en cuenta los errores y la incertidumbre de los datos. Podemos contrastar estos modelos con hipótesis concretas y refinarlos.
También es fundamental que examinemos estos modelos y los datos en los que se sustentan.
Datos de 360 grados
En mi universidad hemos construido un Data Arena para permitir la exploración y la visualización de datos. La instalación aprovecha software de código abierto, computación de alto rendimiento y técnicas de los efectos visuales del cine para convertir flujos de datos en un sistema de vídeo estéreo 3D totalmente inmersivo que proyecta 24 millones de píxeles sobre una pantalla cilíndrica de cuatro metros de altura y diez metros de diámetro.
Estar en el centro de esta instalación e interactuar con los datos en tiempo real es una experiencia impactante. Ya hemos construido flujos de procesamiento para ingerir datos de microscopios ópticos de alta resolución, lo que ha ayudado a nuestros investigadores a comprender cómo se desplazan las bacterias por las superficies.
Leímos 22 millones de puntos de datos recogidos por un CSIRO Zebedee que había escaneado las Wombeyan Caves y, diez minutos después, sobrevolábamos la cueva en 3D y explorábamos el subsuelo.
Independientemente del tipo de datos que hayamos explorado, inevitablemente hemos descubierto algo interesante.
En un par de casos, ha resultado inmediatamente evidente que había errores en los datos. En un conjunto de datos astronómicos, descubrimos una cantidad enorme de puntos de datos duplicados. En otras situaciones, hemos observado patrones que no habían resultado evidentes para los expertos en la materia que analizaban los datos.
Este fenómeno es el clásico «unknown unknown» (popularizado en 2002 por el secretario de Defensa de Estados Unidos, Donald Rumsfeld) y pone de manifiesto la capacidad del sistema visual humano para detectar patrones o anomalías.
El mundo de hoy está inundado de datos. Estos abren nuevas posibilidades y nuevas vías de investigación y comprensión. Pero necesitamos herramientas capaces de gestionar volúmenes de datos tan abrumadores si queremos aprovecharlos al máximo. Nuestros ojos son una de esas herramientas, pero incluso ellos necesitan la ayuda de espacios como el que proporciona el Data Arena.
Este artículo se publica en colaboración con The Conversation. La publicación no implica que el Foro Económico Mundial respalde las opiniones expresadas.
Para mantenerse al día con la Agenda suscríbase a nuestro boletín semanal.
Autor: Glenn Wightwick es vicerrector adjunto de Investigación de la University of Technology, Sydney.
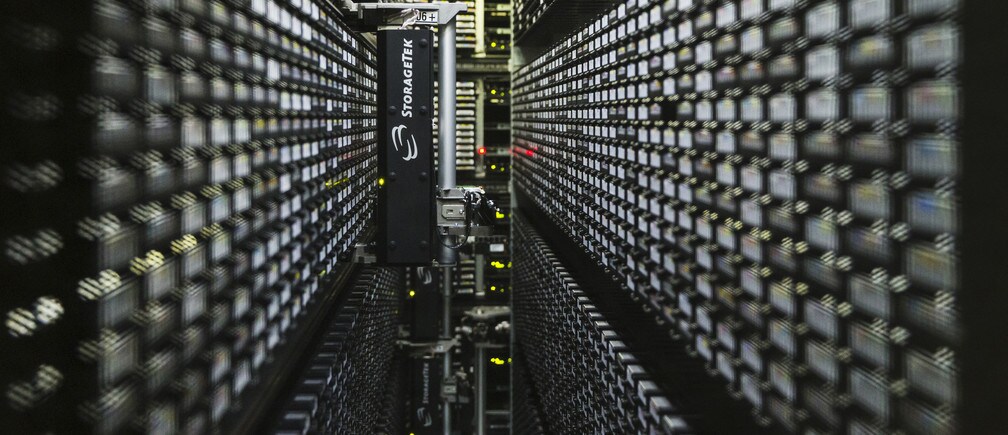
Imagen: Una biblioteca robotizada de cintas, utilizada para el almacenamiento masivo de datos digitales, en el Konrad-Zuse Centre for applied mathematics and computer science (ZIB), en Berlín, el 13 de agosto de 2013. REUTERS/Thomas Peter.


