Este artículo se publica en colaboración con The Conversation.
La finalización del primer borrador de la secuencia del genoma humano se anunció entre aplausos entusiastas en junio de 2000 ante un público de periodistas reunidos en la Casa Blanca y en Downing Street. Craig Venter, que dirigió uno de los dos equipos de científicos que logró esta notable hazaña, afirmó que disponer de esta información encerraba «el potencial de reducir a cero el número de muertes por cáncer durante nuestras vidas». Y el presidente Bill Clinton aseguró que «es ya concebible que los hijos de nuestros hijos conozcan la palabra cáncer solo como una constelación de estrellas».
Quince años después, no hace falta ser científico para darse cuenta de que esto no es exactamente lo que ha ocurrido. Entonces, ¿qué salió mal? ¿Son las enormes promesas hechas por Venter y otros más retórica que realidad, o todavía hay esperanza para la medicina personalizada?
Tu código genético es único, a menos que seas gemelo idéntico. Especifica con exactitud por qué cada parte de tu cuerpo es como es. Pero, además de controlar por qué tu cabello es castaño y no negro, las variaciones en tu código genético también determinan el riesgo que tienes de desarrollar ciertas enfermedades, y por qué podrías responder bien a algunos medicamentos y no a otros.
La publicación de la secuencia del genoma humano al cambio de siglo anunció una nueva era de la medicina, en la que las terapias se adaptarían al código genético único de cada persona, dejando atrás tratamientos indiscriminados y dañinos como la quimioterapia.
Entonces, si la tecnología está disponible para secuenciar el genoma de todas las personas, ¿por qué los médicos no piden ahora una muestra de ADN como parte de un diagnóstico rutinario?
No todo el ADN basura carece de valor
La razón es que, más de una década después de publicarse el primer borrador del genoma humano, seguimos sin saber realmente qué hace la mayor parte de él.
Una de las sorpresas más notables de la finalización del primer borrador de la secuencia fue que hay muchos menos genes de los que nadie había previsto. De hecho, los genes constituyen solo el 2 % del genoma humano, mientras que el 98 % restante suele descartarse como ADN «basura».
La siguiente sorpresa llegó cuando, tras secuenciar los genomas de miles de pacientes que padecían diversos trastornos genéticos, los científicos descubrieron que el 88 % de los cambios en el código genético asociados a la enfermedad se encontraban en el ADN basura.
Así que ahora los científicos tenemos un problema importante. Podemos secuenciar el genoma de un paciente de forma eficiente y económica, podemos procesar los datos con rapidez e identificar los cambios en el ADN asociados a la enfermedad en cuestión. Pero, en la mayoría de los casos, no tenemos idea de cómo esos cambios provocan los síntomas de la enfermedad.
Descifrar el código
Actualmente, los investigadores del campo de la genómica impulsan con firmeza el desarrollo de herramientas para abordar este problema. Se sabe que una de las cosas que alberga este ADN basura son interruptores que indican a determinados genes cuándo y dónde deben activarse en el cuerpo (por eso solo tenemos una nariz y no nos empiezan a salir ojos en el codo).
También se sabe que muchos cambios en el ADN que causan enfermedades se encuentran dentro de estos interruptores, de modo que un gen determinado no se activa o desactiva en el momento adecuado, o se activa en el momento equivocado en una parte del cuerpo donde no debería estar activo. Si el gen en cuestión controla cómo crecen las células, la consecuencia de un interruptor defectuoso puede ser el cáncer.
Sin embargo, identificar estos interruptores y vincularlos con los genes que afectan no es una tarea trivial. Requiere experimentos enormemente complejos con muestras de tejido escasas y valiosas donadas por pacientes, y después una gran capacidad de cómputo para secuenciar, analizar e interpretar los resultados.
The Wellcome Trust acaba de conceder una subvención de 3 millones de libras al instituto en el que trabajo, el MRC Weatherall Institute of Molecular Medicine en la Universidad de Oxford, para procesar muestras de ADN de pacientes con una enfermedad genética determinada, identificar los cambios en el ADN que subyacen a la afección en cuestión e intentar vincular estos cambios con genes que podrían causar las propias enfermedades.
Con esta estrategia, esperamos añadir funcionalidad a la información de la secuencia de ADN e intentar determinar qué hace realmente ese 98 % de ADN basura y cómo contribuye a la progresión de la enfermedad.
La medicina personalizada sigue siendo un objetivo alcanzable, pero por eso las promesas que hizo Venter cuando se publicó el primer borrador de la secuencia, hace más de una década, aún no se han cumplido. Sí, podemos leer el código genético humano, pero estamos lejos de comprender lo que significa.
La publicación de este artículo no implica el respaldo de sus opiniones por parte del Foro Económico Mundial.
Para estar al día de la Agenda, suscríbase a nuestro boletín semanal.
Autoría: Bryony Graham tiene un puesto de investigación posdoctoral en genética molecular en la Universidad de Oxford.
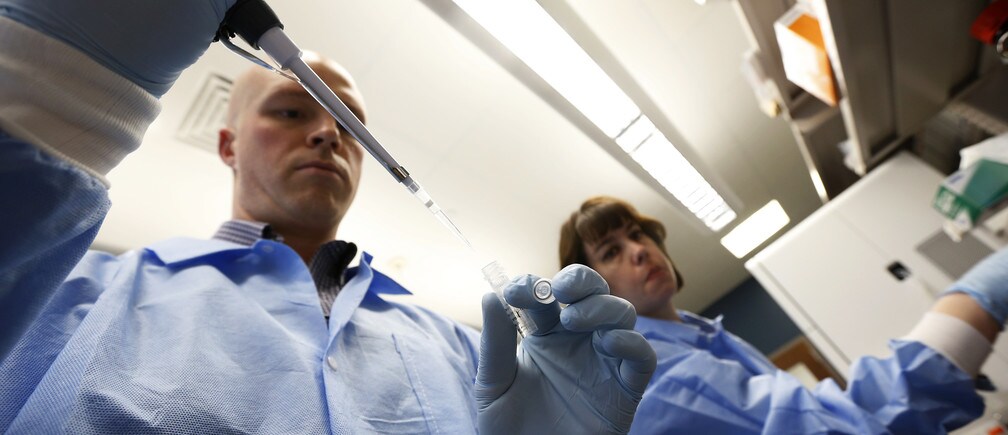
Imagen: el especialista técnico en genética molecular Jaime Wendt (derecha) y Mike Tschannen trabajan en el Human and Molecular Genetics Center Sequencing Core del Medical College of Wisconsin. REUTERS/Jim Young.


