Los investigadores han modificado una partida digital de Monopoly para ayudar a la inteligencia artificial a adaptarse a acontecimientos inesperados.
Para ello, cobraron a los jugadores un impuesto sobre la riqueza cada vez que un jugador pasa por 'Salida', en lugar de darles 200 $.
Experimentos como este podrían mejorar el funcionamiento de la IA en situaciones reales a mayor escala, como la compleja evaluación de si se debe aprobar una tarjeta de crédito a alguien.
Mis colegas y yo modificamos una versión digital del Monopoly para que, en lugar de recibir US$200 cada vez que un jugador pasa por la Salida, el jugador pague un impuesto sobre la riqueza. No lo hicimos para obtener ventaja ni para engañar a nadie. El objetivo es lanzar un desafío inesperado a los agentes de inteligencia artificial que juegan a este juego.
Nuestro objetivo es ayudar a los agentes a aprender a manejar acontecimientos inesperados, algo en lo que las IA han sido hasta ahora claramente deficientes. Dotar a las IA de este tipo de adaptabilidad es importante para sistemas futuristas como los robots quirúrgicos, pero también para algoritmos actuales que deciden quién debe obtener la libertad bajo fianza, quién debe obtener la aprobación de una tarjeta de crédito y qué currículum llega hasta un responsable de contratación. No saber gestionar bien lo inesperado en cualquiera de estas situaciones puede tener consecuencias desastrosas.
Los agentes de IA necesitan la capacidad de detectar, caracterizar y adaptarse a la novedad de forma similar a los humanos. Una situación es novedosa si desafía, directa o indirectamente, el modelo que el agente tiene del mundo exterior, que incluye otros agentes, el entorno y sus interacciones.
Aunque la mayoría de las personas no afrontan la novedad de la forma más perfecta posible, son capaces de aprender de sus errores y adaptarse. Ante un impuesto sobre la riqueza en el Monopoly, un jugador humano podría darse cuenta de que debería haber tenido dinero en efectivo a mano para el IRS al acercarse a la Salida. Un jugador de IA, empeñado en adquirir propiedades y monopolios de forma agresiva, podría no lograr el equilibrio adecuado entre efectivo y activos no líquidos hasta que sea demasiado tarde.
Adaptación a la novedad en mundos abiertos
Aprendizaje por refuerzo es el campo que en gran medida es responsable de los agentes de IA «sobrehumanos» en juegos y de aplicaciones como los coches autónomos. El aprendizaje por refuerzo utiliza recompensas y castigos para que los agentes de IA aprendan por ensayo y error. Forma parte del campo más amplio del aprendizaje automático dentro de la IA.
El aprendizaje en el aprendizaje automático implica que estos sistemas ya son capaces de afrontar tipos limitados de novedad. Los sistemas de aprendizaje automático tienden a funcionar bien con datos de entrada estadísticamente similares, aunque no idénticos, a aquellos con los que fueron entrenados originalmente. En la práctica, es aceptable incumplir esta condición siempre que no sea probable que ocurra nada demasiado inesperado.
Estos sistemas pueden tener problemas en un mundo abierto. Como sugiere su nombre, los mundos abiertos no pueden definirse por completo ni de forma explícita. Lo inesperado puede ocurrir, y ocurre. Y lo más importante: el mundo real es un mundo abierto.
Sin embargo, las IA «sobrehumanas» no están diseñadas para gestionar situaciones muy inesperadas en un mundo abierto. Una de las razones podría ser el uso del propio aprendizaje por refuerzo moderno, que acaba optimizando la IA para el entorno específico en el que fue entrenada. En la vida real no existen tales garantías. Una IA diseñada para la vida real debe ser capaz de adaptarse a la novedad en un mundo abierto.
La novedad como ciudadano de primera clase
Volviendo al Monopoly, imaginemos que ciertas propiedades están sujetas a control de alquileres. Un buen jugador, humano o IA, reconocería que esas propiedades son malas inversiones en comparación con otras que pueden generar alquileres más altos, y no las compraría. Sin embargo, una IA que nunca antes ha visto esta situación, ni nada parecido, probablemente necesitará jugar muchas partidas antes de poder adaptarse.
Antes de que los científicos informáticos puedan siquiera empezar a teorizar sobre cómo construir tales agentes «adaptables a la novedad», necesitan un método riguroso para evaluarlos. Tradicionalmente, la mayoría de los sistemas de IA son probados por las mismas personas que los construyen. Las competiciones son más imparciales, pero hasta la fecha ninguna competición ha evaluado sistemas de IA en situaciones tan inesperadas que ni siquiera sus diseñadores habrían podido prever. Una evaluación de este tipo es el estándar de oro para probar la IA frente a la novedad, de forma similar a los ensayos clínicos aleatorizados para evaluar fármacos.
En 2019, la Agencia de Proyectos de Investigación Avanzada de Defensa de Estados Unidos (DARPA) puso en marcha un programa denominado Science of Artificial Intelligence and Learning for Open-world Novelty, conocido abreviadamente como SAIL-ON. Actualmente financia a numerosos grupos, entre ellos el mío en la Universidad del Sur de California, que investigan la adaptación a la novedad en mundos abiertos.
Una de las muchas innovaciones del programa es que un equipo puede desarrollar un agente de IA que gestione la novedad o diseñar un entorno de mundo abierto para evaluar dichos agentes, pero no ambas cosas. Los equipos que construyen un entorno de mundo abierto también deben teorizar sobre la novedad en ese entorno. Prueban sus teorías y evalúan los agentes creados por otro grupo mediante el desarrollo de un generador de novedades. Estos generadores pueden utilizarse para introducir elementos inesperados en el entorno.
En el marco de SAIL-ON, mis colegas y yo desarrollamos recientemente un simulador llamado Generating Novelty in Open-world Multi-agent Environments, o GNOME. GNOME está diseñado para probar la adaptación de la IA a la novedad en juegos de mesa estratégicos que reflejan elementos del mundo real.
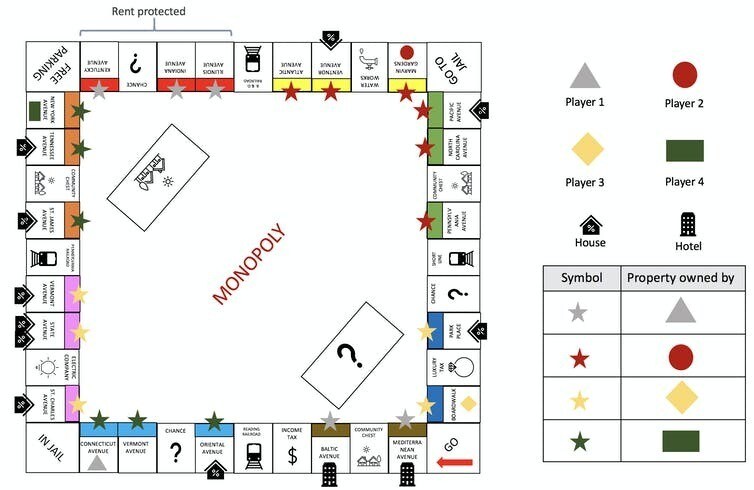
Nuestra primera versión de GNOME utiliza el clásico juego de mesa Monopoly. Recientemente presentamos el GNOME basado en Monopoly en una importante conferencia de aprendizaje automático. Permitimos a los participantes introducir novedades y comprobar por sí mismos cómo se desempeñaban los agentes de IA preprogramados. Por ejemplo, GNOME puede introducir el impuesto sobre la riqueza o el control de alquileres, las «novedades» mencionadas anteriormente, y evaluar la IA tras el cambio.
Al comparar cómo se desempeñó la IA antes y después del cambio de reglas, GNOME puede cuantificar cuánto perjudicó la novedad a la IA en la partida. Si GNOME detecta que la IA ganaba el 80 % de las partidas antes de introducir la novedad y que ahora solo gana el 25 %, la marcará como una IA con mucho margen de mejora.
El futuro: ¿una ciencia de la novedad?
GNOME ya ha sido utilizado para evaluar agentes de IA adaptables a la novedad creados por tres organizaciones independientes también financiadas en el marco de este programa de la DARPA. También hemos desarrollado GNOMEs basados en póker y en «juegos de guerra» similares a Battleship. El próximo año también exploraremos GNOMEs para otros juegos de mesa estratégicos como Risk y Catan. Se espera que esta investigación conduzca a agentes de IA capaces de gestionar la novedad en distintos contextos.
Situar la novedad como eje central de la investigación y evaluación de la IA moderna ha tenido como efecto secundario la producción de un primer conjunto de trabajos en apoyo de una ciencia de la novedad. No solo investigadores como nosotros exploramos definiciones y teorías de la novedad, sino que también estudiamos cuestiones con implicaciones potencialmente fundamentales. Por ejemplo, nuestro equipo analiza cuándo se prevé que una novedad sea imposiblemente difícil para una IA. En el mundo real, si surge una situación así, la IA la reconocería y llamaría a un operador humano.
Para responder a estas y otras preguntas, los científicos informáticos están intentando desarrollar IA capaces de reaccionar adecuadamente ante lo inesperado, incluidos los sucesos de cisne negro como la COVID-19. Quizá no esté lejos el día en que una IA no solo pueda vencer a los humanos en sus juegos actuales, sino también adaptarse rápidamente a cualquier versión de esos juegos que los humanos puedan imaginar. Incluso podría ser capaz de adaptarse a situaciones que hoy no podemos concebir.




