El Grupo AnyScale Learning For All (ALFA) del Laboratorio de Ciencias de la Computación e Inteligencia Artificial del MIT (CSAIL) tiene como objetivo resolver los problemas más complejos relacionados con los macrodatos: preguntas que exceden el alcance de los análisis habituales. ALFA aplica los conceptos más recientes de aprendizaje automático y computación evolutiva para abordar problemas muy complejos que implican una alta dimensionalidad.
«Hoy en día, la gente recibe datos de tantos canales distintos», afirma Una-May O’Reilly, directora de ALFA e investigadora científica principal en CSAIL. «Les ayudamos a conectar y vincular los datos entre esos canales».
El Grupo ALFA ha afrontado retos que van desde diseñar la distribución de parques eólicos hasta estudiar y categorizar los latidos en los datos de presión arterial para predecir caídas y picos. El grupo también analiza enormes volúmenes de datos de clics registrados para predecir el comportamiento de aprendizaje en los MOOC, e incluso ayuda al IRS a protegerse contra costosos esquemas de evasión fiscal.
ALFA prefiere el reto de trabajar con datos sin procesar que proceden directamente de la fuente. Luego investiga los datos mediante diversas técnicas, la mayoría de las cuales implican algoritmos escalables de aprendizaje automático y computación evolutiva.
«El aprendizaje automático es muy útil para revisar retrospectivamente los datos y ayudarte a predecir el futuro», afirma O’Reilly. «La computación evolutiva puede utilizarse del mismo modo y resulta especialmente adecuada para problemas a gran escala y con dimensiones muy elevadas».
En el pasado, el aprendizaje automático se veía limitado por la falta de datos suficientes para inferir modelos predictivos o etiquetas de clasificación, señala O’Reilly. «Ahora tenemos demasiados datos, así que contamos con aprendizaje automático escalable para intentar procesar una enorme cantidad de ejemplos de datos», afirma. «También necesitamos mejorar la capacidad del aprendizaje automático para lidiar con las variables adicionales que acompañan a los problemas de dimensionalidad extremadamente alta».
O’Reilly siente un interés especial por la otra herramienta principal de ALFA: la computación evolutiva. «Tomar ideas de la evolución, como la adaptación basada en poblaciones y la herencia genética, e incorporarlas a modelos computacionales resulta muy eficaz», afirma. «En ingeniería, solemos utilizar algoritmos evolutivos, como la adaptación de la matriz de covarianza o los algoritmos de valores discretos, para la optimización. Además, paralelizar algoritmos evolutivos es casi ridículamente fácil, lo que les permite abordar muchos de los problemas más recientes de descubrimiento de conocimiento a partir de datos».
Dentro del campo evolutivo, O’Reilly siente especial interés por la programación genética o, como ella la define, «la evolución de programas». «Distribuimos los algoritmos de programación genética entre muchos nodos y luego dividimos los datos entre ellos», explica. «Tomamos todas las soluciones independientes que podemos calcular en paralelo y las reunimos. Después eliminamos las más débiles y fusionamos colectivamente las más sólidas para crear un conjunto. Hemos demostrado que los modelos basados en conjuntos son más precisos que un único modelo basado en todos los datos».
Diseño de la distribución de parques eólicos
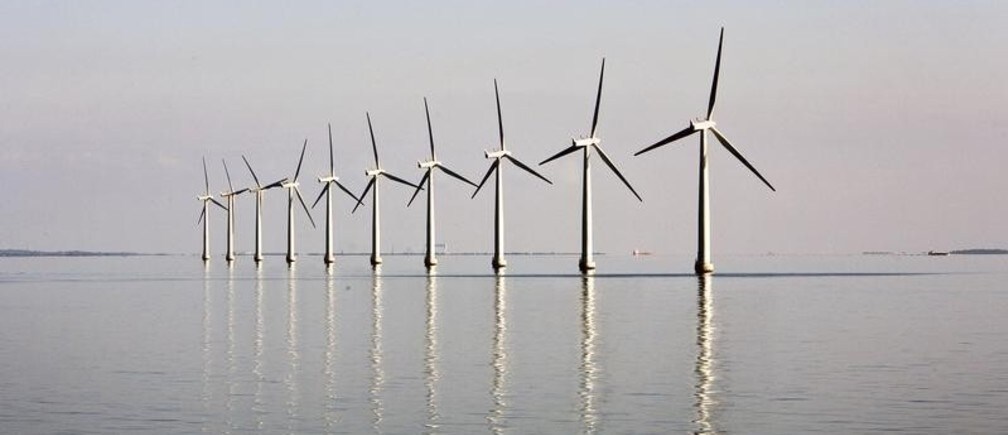
Uno de los proyectos más exitosos de ALFA ha consistido en desarrollar algoritmos para ayudar a diseñar parques eólicos. El problema se caracteriza por una dimensionalidad muy alta, sobre todo cuando hay cientos de turbinas, afirma O’Reilly.
«Se pueden lograr grandes mejoras de eficiencia al optimizar la ubicación de las turbinas, pero es un problema realmente complejo», afirma. «En primer lugar, están los parámetros de la propia turbina: su producción de energía, su altura y su cono de proximidad. Hay que averiguar cuánto viento requiere el emplazamiento y luego obtener información más detallada sobre de dónde viene el viento y en qué cantidades. Hay que tener en cuenta las condiciones topográficas del terreno y la forma en que el viento lo atraviesa».
La variable más difícil es el efecto de estela de una turbina sobre las turbinas que hay detrás, afirma O’Reilly. «Tenemos que realizar modelos de flujo muy complejos para poder calcular la pérdida detrás de cada turbina».
ALFA descubrió cómo aplicar algoritmos evolutivos paralelizados que pudieran ampliarse a parques eólicos de más de mil turbinas. «Pudimos ampliar el diseño de la distribución de turbinas a una escala mayor que nunca antes», afirma O’Reilly.
Más recientemente, ALFA ha estado creando una plantilla generativa para el diseño de emplazamientos. «Ahora utilizamos conceptos evolutivos para desarrollar un programa que pueda distribuir cualquier conjunto de turbinas en cualquier emplazamiento», afirma. «Estamos creando un proceso de diseño, no el diseño del emplazamiento en sí».
GigaBEATS: comprender los datos de presión arterial
Muchos de los mismos conceptos evolutivos y de aprendizaje automático que se utilizan para diseñar la distribución de un parque eólico también pueden aplicarse para obtener información de los datos clínicos. ALFA intenta extraer información útil del creciente volumen de datos fisiológicos recopilados por sensores médicos. Estos datos incluyen mediciones de todo tipo, desde patrones de sueño hasta ECG y presión arterial.
«A los profesionales clínicos les cuesta comprender un volumen de datos tan elevado», afirma O’Reilly. «Nos interesa tomar información a nivel de señal y combinarla con el aprendizaje automático para hacer mejores predicciones».
Los investigadores suelen recopilar una pequeña cantidad de datos de una muestra reducida y realizar un estudio que dura más de 18 meses, afirma O’Reilly. «Queremos reducir esos 18 meses a horas», dice.
ALFA trabaja en un proyecto llamado GigaBEATS que extrae conocimiento de conjuntos muy grandes de datos fisiológicos. Al principio, el proyecto ha estudiado datos de presión arterial tomados de miles de pacientes en unidades de cuidados intensivos.
«Examinamos las características microscópicas de cada latido», afirma O’Reilly. «Con el tiempo, agregaremos esas características en segmentos históricos que nos permitan predecir picos de presión arterial».
El grupo ALFA ha creado una base de datos llamada BeatDB que recopila no solo los latidos de las formas de onda, sino también «un conjunto de propiedades o características de cada latido», afirma O’Reilly. BeatDB ya ha almacenado mil millones de características de latidos de presión arterial de más de 5.000 pacientes.
«Para cada latido describimos un conjunto de características morfológicas de series temporales», explica O’Reilly. «Una vez que establecemos un conjunto sólido de datos fundamentales sobre las señales, podemos ofrecer tecnología como servicio sobre esa base, lo que permite añadir y procesar nuevos latidos».
Como BeatDB permite agregar los latidos en segmentos, los médicos pueden decidir mejor cuántos datos históricos necesitan para hacer una predicción. «Para predecir una caída de la presión arterial con 15 minutos de antelación, quizá se necesiten horas de datos del paciente», afirma O’Reilly. «Como los datos de BeatDB están organizados y aprovechan algoritmos de aprendizaje automático, los médicos no tienen que calcular esto una y otra vez. Pueden probar cuántos datos y cuánto tiempo de antelación se necesitan, y luego comprobar la precisión de sus modelos».
Recientemente, O’Reilly ha empezado a utilizar esta tecnología para explorar datos de ECG. «Esperamos analizar datos que podrían recopilarse en el contexto del yo cuantificado», afirma O’Reilly, en referencia a la práctica emergente de llevar pulseras de actividad física para hacer un seguimiento de los datos internos del propio cuerpo.
«Cada vez más personas monitorizan su propio cuerpo con una Fitbit que les indica si están cansadas o qué tan bien duermen», afirma O’Reilly. «Interpretar todas estas señales corporales es similar al proyecto GigaBEATS. Se podría crear en torno a estas señales una base de datos similar a BeatDB y una plataforma basada en la nube para ayudar a interpretarlas».
Este artículo se publica en colaboración con MIT News. La publicación no implica que el Foro Económico Mundial respalde las opiniones expresadas.
Para mantenerse al día con Forum:Agenda, suscríbase a nuestro boletín semanal.
Autor: Eric Brown es colaborador invitado de MIT News.
Imagen: Un parque eólico marino se alza sobre el agua cerca de la isla danesa de Samso, el 19 de mayo de 2008. REUTERS/Bob Strong.