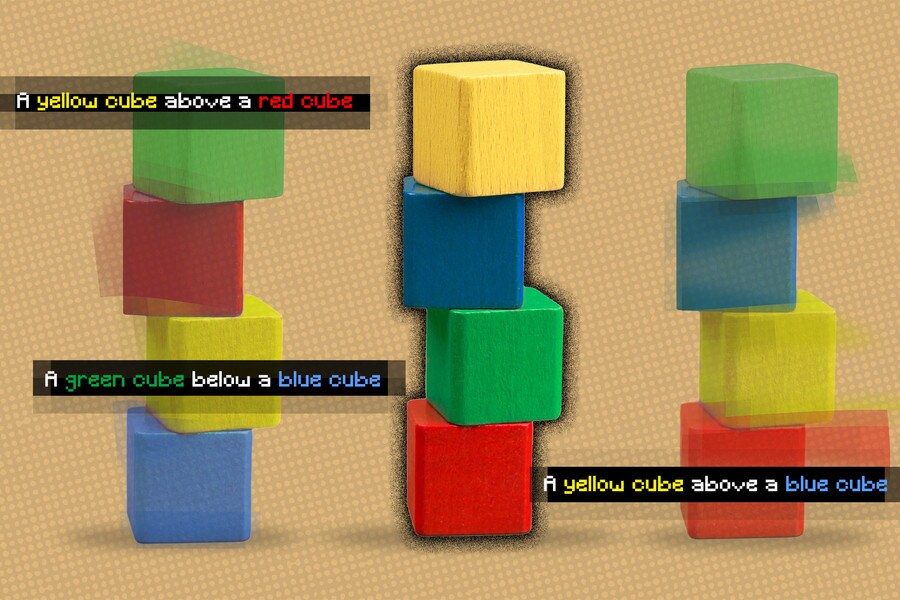
Investigadores del MIT han desarrollado un modelo que comprende las relaciones subyacentes entre los objetos de una escena.
Su modelo representa las relaciones individuales de una en una y, a continuación, combina estas representaciones para describir la escena en su conjunto.
Esto permite al modelo generar imágenes más precisas a partir de descripciones textuales, incluso cuando la escena incluye varios objetos dispuestos en distintas relaciones entre sí.
Cuando los humanos observan una escena, perciben los objetos y las relaciones entre ellos. Sobre su escritorio, puede haber un portátil situado a la izquierda de un teléfono, que a su vez está delante de un monitor de ordenador.
Muchos modelos de aprendizaje profundo tienen dificultades para percibir el mundo de esta manera, porque no comprenden las relaciones entrelazadas entre los objetos individuales. Sin el conocimiento de estas relaciones, un robot diseñado para ayudar a alguien en la cocina tendría dificultades para seguir una orden como «recoge la espátula que está a la izquierda de la cocina y colócala encima de la tabla de cortar».
Para resolver este problema, investigadores del MIT han desarrollado un modelo que comprende las relaciones subyacentes entre los objetos de una escena. Su modelo representa las relaciones individuales de una en una y, a continuación, combina estas representaciones para describir la escena en su conjunto. Esto permite al modelo generar imágenes más precisas a partir de descripciones textuales, incluso cuando la escena incluye varios objetos dispuestos en distintas relaciones entre sí.
Este trabajo podría aplicarse en situaciones en las que los robots industriales deben realizar tareas de manipulación complejas y de varios pasos, como apilar artículos en un almacén o montar electrodomésticos. Además, acerca un paso más al campo al desarrollo de máquinas que puedan aprender de su entorno e interactuar con él de forma más parecida a como lo hacen los humanos.
«Cuando miro una mesa, no puedo decir que haya un objeto en la ubicación XYZ. Nuestra mente no funciona así. En nuestra mente, cuando entendemos una escena, la comprendemos realmente en función de las relaciones entre los objetos. Creemos que, si construimos un sistema que pueda comprender las relaciones entre los objetos, podríamos usar ese sistema para manipular y modificar nuestro entorno de forma más eficaz», afirma Yilun Du, estudiante de doctorado en el Laboratorio de Informática e Inteligencia Artificial (CSAIL) y coautor principal del artículo.
Du escribió el artículo junto con los coautores principales Shuang Li, estudiante de doctorado del CSAIL, y Nan Liu, estudiante de posgrado en la Universidad de Illinois en Urbana-Champaign; así como Joshua B. Tenenbaum, catedrático de ciencia cognitiva computacional del Departamento de Ciencias del Cerebro y Cognición y miembro del CSAIL; y el autor principal Antonio Torralba, catedrático Delta Electronics de Ingeniería Eléctrica e Informática y miembro del CSAIL. La investigación se presentará en diciembre en la Conferencia sobre Sistemas de Procesamiento de Información Neuronal.
Una relación a la vez
El marco desarrollado por los investigadores puede generar una imagen de una escena a partir de una descripción textual de objetos y sus relaciones, como «Una mesa de madera a la izquierda de un taburete azul. Un sofá rojo a la derecha de un taburete azul».
Su sistema descompondría estas oraciones en dos fragmentos más pequeños que describen cada relación individual («una mesa de madera a la izquierda de un taburete azul» y «un sofá rojo a la derecha de un taburete azul») y, a continuación, modelaría cada parte por separado. Después, estos fragmentos se combinan mediante un proceso de optimización que genera una imagen de la escena.
Los investigadores utilizaron una técnica de aprendizaje automático denominada modelos basados en energía para representar las relaciones individuales entre objetos en una descripción de escena. Esta técnica les permite utilizar un modelo basado en energía para codificar cada descripción relacional y, después, componerlas de forma que se infieran todos los objetos y relaciones.
Al dividir las oraciones en fragmentos más cortos para cada relación, el sistema puede recombinarlos de diversas maneras, por lo que es más capaz de adaptarse a descripciones de escenas que no ha visto antes, explica Li.
«Otros sistemas tomarían todas las relaciones de forma global y generarían la imagen de una sola vez a partir de la descripción. Sin embargo, estos enfoques fallan cuando tenemos descripciones fuera de distribución, como descripciones con más relaciones, ya que estos modelos no pueden adaptarse realmente para generar, de una sola vez, imágenes que contengan más relaciones. Sin embargo, al componer estos modelos más pequeños y separados, podemos modelar un mayor número de relaciones y adaptarnos a nuevas combinaciones», afirma Du.
El sistema también funciona en sentido inverso: dada una imagen, puede encontrar descripciones textuales que coincidan con las relaciones entre los objetos de la escena. Además, su modelo puede utilizarse para editar una imagen reorganizando los objetos de la escena para que coincidan con una nueva descripción.
Comprender escenas complejas
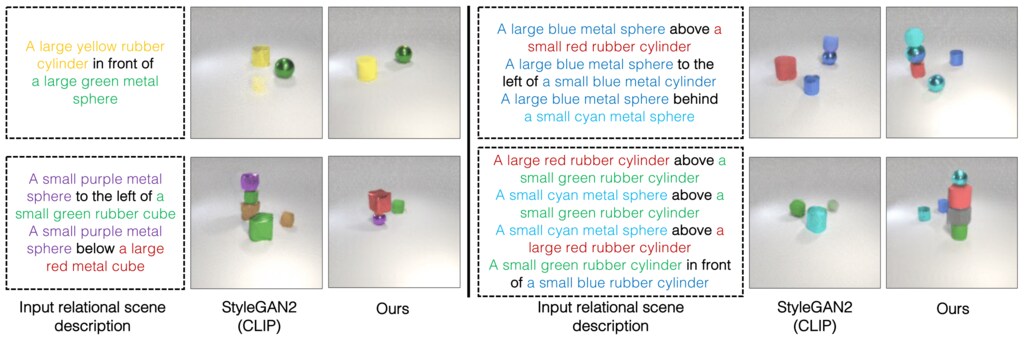
Los investigadores compararon su modelo con otros métodos de aprendizaje profundo a los que se proporcionaron descripciones textuales y se les encomendó generar imágenes que mostraran los objetos correspondientes y sus relaciones. En todos los casos, su modelo superó a los métodos de referencia.
También pidieron a personas que evaluaran si las imágenes generadas coincidían con la descripción original de la escena. En los ejemplos más complejos, en los que las descripciones contenían tres relaciones, el 91 por ciento de los participantes concluyó que el nuevo modelo funcionaba mejor.
«Una cosa interesante que descubrimos es que, con nuestro modelo, podemos pasar de una oración con una descripción de relación a una con dos, tres o incluso cuatro descripciones, y nuestro enfoque sigue siendo capaz de generar imágenes que se corresponden correctamente con esas descripciones, mientras que otros métodos fallan», afirma Du.
Los investigadores también mostraron al modelo imágenes de escenas que no había visto antes, así como varias descripciones textuales diferentes de cada imagen, y este fue capaz de identificar con éxito la descripción que mejor se correspondía con las relaciones entre los objetos de la imagen.
Y cuando los investigadores proporcionaron al sistema dos descripciones relacionales de una misma escena, formuladas de manera distinta, el modelo fue capaz de entender que las descripciones eran equivalentes.
Los investigadores quedaron impresionados por la solidez de su modelo, especialmente al trabajar con descripciones que no había encontrado antes.
«Esto es muy prometedor, porque se parece más a la forma en que trabajan los humanos. Los humanos pueden ver solo algunos ejemplos, pero podemos extraer información útil de esos pocos ejemplos y combinarlos para crear combinaciones infinitas. Y nuestro modelo tiene una propiedad que le permite aprender con menos datos, pero generalizar a escenas más complejas o a la generación de imágenes más complejas», afirma Li.
Aunque estos primeros resultados son alentadores, los investigadores quieren ver cómo funciona su modelo con imágenes del mundo real más complejas, con fondos ruidosos y objetos que se bloquean entre sí.
También les interesa incorporar en el futuro su modelo a sistemas robóticos, para que un robot pueda inferir relaciones entre objetos a partir de vídeos y, después, aplicar este conocimiento para manipular objetos en el mundo.
«Desarrollar representaciones visuales que puedan tratar la naturaleza compositiva del mundo que nos rodea es uno de los principales problemas abiertos en visión artificial. Este artículo supone un avance significativo en este problema al proponer un modelo basado en energía que modela explícitamente múltiples relaciones entre los objetos representados en la imagen. Los resultados son realmente impresionantes», afirma Josef Sivic, investigador destacado del Instituto Checo de Informática, Robótica y Cibernética de la Universidad Técnica Checa, que no participó en esta investigación.
Esta investigación cuenta, en parte, con el apoyo de Raytheon BBN Technologies Corp., Mitsubishi Electric Research Laboratory, la Fundación Nacional de Ciencias de Estados Unidos, la Oficina de Investigación Naval, y el Centro de Investigación Thomas J. Watson de IBM.




