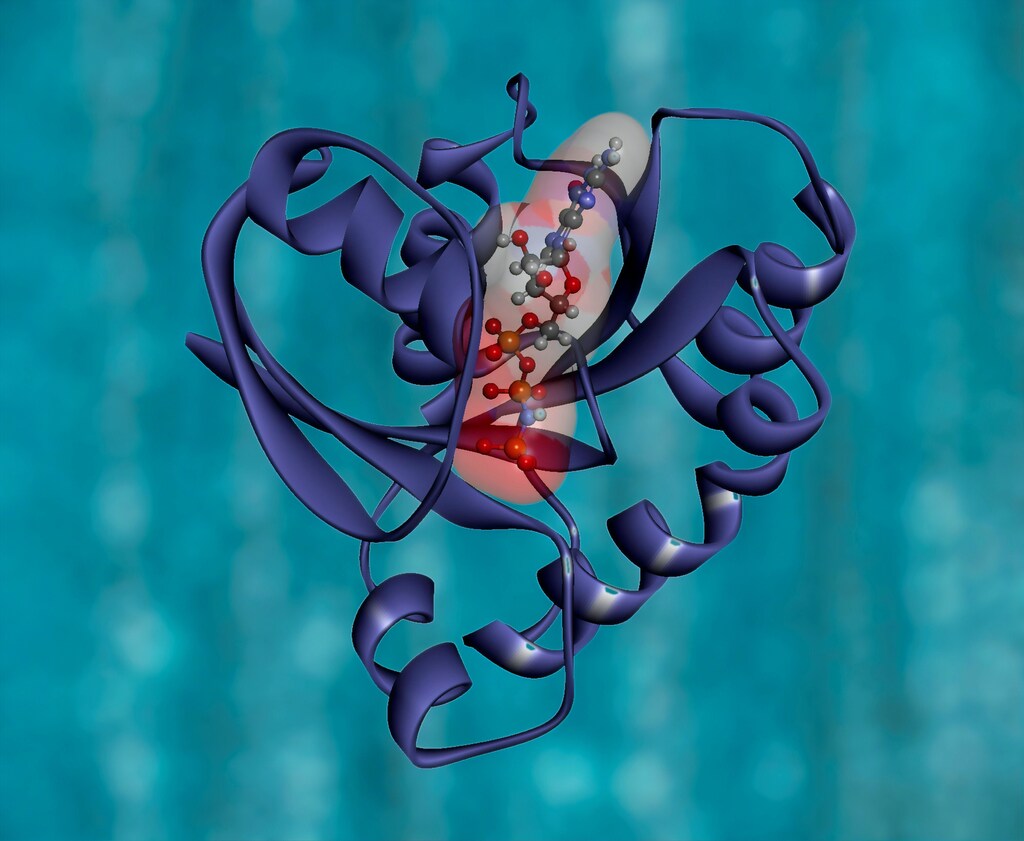
Programas de IA como AlphaFold2 y RoseTTAFold permiten a los investigadores determinar las estructuras tridimensionales de las proteínas a partir de la secuencia de aminoácidos.
Pero AlphaFold2 ahora ha podido modelar correctamente si los aminoácidos reaccionarán entre sí, pese a no haber sido diseñado para predecir ese tipo de cosas.
El resultado plantea preguntas sobre qué más pueden hacer los algoritmos de aprendizaje profundo y si estos saltos de capacidad son deseables.
La inteligencia artificial ha cambiado la forma de hacer ciencia al permitir que los investigadores analicen las enormes cantidades de datos que generan los instrumentos científicos modernos. Puede encontrar una aguja en un millón de pajares de información y, mediante el aprendizaje profundo, puede aprender de los propios datos. La IA está acelerando los avances en la búsqueda de genes, la medicina, el diseño de fármacos y la creación de compuestos orgánicos.
El aprendizaje profundo utiliza algoritmos, a menudo redes neuronales entrenadas con grandes cantidades de datos, para extraer información de datos nuevos. Es muy distinto de la informática tradicional, basada en instrucciones paso a paso. En cambio, aprende de los datos. El aprendizaje profundo es mucho menos transparente que la programación informática tradicional, lo que deja preguntas importantes: ¿qué ha aprendido el sistema?, ¿qué sabe?
Como profesor de química, me gusta diseñar pruebas que incluyan al menos una pregunta difícil que amplíe los conocimientos de los estudiantes, para determinar si pueden combinar distintas ideas y sintetizar ideas y conceptos nuevos. Hemos ideado una pregunta de este tipo para AlphaFold, el ejemplo emblemático de los defensores de la IA, que ha resuelto el problema del plegamiento de proteínas.
Plegamiento de proteínas
Las proteínas están presentes en todos los organismos vivos. Proporcionan estructura a las células, catalizan reacciones, transportan moléculas pequeñas, digieren alimentos y hacen mucho más. Están formadas por largas cadenas de aminoácidos, como cuentas en un hilo. Pero, para desempeñar su función en la célula, una proteína debe torcerse y doblarse hasta adoptar una estructura tridimensional compleja, un proceso llamado plegamiento de proteínas. Las proteínas mal plegadas pueden causar enfermedades.
En su discurso de aceptación del Nobel de Química de 1972, Christiaan Anfinsen postuló que debería ser posible calcular la estructura tridimensional de una proteína a partir de la secuencia de sus componentes, los aminoácidos.
Del mismo modo que el orden y el espaciado de las letras de este artículo le dan sentido y transmiten un mensaje, el orden de los aminoácidos determina la identidad y la forma de la proteína, lo que da lugar a su función.
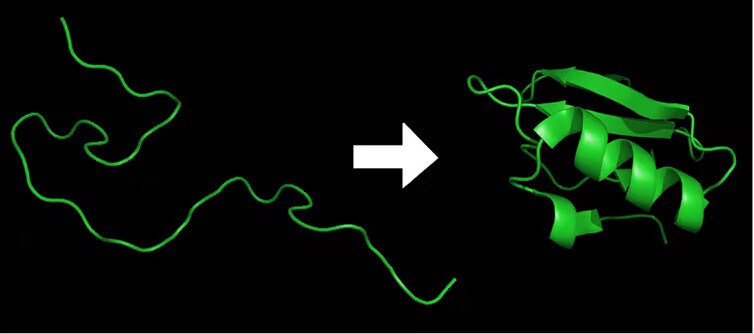
Debido a la flexibilidad inherente de los componentes básicos de los aminoácidos, se estima que una proteína típica puede adoptar 10 elevado a 300 formas distintas. Es una cifra enorme, superior al número de átomos del universo. Sin embargo, en un milisegundo cada proteína de un organismo se pliega y adopta su propia forma específica: la disposición de menor energía de todos los enlaces químicos que la componen. Si se cambia un solo aminoácido entre los cientos que suelen encontrarse en una proteína, esta puede plegarse mal y dejar de funcionar.
AlphaFold
Durante 50 años, los informáticos han intentado resolver el problema del plegamiento de proteínas, con poco éxito. Después, en 2016, DeepMind, una filial de IA de Alphabet, la empresa matriz de Google, puso en marcha su programa AlphaFold. Utilizó el banco de datos de proteínas como conjunto de entrenamiento, que contiene las estructuras de más de 150.000 proteínas determinadas experimentalmente.
En menos de cinco años, AlphaFold había resuelto el problema del plegamiento de proteínas —al menos la parte más útil: determinar la estructura de una proteína a partir de su secuencia de aminoácidos—. AlphaFold no explica cómo las proteínas se pliegan con tanta rapidez y precisión. Fue un gran triunfo para la IA, porque no solo le reportó un enorme prestigio científico, sino que también supuso un avance científico importante que podría afectar a la vida de todos.
Hoy, gracias a programas como AlphaFold2 y RoseTTAFold, investigadores como yo podemos determinar gratis, en una o dos horas, la estructura tridimensional de las proteínas a partir de la secuencia de aminoácidos que las componen. Antes de AlphaFold2, teníamos que cristalizar las proteínas y resolver sus estructuras mediante la cristalografía de rayos X, un proceso que llevaba meses y costaba decenas de miles de dólares por estructura.
Ahora también tenemos acceso a la Base de datos de estructuras de proteínas AlphaFold, donde DeepMind ha depositado las estructuras tridimensionales de casi todas las proteínas presentes en los seres humanos, los ratones y más de otras 20 especies. Hasta la fecha, ha resuelto más de un millón de estructuras y prevé añadir otros 100 millones solo este año. El conocimiento sobre las proteínas se ha disparado. Es probable que para finales de 2022 se haya documentado la estructura de la mitad de todas las proteínas conocidas, entre ellas muchas estructuras nuevas y únicas asociadas a funciones útiles novedosas.
Pensar como un químico
AlphaFold2 no fue diseñado para predecir cómo interactuarían las proteínas entre sí; sin embargo, ha podido modelar cómo las proteínas individuales se combinan para formar grandes unidades complejas compuestas por varias proteínas. Teníamos una pregunta difícil para AlphaFold: ¿le había enseñado química su conjunto de entrenamiento estructural? ¿Podía determinar si los aminoácidos reaccionarían entre sí, algo poco frecuente pero importante?
Soy químico computacional y me interesan las proteínas fluorescentes. Se encuentran en cientos de organismos marinos, como las medusas y los corales. Su brillo puede utilizarse para iluminar y estudiar enfermedades.
Hay 578 proteínas fluorescentes en el banco de datos de proteínas, de las cuales 10 están «estropeadas» y no emiten fluorescencia. Las proteínas rara vez se atacan a sí mismas, un proceso llamado modificación postraduccional autocatalítica, y es muy difícil predecir cuáles reaccionarán consigo mismas y cuáles no.
Solo un químico con amplios conocimientos sobre proteínas fluorescentes podría utilizar la secuencia de aminoácidos para encontrar aquellas proteínas fluorescentes cuya secuencia de aminoácidos es la adecuada para experimentar las transformaciones químicas necesarias para hacerlas fluorescentes. Cuando presentamos a AlphaFold2 las secuencias de 44 proteínas fluorescentes que no están en el banco de datos de proteínas, plegó de forma diferente las proteínas fluorescentes funcionales y las defectuosas.
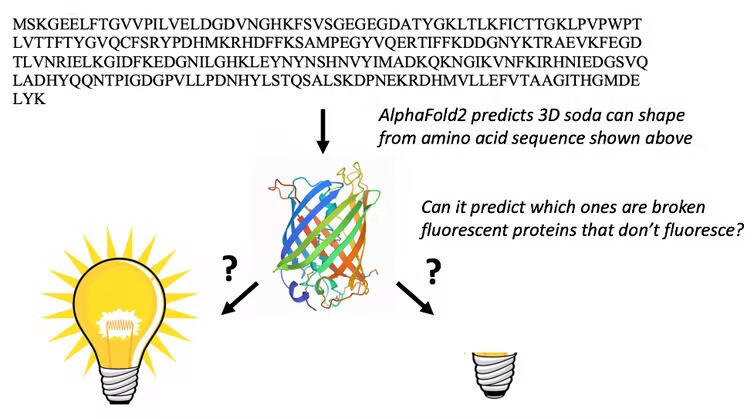
El resultado nos dejó atónitos: AlphaFold2 había aprendido algo de química. Había descubierto qué aminoácidos de las proteínas fluorescentes llevan a cabo la química que las hace brillar. Sospechamos que el conjunto de entrenamiento del banco de datos de proteínas y los alineamientos de secuencias múltiples permiten a AlphaFold2 «pensar» como los químicos y buscar los aminoácidos necesarios para que reaccionen entre sí y hagan fluorescente a la proteína.
Que un programa de plegamiento aprenda algo de química a partir de su conjunto de entrenamiento también tiene implicaciones más amplias. Si planteamos las preguntas adecuadas, ¿qué más podemos obtener de otros algoritmos de aprendizaje profundo? ¿Podrían los algoritmos de reconocimiento facial encontrar indicadores ocultos de enfermedades? ¿Podrían los algoritmos diseñados para predecir los patrones de gasto de los consumidores detectar también una propensión al hurto menor o al engaño? Y, lo más importante, ¿es deseable esta capacidad —y saltos de capacidad similares en otros sistemas de IA?




