Los relojes de los chips informáticos han dejado de aumentar su velocidad. Para seguir mejorando el rendimiento, los fabricantes de chips están dotándolos de más unidades de procesamiento, o núcleos, capaces de ejecutar cálculos en paralelo.
Sin embargo, la forma en que un chip distribuye los cálculos puede influir mucho en su rendimiento. En un artículo de 2013, Daniel Sanchez, profesor asistente TIBCO Founders del Departamento de Ingeniería Eléctrica y Ciencias de la Computación del MIT, y su estudiante Nathan Beckmann describieron un sistema que distribuye de forma inteligente los datos entre los bancos de memoria de los chips multinúcleo. El sistema mejoró los tiempos de ejecución en un 18 por ciento de media y, al mismo tiempo, aumentó la eficiencia energética.
Este mes, en el Simposio Internacional sobre Arquitectura de Computadores de Alto Rendimiento del Institute of Electrical and Electronics Engineers, miembros del grupo de Sanchez han sido nominados a un premio al mejor artículo por una ampliación del sistema que controla la distribución no solo de los datos, sino también de los cálculos. En simulaciones con un chip de 64 núcleos, el sistema aumentó la velocidad de cálculo un 46 por ciento y redujo el consumo energético un 36 por ciento.
«Ahora que la forma de mejorar el rendimiento consiste en añadir más núcleos y pasar a sistemas paralelos de mayor escala, hemos visto realmente que el principal cuello de botella está en la comunicación y los accesos a memoria», afirma Sanchez. «Una parte importante de lo que hicimos en el proyecto anterior fue colocar los datos cerca de los cálculos. Pero hemos visto que la forma de colocar esos cálculos influye mucho en lo bien que se pueden situar los datos cerca de ellos».
Desacoplamiento
El problema de asignar conjuntamente los cálculos y los datos es muy similar a uno de los problemas canónicos del diseño de chips, conocido como «colocación y encaminamiento». Este problema parte de la especificación de un conjunto de circuitos lógicos y busca organizarlos en el chip para minimizar las distancias entre los elementos de circuito que trabajan en conjunto.
Este problema se conoce como NP-difícil, lo que significa que, hasta donde se sabe, ni siquiera todos los ordenadores del mundo podrían encontrar la solución óptima para chips de tamaño moderado durante la vida del universo. Sin embargo, los fabricantes de chips han desarrollado varios algoritmos que, aunque no son absolutamente óptimos, parecen funcionar bien en la práctica.
Adaptados al problema de asignar cálculos y datos en un chip de 64 núcleos, estos algoritmos tardan varias horas en llegar a una solución. Sanchez, Beckmann y Po-An Tsai, otro estudiante del grupo de Sanchez, desarrollaron su propio algoritmo, que encuentra una solución con una eficiencia superior al 99 por ciento de la que ofrecen los algoritmos estándar de colocación y encaminamiento. Pero lo hace en milisegundos.
«Lo que hacemos es colocar primero los datos de manera aproximada», explica Sanchez. «Distribuimos los datos de tal forma que no haya demasiados bancos [de memoria] sobrecargados ni todos los datos concentrados en una región del chip. Luego determinamos cómo colocar los hilos [de cálculo] para que estén cerca de los datos y, después, ajustamos la ubicación de los datos teniendo en cuenta la de los hilos. Al resolverlo en esos tres pasos, desacoplamos el problema».
En principio, añade Beckmann, el proceso podría repetirse, reasignando de nuevo los cálculos para adaptarse a la ubicación de los datos, y viceversa. «Pero alcanzamos el 1 por ciento, así que paramos», dice. «En realidad, eso fue todo».
Un seguimiento constante
El sistema de los investigadores del MIT supervisa el comportamiento del chip y reasigna los datos y los hilos cada 25 milisegundos. Puede parecer rápido, pero es tiempo suficiente para que un chip informático realice 50 millones de operaciones.
Durante ese intervalo, el monitor toma muestras aleatorias de las solicitudes que los distintos núcleos envían a la memoria y almacena las ubicaciones de memoria solicitadas, en forma abreviada, en su propio circuito de memoria.
Cada núcleo de un chip tiene su propia caché: un banco de memoria local y de alta velocidad donde almacena los datos que utiliza con frecuencia. A partir de sus muestras, el monitor calcula cuánto espacio de caché necesitará cada núcleo y registra qué núcleos acceden a qué datos.
El monitor ocupa alrededor del 1 por ciento de la superficie del chip, que de otro modo podría destinarse a circuitos de cálculo adicionales. Sin embargo, Sanchez cree que los fabricantes de chips considerarían que ese es un precio pequeño a cambio de mejoras significativas del rendimiento.
«Hubo un importante estudio de la Academia Nacional y un estudio patrocinado por DARPA sobre la importancia de que la comunicación predomine sobre el cálculo», afirma David Wood, profesor de informática en la Universidad de Wisconsin-Madison. «Algunos de estos estudios muestran que se consume un orden de magnitud más de energía al trasladar los operandos hasta el cálculo que en el cálculo mismo. En algunos casos, la diferencia es de dos órdenes de magnitud. Eso significa que hay que evitar hacerlo».
Los investigadores del MIT «presentan una propuesta que parece funcionar en problemas prácticos y puede ofrecer resultados realmente espectaculares», afirma Wood. «Es un problema importante, y los resultados parecen muy prometedores».
Este artículo se publica en colaboración con MIT News. La publicación no implica que el Foro Económico Mundial respalde estas opiniones.
Para estar al día de la Agenda, suscríbase a nuestro boletín semanal.
Autor: Larry Hardesty es colaborador de MIT News.
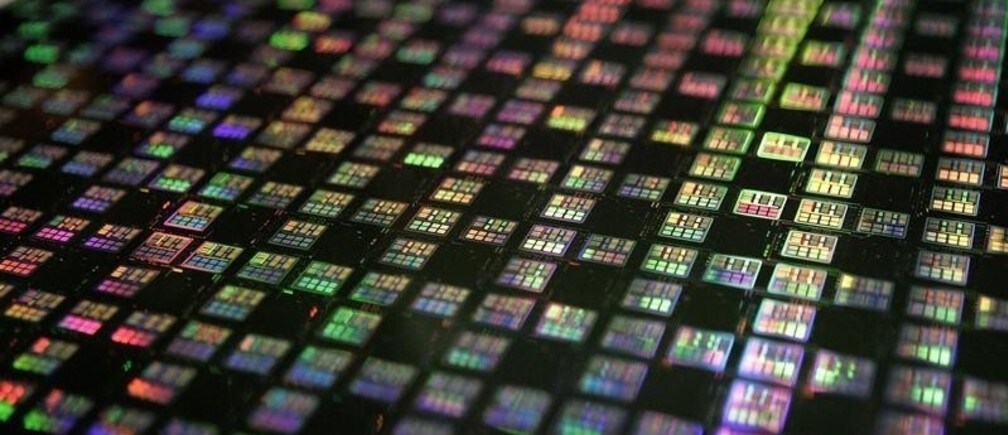
Imagen: Se muestra una oblea de 12 pulgadas en Taiwan Semiconductor Manufacturing Company (TSMC), en Xinchu, el 9 de enero de 2007. REUTERS/Richard Chung.


