Money2020, la mayor feria financiera del mundo, se celebra cada año en el hotel Venetian de Las Vegas. En un encuentro reciente, por encima del estruendo de las máquinas tragamonedas del casino situado abajo, las empresas emergentes de criptomonedas presentaban sus últimas ofertas de monedas, mientras que, en el escenario principal, Dan Schulman, presidente y director ejecutivo de PayPal, pronunció un apasionado discurso ante miles de personas sobre los trabajadores pobres del mundo y su necesidad de acceder a servicios bancarios y crédito. Según PayPal y muchas otras empresas, el futuro está en la calificación crediticia algorítmica, en la que los datos de pagos y redes sociales, combinados con el aprendizaje automático, permitirán tomar decisiones de préstamo que, según sostiene otro entusiasta, «son mejores para elegir a las personas de lo que las personas jamás podrían ser».
En China, el crédito está ahora en manos de una empresa llamada Alipay, que utiliza miles de datos de los consumidores —incluidos qué compran, qué tipo de teléfono usan, a qué juegos de realidad aumentada juegan y quiénes son sus amigos en las redes sociales— para determinar su puntuación crediticia. En una cultura en la que las personas mayores sacan el teléfono con naturalidad para pagar la compra e incluso las personas sin hogar llevan códigos QR para aceptar donaciones, hay muchos datos disponibles. Y, aunque la puntuación crediticia puede determinar las condiciones de un préstamo, también sirve como indicador del buen carácter en general. En China, una calificación crediticia alta puede mejorar tus posibilidades de conseguir empleo, por ejemplo, o de obtener un visado para viajar por Europa, e incluso de encontrar pareja a través de citas en línea. Un sitio chino de citas, Baihe.com, ofrece mayor visibilidad a los usuarios con puntuaciones crediticias altas.
Y todo ello lo determina el algoritmo.
En China, una calificación crediticia alta puede mejorar tus posibilidades de conseguir empleo, por ejemplo, o de obtener un visado para viajar. Se dice que las decisiones de las aplicaciones de calificación crediticia algorítmica predicen el riesgo con mayor precisión que los métodos tradicionales de calificación; sus defensores sostienen que también son más justas, porque el algoritmo no se deja influir por los sesgos raciales, de género y socioeconómicos que en el pasado han limitado el acceso al crédito. Puede que no esté claro por qué jugar a videojuegos, tener un teléfono Android y contar con 400 amigos en Facebook puede ayudar a determinar si se aprueba una solicitud de préstamo, pero, según esta lógica, una década después de la crisis financiera debemos confiar en que los números no mienten.
Alipay no es la única. Además de competidores chinos como WePay, otras empresas utilizan el aprendizaje automático para tomar decisiones de préstamo en el África subsahariana. Una de ellas, llamada Branch, aprovecha la adopción de los teléfonos móviles en Kenia y extrae datos de la popularísima plataforma de pagos móviles M-Pesa para elaborar puntuaciones crediticias. Y, por supuesto, la calificación crediticia algorítmica no se limita a los mercados de crédito emergentes. En Alemania, Kreditech, un servicio de préstamos decidido a crear el «Amazon de las finanzas para el consumidor», se está alejando de indicadores tradicionales como el historial de pagos para extraer pistas sobre la personalidad ocultas en los datos de Facebook que ceden sus clientes. Mientras tanto, la empresa estadounidense ZestFinance utiliza macrodatos para dirigirse a clientes cuyas calificaciones, según se afirma, nunca se recuperaron de la crisis de las hipotecas de alto riesgo.
La calificación crediticia algorítmica se alimenta del deseo de sacar partido de las personas del mundo que no tienen acceso a servicios bancarios. Como sugiere el discurso de Schulman en Money2020, la calificación crediticia algorítmica se alimenta del deseo de sacar partido de esas personas, incorporando a miles de millones de clientes que hasta ahora han quedado excluidos por carecer de un historial financiero tradicional. Pero el auge del crédito algorítmico también responde a las inquietudes de las economías desarrolladas, especialmente tras la crisis financiera. Una década después del desplome, se percibe cierta esperanza de que los macrodatos puedan por fin afianzar el arriesgado negocio del crédito al consumo en todas partes. Sigue siendo una pregunta abierta si deberíamos confiar en esa promesa, y resulta difícil responderla dada la opacidad del aprendizaje automático.
En 2002, J.P. Martin, ejecutivo de Canadian Tire, comenzó a analizar los datos de transacciones del año anterior. La empresa vendía artículos deportivos y de ocio, productos para el hogar y suministros para automóviles, y emitía una tarjeta de crédito ampliamente aceptada. Al examinar los historiales de transacciones, Martin identificó correlaciones entre las compras de los clientes y la probabilidad de que incumplieran sus pagos. Las compras responsables y con orientación social, como las semillas para pájaros o las herramientas para quitar la nieve de los tejados, se correlacionaban con la solvencia futura, mientras que las marcas baratas de aceite de motor indicaban una mayor probabilidad de impago.
Algunas empresas reducían el crédito de sus clientes si aparecían cargos por terapia, porque la depresión y los problemas matrimoniales eran indicios de una posible pérdida del empleo. Poco después, algunas compañías de tarjetas de crédito empezaron a utilizar estos y otros hallazgos para examinar a sus clientes. En Estados Unidos, cada transacción procesada por Visa o MasterCard lleva un código de «categoría de comercio»: por ejemplo, 5122 para medicamentos; 7277 para asesoramiento sobre deudas, matrimonio o asuntos personales; 7995 para apuestas y juegos de azar; o 7273 para citas y servicios de acompañantes. Algunas empresas reducían el crédito de sus clientes si aparecían cargos por terapia, porque la depresión y los problemas matrimoniales eran indicios de una posible pérdida del empleo o de litigios costosos.
Aunque estos cálculos se basaban en historiales de transacciones, los algoritmos de calificación crediticia procesan conjuntos de datos con miles de variables agregadas a partir de historiales de pagos, redes sociales, datos demográficos e incluso datos GPS. La patente de ZestFinance describe el uso de datos de pagos, comportamiento social, hábitos de navegación y detalles de las redes sociales de los usuarios, así como de «cualquier información del grafo social relativa a cualquiera o a todos los miembros de la red del prestatario». Del mismo modo, la política de privacidad de Branch menciona factores como datos personales, registros de mensajes de texto, datos de redes sociales, datos financieros y detalles del teléfono, incluidos la marca, el modelo y el tipo de navegador. Estas aplicaciones no se limitan a utilizar esos datos agregados para tomar una decisión: crean sistemas que analizan y refinan recursivamente sus resultados conforme a un objetivo, lo que permite que el algoritmo «aprenda» estableciendo sus propias conexiones. Como sostuvo hace poco el director ejecutivo de ZestFinance, «todos los datos son datos crediticios», y los mecanismos del algoritmo ya no son tan simples como rastrillo para nieve = bueno; terapia matrimonial = malo.
La caja negra del algoritmo implica que nadie sabe realmente qué datos —o qué combinaciones de datos— resultarán significativos. Aunque las empresas suelen ser transparentes sobre los datos que introducen para perfeccionar y mejorar los procesos de toma de decisiones, la caja negra del algoritmo implica que nadie sabe realmente qué datos —o qué combinaciones de datos— resultarán significativos. Por ejemplo, tras un poco de prueba y error, Joe Deville, investigador de la Universidad de Lancaster, en el Reino Unido, descubrió que cambiar simplemente la resolución de pantalla de su teléfono parecía dar lugar a una puntuación diferente en algunos prestamistas algorítmicos; otras personas han sugerido que acciones tan misteriosas como cargar el teléfono con más frecuencia podrían producir un resultado más favorable. Mientras tanto, el director ejecutivo de Branch habla con humor de su algoritmo de aprendizaje automático como un «robot en el cielo»: una especie de hada de la IA que decide si presta dinero según si sus usuarios se portan bien o mal. Si no estás conforme con el número que sale de la caja negra, poco puedes hacer para cambiarlo o impugnarlo.
Las puntuaciones crediticias algorítmicas pueden parecer futuristas, pero estas prácticas tienen sus raíces en métodos de calificación crediticia de antaño. Por ejemplo, las primeras agencias de crédito contrataban investigadores humanos para indagar en los historiales crediticios de sus clientes. Los informes se recopilaban en gran medida a partir de chismes locales y estaban teñidos por las conjeturas de investigadores que, en su mayoría, pertenecían a la clase media blanca y masculina. Abundaban los comentarios sobre raza y clase social, las observaciones sobre las tareas domésticas y las especulaciones sobre la orientación sexual. Un investigador de crédito de Buffalo, Nueva York, señaló que «se debe actuar con prudencia en las grandes transacciones con todos los judíos», mientras que un investigador de Georgia describió una licorería que estaba analizando como «una tienda de negros de baja categoría». Del mismo modo, Retailer Credit Company, fundada en 1899 y actualmente conocida como Equifax, utilizó la información recopilada por representantes de Welcome Wagon para reunir expedientes sobre millones de estadounidenses durante los 60 años siguientes.
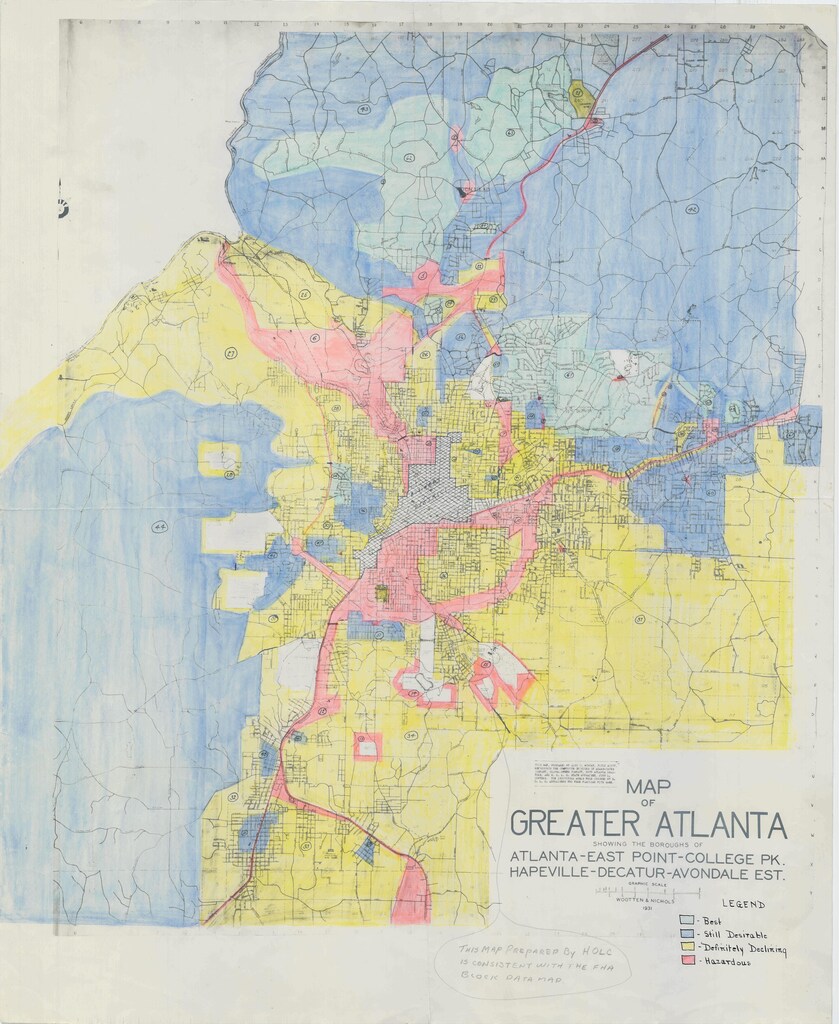
En 1935, barrios enteros de Estados Unidos se clasificaban según sus características crediticias. Un mapa de ese año del área metropolitana de Atlanta está codificado por colores en tonos azules (deseables), amarillos (en franco declive) y rojos (peligrosos). La leyenda evoca una época en la que las posibilidades de una persona de obtener una hipoteca dependían de su ubicación geográfica. Los barrios con una calificación peligrosa solían ser pobres o estar habitados mayoritariamente por minorías raciales y étnicas. Esta práctica de calificación, conocida hoy como «redlining», servía para reducir la movilidad e impedir que las familias afroamericanas se mudaran a barrios dominados por personas blancas.
La Ley de Información Crediticia Justa de 1970 y la Ley de Igualdad de Oportunidades de Crédito de 1974 fueron intentos de corregir estas prácticas discriminatorias. Hoy, según el relato de las empresas de tecnología financiera, contamos con algoritmos de calificación detallados e imparciales que, en apariencia, no tienen en cuenta el género, la clase social ni la etnia al buscar a personas solventes. Y, sin embargo, los crecientes estudios sobre cómo los algoritmos clasifican y toman decisiones reflejan estas geografías históricas de exclusión. Esto ha llevado a académicos como Cathy O’Neill y Frank Pasquale, que estudian los efectos sociales, económicos y políticos de la toma de decisiones algorítmica, a señalar la aparición de prácticas de «weblining», en las que las puntuaciones algorítmicas reproducen las viejas castas crediticias y desigualdades. Como estos sistemas aprenden de conjuntos de datos existentes, a menudo los sesgos existentes determinan lo que la máquina considera bueno, malo, normal o solvente.
Los crecientes estudios sobre cómo los algoritmos clasifican y toman decisiones reflejan las geografías históricas de exclusión. Estos sistemas se están convirtiendo rápidamente en la norma. El Gobierno chino está a punto de lanzar su propio «Sistema de Crédito Social» algorítmico para sus 1.400 millones de ciudadanos, una métrica que utiliza datos en línea para evaluar la fiabilidad. A medida que estos sistemas se generalicen y las puntuaciones pasen a representar el valor de cada persona, determinando el acceso a las finanzas, los servicios y las libertades básicas, las consecuencias de una mala decisión serán mucho mayores. Y eso sin siquiera abordar la legitimidad de utilizar esos indicadores algorítmicos en primer lugar.
Aunque pueda parecer obvio pedir más transparencia en estos sistemas, localizar los sesgos resulta extremadamente difícil cuando se trata de aprendizaje automático y conjuntos de datos enormes. Incluso si pudiéramos asomarnos a la caja negra, probablemente no encontraríamos una cláusula en el código que ordenara al sistema discriminar a las personas pobres, a las personas de color o incluso a quienes juegan demasiado a los videojuegos. Más importante que entender cómo se calculan estas puntuaciones es ofrecer a los usuarios oportunidades reales de impugnar y cuestionar las decisiones desfavorables que el algoritmo toma sobre ellos.
Quizá entonces podamos comprobar de verdad si estos sistemas conceden crédito a quienes lo merecen.




