La previsión estadística del riesgo impulsa cada vez más las decisiones de las instituciones financieras y los reguladores financieros (Comité de Basilea 2013, 2014). A pesar de ello, las propiedades estadísticas de los mecanismos subyacentes en condiciones operativas habituales se comprenden poco.
Ampliar nuestra comprensión de esta cuestión motiva nuestro trabajo en Danielsson y Zhou (2015). Nos centramos en tres preguntas clave:
La comparación entre el valor en riesgo y el déficit esperado (véase, por ejemplo, Danielsson 2011);
El impacto de utilizar rendimientos superpuestos a largo plazo en la estimación, frente a escalar los rendimientos en el tiempo para horizontes de liquidez más prolongados; y
El desempeño de la previsión del riesgo con tamaños de muestra habituales.
La teoría del valor en riesgo frente al déficit esperado
La opinión general sostiene que el déficit esperado es superior al valor en riesgo como medida del riesgo. Ciertamente, los argumentos teóricos apuntan en esa dirección. El déficit esperado capta toda la cola, es subaditivo y es más difícil de manipular. Sin embargo, ¿se extienden también estas ventajas a los usos prácticos?
Desde un punto de vista puramente estadístico, nuestra respuesta es no. En teoría, el déficit esperado está directamente relacionado con el valor en riesgo por una constante pequeña, generalmente entre 1 y 1,5; por tanto, el valor en riesgo es tan subaditivo como el déficit esperado salvo en casos extremos. Por ejemplo, en el caso de la distribución t(3) de Student, cuyas colas son similares a las de muchos rendimientos de acciones, el déficit esperado al 99 % es aproximadamente un 50 % mayor que el valor en riesgo al 99 %. En teoría, en la mayoría de los casos el déficit esperado no dice nada más sobre las colas que el valor en riesgo.
En qué supera el déficit esperado al valor en riesgo
Aunque desde un punto de vista puramente estadístico parece haber pocos motivos para preferir el déficit esperado al valor en riesgo, el déficit esperado tiene otras ventajas como medida de control. En concreto, es más difícil de manipular.
Una institución financiera puede manipular una medida de riesgo eligiendo un método de estimación concreto. Sin embargo, no hay garantía de que un método de estimación que hoy arroje un resultado favorable para la institución financiera vaya a hacerlo mañana.
En cambio, es más probable que la manipulación consista en realizar operaciones que parezcan cumplir las reglas, pero que presenten características de riesgo indeseables y difíciles de detectar. Un ejemplo típico es invertir en activos cuyo riesgo está subestimado, como los créditos estructurados con calificaciones AAA. En términos más generales, es probable que la manipulación se produzca mediante la selección interesada de activos que generan grandes pérdidas si se supera el límite del valor en riesgo, o mediante la optimización de la cartera de una forma que minimice el valor en riesgo declarado. Esto puede ser prácticamente indetectable.
Es más difícil manipular el déficit esperado de esta manera. El valor en riesgo solo considera el punto de la cola por encima del cual se producen grandes pérdidas, e ignora la magnitud de esas pérdidas. En cambio, el déficit esperado se basa en la magnitud de todas las grandes pérdidas.
Precisión de la estimación del déficit esperado y del valor en riesgo con tamaños de muestra habituales
Buena parte de los análisis existentes sobre las medidas de riesgo se centra en sus propiedades asintóticas. Aunque sin duda esto aporta información, sospechamos que tanto los usuarios finales del sector privado como los reguladores están aún más interesados en el desempeño de las medidas de riesgo con tamaños de muestra habituales. Estos abarcan quizá de uno a cinco años de datos diarios, debido a nuevos instrumentos, rupturas estructurales, innovaciones financieras u otros cambios que reducen la pertinencia de los datos antiguos.
Investigamos las propiedades del valor en riesgo y del déficit esperado con tamaños de muestra que van de 100 días a 20 años. La Figura 1 muestra resultados representativos: la precisión de la estimación del valor en riesgo para la distribución t(3) de Student, junto con su intervalo de confianza empírico del 99 %.1
Figura 1. Valor en riesgo (VaR) y su intervalo de confianza del 99 % en función del tamaño de la muestra

Los resultados son bastante sorprendentes. Para una estimación con alrededor de 1 año de datos diarios, habitual en la práctica, el intervalo de confianza que obtenemos va de 64 a 216 para una distribución cuyo riesgo real es 100. Incluso con un tamaño de muestra habitual de 4 años, el intervalo de confianza va de 76 a 143. Los resultados correspondientes para el déficit esperado son peores, con intervalos de confianza de [48, 272] y [65,187], respectivamente.2
Un aspecto clave es que las dos medidas de riesgo se comportan de manera diferente con muestras más pequeñas. Por ejemplo, cuando disminuye el tamaño de la muestra, también se reduce la diferencia entre el déficit esperado y el valor en riesgo, hasta el punto de que el valor en riesgo al 99 % acaba incluso superando el déficit esperado al 97,5 %, como se observa en la siguiente Figura 2.
Figura 2. Valor en riesgo y déficit esperado a medida que aumenta el tamaño de la muestra
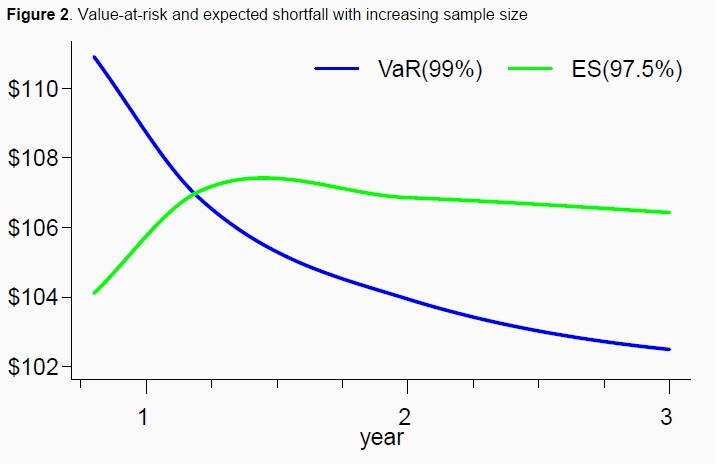
Observamos que, en la mayoría de los casos, el déficit esperado se estima con mayor incertidumbre que el valor en riesgo. Esto implica que, desde un punto de vista puramente estadístico, el valor en riesgo es superior al déficit esperado.
Sumado al hecho de que el valor en riesgo es tan subaditivo como el déficit esperado salvo en casos extremos, parece haber pocos motivos para elegir el déficit esperado en lugar del valor en riesgo si lo que se busca es precisión estadística y captar los eventos de cola.
La importancia de los intervalos de confianza
Aunque la práctica estadística habitual consiste en informar tanto de las estimaciones puntuales como de los intervalos de confianza, por alguna razón no es así en la mayoría de las previsiones de riesgo. Ciertamente, las normas sobre la cartera de negociación de los acuerdos de Basilea nunca han hecho hincapié en este tipo de medidas de precisión.
Nuestros resultados indican que esta práctica no es recomendable. Los errores estándar pueden arrojar una respuesta muy engañosa debido a la asimetría de la incertidumbre, mientras que los intervalos de confianza construidos correctamente pueden proporcionar información de vital importancia a los usuarios finales. La cuestión es que estos modelos estadísticos son un insumo clave para decisiones que a menudo son muy costosas, y en las que tanto los errores de tipo II como los de tipo I pueden ser muy importantes para quienes toman las decisiones. A nuestro juicio, el Comité de Basilea debería seguir la práctica estadística habitual y exigir el cálculo y la presentación de intervalos de confianza construidos correctamente.
Escalado temporal o datos superpuestos
El tercer conjunto de cuestiones que examinamos surge al estimar el riesgo para horizontes de liquidez más prolongados. A menudo se recurre a uno de dos métodos populares: utilizar rendimientos superpuestos a largo plazo en la estimación o escalar el riesgo diario a periodos de tenencia de varios días. Nuestra observación puramente anecdótica de los profesionales sugiere que cada vez se prefiere más el enfoque de superposición al método de escalado.
El enfoque de superposición crea una dependencia artificial en los datos porque se repiten los eventos diarios. Comparamos la robustez del enfoque de superposición con la del escalado de la estimación del riesgo por la raíz cuadrada del periodo de tenencia y observamos que, en la práctica, el enfoque de la raíz cuadrada del tiempo es más preciso que el enfoque de datos superpuestos bajo diversos procesos generadores de datos. Por tanto, recomendaríamos utilizar el enfoque de escalado temporal en lugar del de datos superpuestos.
Pertinencia para Basilea III
En las propuestas más recientes de Basilea III sobre riesgo de mercado, una de las sugerencias para calcular los requerimientos de capital es sustituir el valor en riesgo al 99 % por el déficit esperado al 97,5 %.
En la práctica, el valor en riesgo es más preciso que el déficit esperado en la mayoría de los casos. Además, dado que Basilea III recomienda calcular el déficit esperado con un año de datos, el valor en riesgo al 99 % podría incluso ser superior al déficit esperado al 97,5 %. Por ello, es probable que el paso al déficit esperado al 97,5 % dé lugar a previsiones del riesgo de mercado que sean tanto más bajas como menos precisas.
Dado que el déficit esperado es solo un múltiplo pequeño del valor en riesgo, sería preferible utilizar el valor en riesgo y escalarlo según sea necesario, en lugar de pasar al déficit esperado al 97,5 %, si el objetivo de la medida de riesgo es captar las colas con precisión, que es la única motivación indicada en las propuestas de Basilea III.
Este análisis no permite concluir si el capital será menor o mayor con el valor en riesgo de Basilea II o con el déficit esperado de Basilea III. El motivo es que estimar las medidas de riesgo es solo el primer paso para calcular los requerimientos de capital.
Para aliviar algunas de estas preocupaciones, el Comité de Basilea prevé que la medida de riesgo estimada se calibre con respecto a un periodo histórico de tensión, lo que da lugar al llamado déficit esperado en tensión. Por construcción, debería ser igual o superior a la estimación del déficit esperado ordinario. El límite inferior del intervalo de confianza de la medida de riesgo en tensión aumentará en consecuencia. Esto alivia parcialmente la preocupación que plantea nuestro estudio: que el límite inferior del déficit esperado puede ser desconcertantemente bajo. No obstante, el problema fundamental de la gran incertidumbre de estimación sigue sin resolverse después de dicha calibración.
Conclusión
En conjunto, nuestros resultados indican que, en la práctica, el valor en riesgo produce previsiones del riesgo sustancialmente más precisas que el déficit esperado.3 La única razón para elegir el déficit esperado en lugar del valor en riesgo en la mayoría de los casos es que el primero es más difícil de manipular. También observamos que, en las aplicaciones que implican horizontes de liquidez más prolongados, el enfoque de datos superpuestos produce previsiones del riesgo menos precisas que el enfoque de la raíz cuadrada del tiempo.
Además, establecemos que la imprecisión de las previsiones de riesgo con los tamaños de muestra pequeños que probablemente se encuentren en la práctica hace que las estimaciones centrales del valor en riesgo y del déficit esperado sean muy inciertas. Esto debería preocupar especialmente a los usuarios finales a quienes les preocupan los errores de tipo II.
Nos preocupa que regulaciones importantes de política pública, como los cálculos del capital bancario, se basen en cifras que, en la práctica, podrían ser casi el doble o la mitad de la cifra registrada, simplemente por una extracción aleatoria.
Nuestra conclusión final es que informar de los intervalos de confianza debería ser una práctica habitual.
Descargo de responsabilidad: Las opiniones expresadas no reflejan necesariamente las opiniones de DNB ni de la Eurozona.
Referencias
Comité de Supervisión Bancaria de Basilea (2013), “Revisión fundamental de la cartera de negociación: un marco revisado para el riesgo de mercado”.
Comité de Supervisión Bancaria de Basilea (2014), “Revisión fundamental de la cartera de negociación: cuestiones pendientes”.
Danielsson, J (2011), Previsión del riesgo financiero, Wiley.
Danielsson, J (2013), “La nueva regulación del riesgo de mercado”, VoxEU.org, 28 de noviembre.
Danielsson J y C Zhou (2015), “¿Por qué es tan difícil medir el riesgo?”, documento de trabajo, London School of Economics.
Notas al pie
1 Los resultados completos pueden consultarse en el apéndice web.
2 A medida que disminuye el tamaño de la muestra, la incertidumbre de las previsiones de riesgo aumenta exponencialmente; con los tamaños de muestra más pequeños que se encuentran en la práctica, la estimación del riesgo es casi indistinguible del ruido aleatorio.
3 Los resultados completos se resumen en nuestro apéndice web.
Este artículo se publica en colaboración con VoxEU. Su publicación no implica que el Foro Económico Mundial respalde las opiniones expresadas.
Para mantenerse al día con Foro:Agenda, suscríbase a nuestro boletín semanal.
Autor: Jon Danielsson es director del Systemic Risk Centre, financiado por el ESRC, de la London School of Economics. Chen Zhou es investigador en la División de Economía e Investigación. También es profesor adjunto en la Universidad Erasmus de Róterdam.
Imagen: Delegados cruzan la calle tras una sesión plenaria de la Asamblea Popular Nacional en el Gran Palacio del Pueblo, en Pekín. REUTERS/Claro Cortes IV.